-
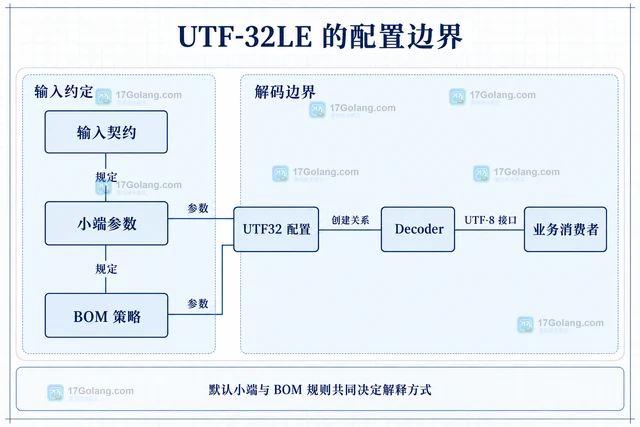
Go 用 UTF32 配置小端解码器,再通过 transform.NewReader 转成 UTF-8。本文说明 IgnoreBOM、UseBOM、ExpectBOM 的区别,以及流式处理中的资源归属和部分输出。
-
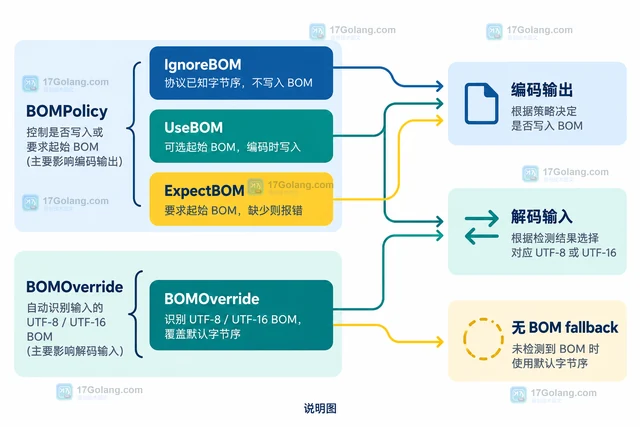
介绍 Go x/text/encoding/unicode 中 UTF16 的字节序与 BOMPolicy 配置,说明 IgnoreBOM、UseBOM、ExpectBOM 和 BOMOverride 在读写 UTF-16 时的区别与选择方法。
-
Go 使用 golang.org/x/text/encoding/simplifiedchinese 处理 GB18030 四字节字符,关键是用 GB18030 的 Decoder 与 Encoder 在 UTF-8 和旧编码字节之间转换,并区分解码替换字符与编码不可表示错误。
-
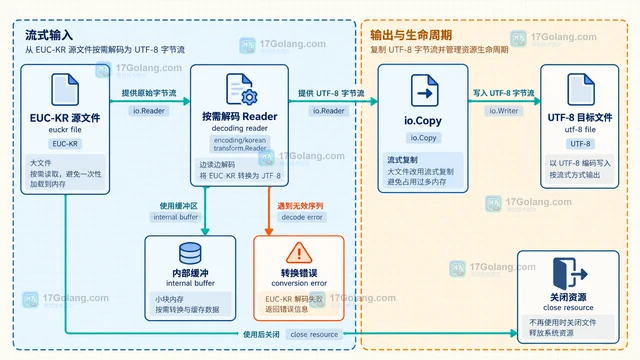
读取 EUC-KR 或 CP949 保存的旧韩文文本时,不能直接把原始字节转换成 UTF-8 字符串。本文用 golang.org/x/text/encoding/korean 的 EUCKR 解码器接入 transform.Reader,给出整文件读取、流式复制、错误处理和内存取舍。
-
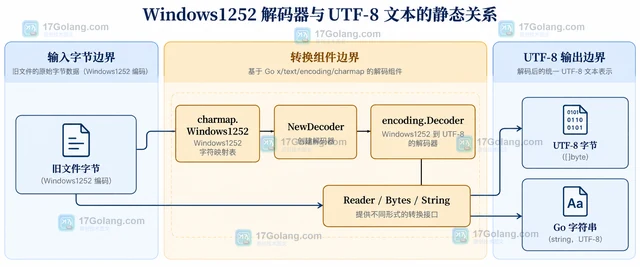
Windows-1252 旧文件不能直接当作 UTF-8 读取。本文用 golang.org/x/text/encoding/charmap 的 Decoder 说明内存转换、流式读取和写回旧编码时的字符边界。
-
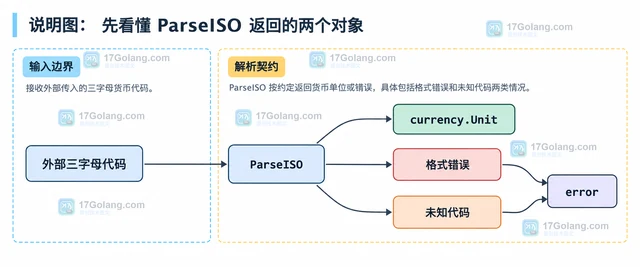
Go x/text/currency 的 ParseISO 用于解析三字母 ISO 4217 货币代码。本文说明如何处理格式或未知代码错误,并区分 Unit、Amount、Formatter 与 MustParseISO 的职责边界。
-
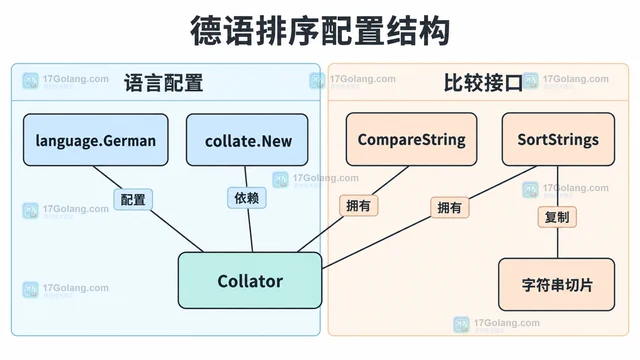
Go 用 collate.New(language.German) 创建德语文本排序器。通过完整示例说明语言标签、稳定排序与原切片保护,并解释比较等价、并发独占和配置记录的使用边界。
-
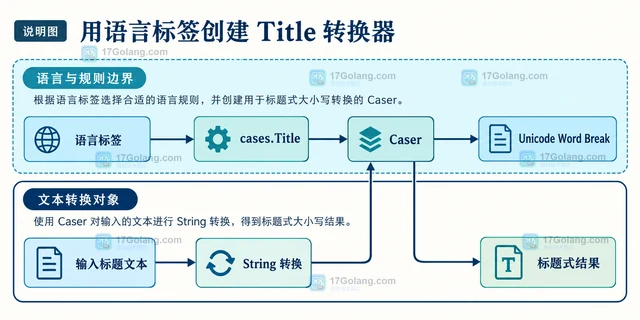
Go x/text/cases 的 Title 可以结合语言标签生成标题式大小写。本文用普通标题、NoLower、String/Bytes/Transform 和 Caser 并发边界说明怎样选参数与避免误用。
-
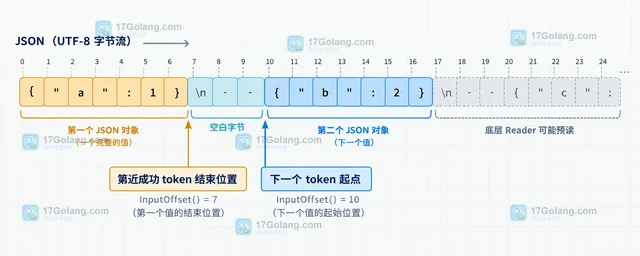
Go json.Decoder.InputOffset 返回的是最近成功返回 token 之后的输入字节偏移。本文用连续 JSON 流示例说明它与 SyntaxError.Offset、Buffered 的区别,并演示如何把字节位置转换为行列诊断信息。
-
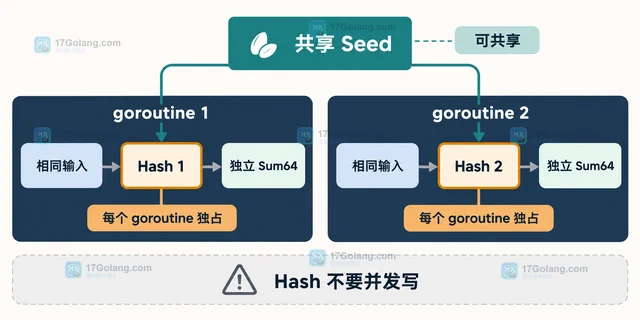
Go hash/maphash 的 Seed 决定 Hash 使用的哈希函数。本文说明怎样用 SetSeed 让多个 Hash 实例使用同一个进程内 Seed,如何用于并发计算,以及调用时会清空已有输入的边界。
-
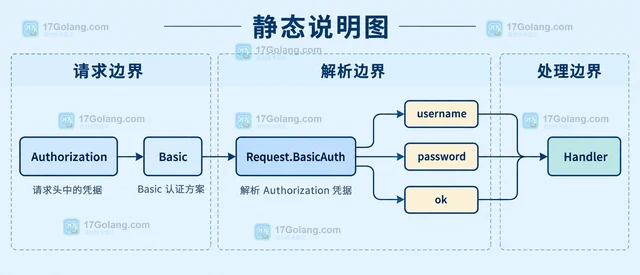
本文说明 Go http.Request.BasicAuth 的三个返回值,演示如何区分认证头解析成功与账号校验通过,并整理 401、HTTPS、WWW-Authenticate 和日志脱敏边界。
-
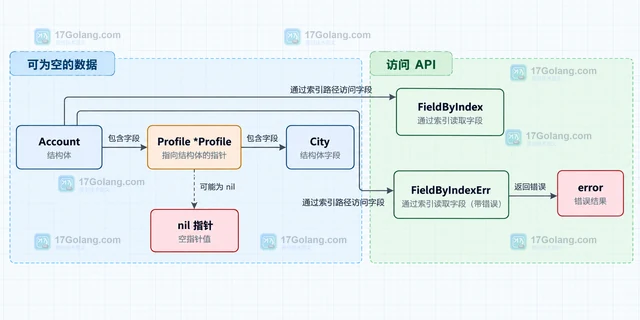
Go reflect.Value.FieldByIndex 接收 StructField.Index 这样的字段路径,可读取嵌套或匿名嵌入结构体中的目标字段;遇到可能为空的指针时,应使用 FieldByIndexErr 获取可处理的错误。
-
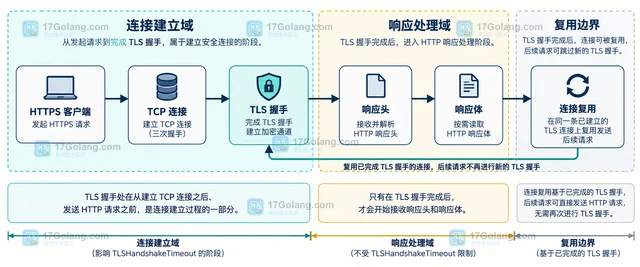
Go 的 TLSHandshakeTimeout 只负责 HTTPS 客户端 TLS 握手阶段的等待时间。本文用一个自定义 Transport 拆开连接、握手、响应头和响应体的超时边界,并说明如何根据错误现象选择排查方向。
-
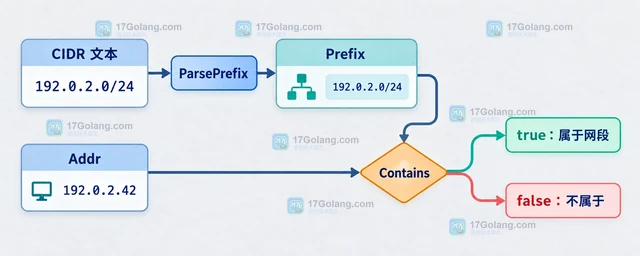
Go 标准库 net/netip 可以先用 ParsePrefix 解析 CIDR,再调用 Prefix.Contains 判断 IP 是否属于指定网段。本文给出 IPv4、IPv6、地址族不匹配、IPv6 zone 和前缀规范化的实用边界。
-
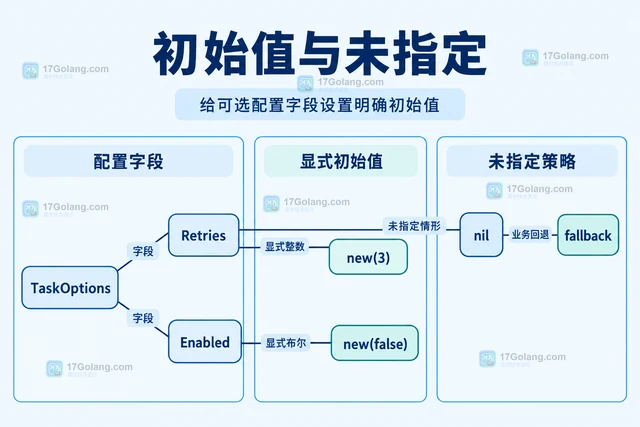
Go 1.26 支持用 new(表达式) 创建带初始值的指针。以重试配置为例,讲清语言版本、默认类型、nil 与零值,以及 new(变量) 和取地址的区别。
