-
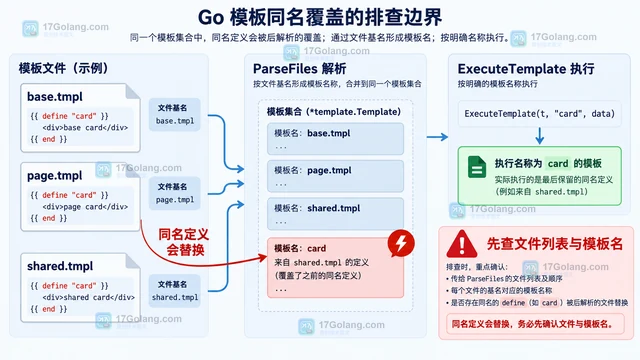
Go text/template 遇到嵌套 define 同名覆盖时,按关联模板、Parse 顺序、文件基名和 ExecuteTemplate 入口逐项定位,避免执行到错误定义。
-
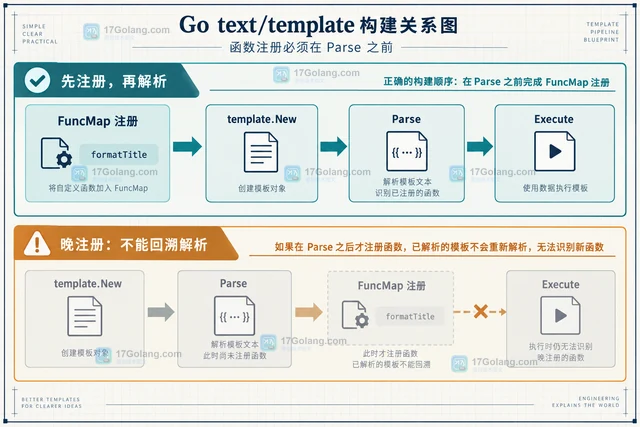
Go 的 text/template 报 function not defined 时,优先检查 FuncMap 是否在 Parse 前注册。本文用最小示例说明正确注册链、集中构造方式,以及解析后替换函数的边界。
-
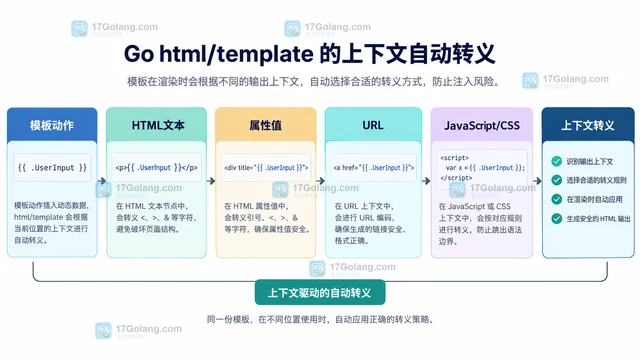
html/template 并不是简单地把所有字符串统一转义,而是根据插值所在的 HTML、属性、URL、JavaScript 或 CSS 上下文选择处理方式。本文用最小示例排查转义异常、ZgotmplZ 和安全类型误用。
-
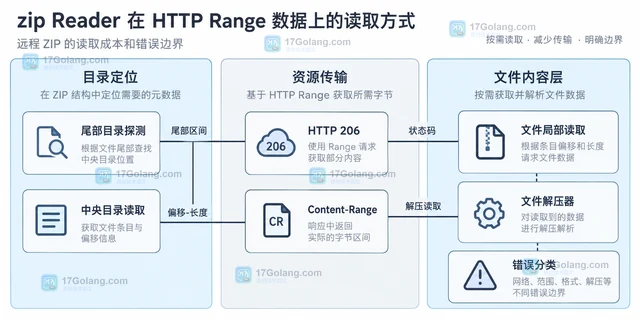
zip.NewReader 需要 io.ReaderAt 和压缩包总大小,HTTP 响应体却通常只能顺序读取。本文用 RangeReaderAt 把 HTTP Range 适配成随机读取,并说明 206、Content-Range、目录定位和错误边界。
-
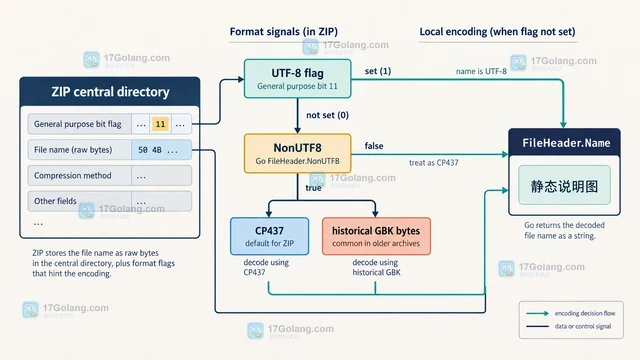
Go 使用 archive/zip 读取中文文件名异常时,先区分 UTF-8、CP437 和历史本地编码,再用显式解码与路径安全策略处理,避免把乱码或不可信路径直接落盘。
-
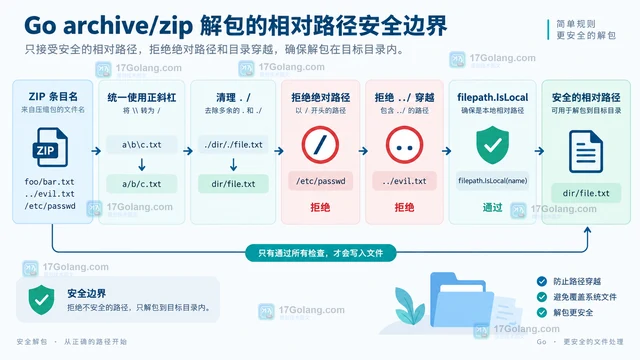
Go 使用 archive/zip 解包时,不能把 ZIP 条目名直接拼到目标目录。本文用相对路径校验、安全根目录映射和先校验后写盘的代码,处理绝对路径、../、反斜杠及 ErrInsecurePath,并说明符号链接和共享目录的额外边界。
-
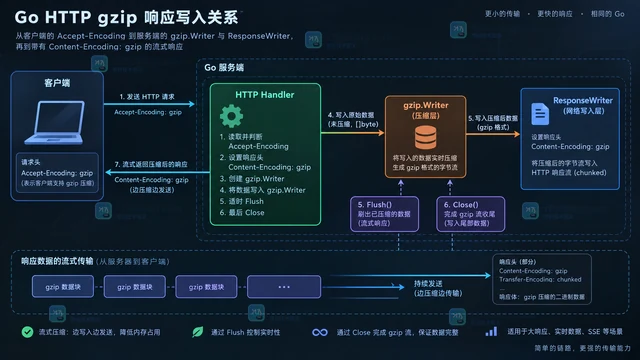
Go 的 gzip 压缩级别是在 CPU 消耗、响应体大小和端到端延迟之间做取舍。本文用 NewWriterLevel 比较级别,并给出 HTTP Handler 中的配置、Close、Flush 与 Writer 复用注意事项。
-
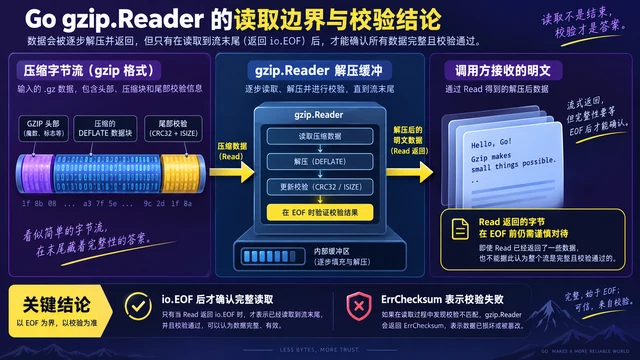
复用 gzip.Reader 时看到旧数据,通常不是 Reset 失效,而是把 Reader 内部状态、输入源位置和调用方输出缓冲混在了一起。本文用 Reset、EOF、ErrChecksum 与 Multistream 说明正确的复用边界。
-
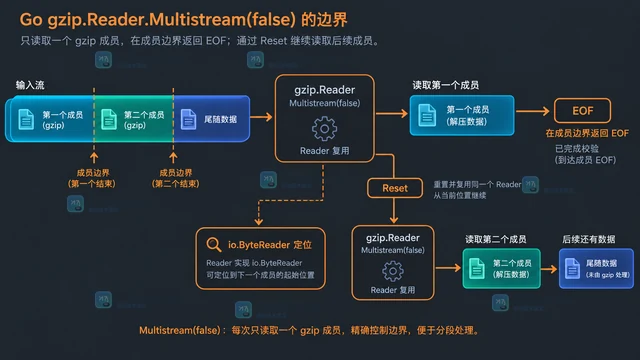
Go 的 gzip.Reader 默认会连续读取拼接的 gzip 成员。本文用原创示例拆开 Multistream、Reset、io.ByteReader、EOF 与尾随数据的边界,帮助你选择整体解压或按成员处理。
-
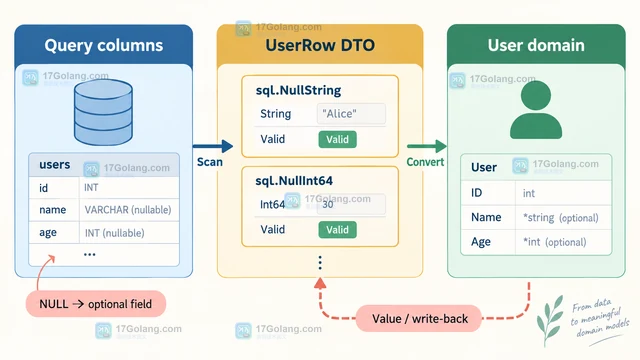
database/sql 扫描 SQL NULL 时,普通 string、int 字段无法表达空值语义。本文从扫描失败现场入手,分别使用 sql.Null* 与 Go 1.22 的 sql.Null[T],再把数据库 DTO 转换为业务结构体,给出单行、批量查询和写回数据库的稳定做法。
-
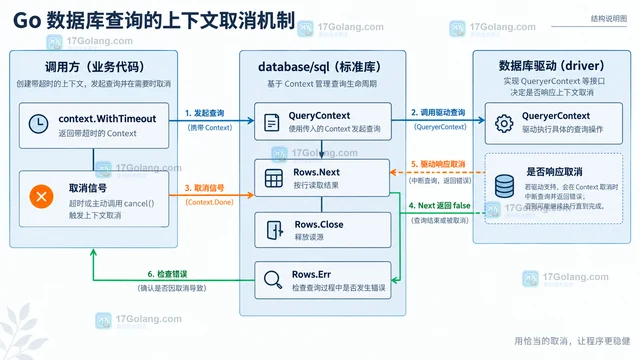
database/sql 查询过程中上下文被取消时,Rows.Next 可能只是返回 false,真正的取消或驱动错误要在 Rows.Err 中读取。本文给出稳定的读取模板,并说明 Close 与驱动取消支持的边界。
-
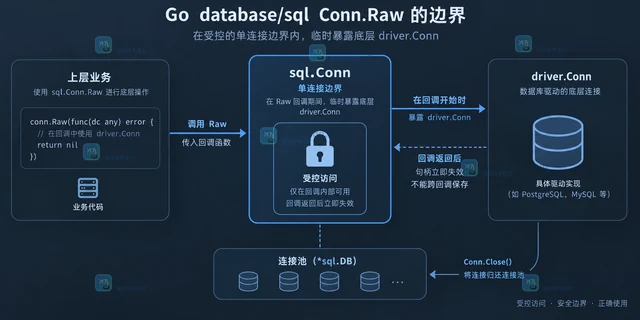
Go 的 database/sql Conn.Raw 适合短暂访问驱动特有能力,但底层 driver.Conn 只能在回调期间使用。本文用一个连接池场景说明借用、错误传播、归还和并发边界。
-
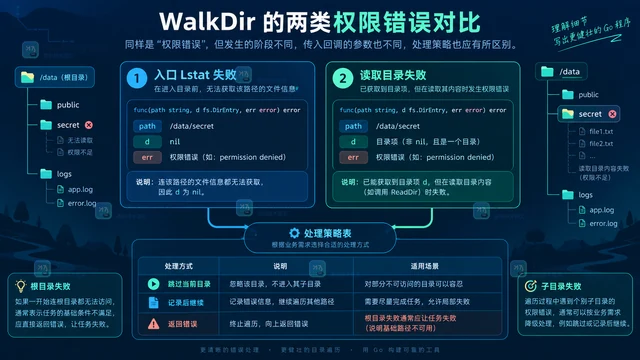
filepath.WalkDir 遇到权限目录时,错误会通过回调参数传入,而不是自动跳过。本文区分入口访问失败与子目录读取失败,说明 d 和 err 的判断方式,以及 return nil、filepath.SkipDir 和原样返回错误的取舍。
-
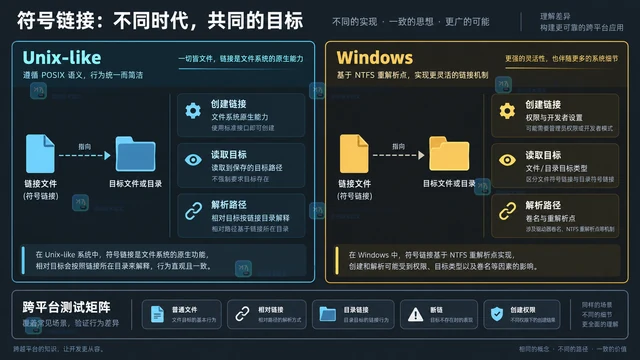
Go 中 os.Open 和 os.Stat 通常会跟随符号链接,os.Lstat 与 os.Readlink 则用于观察链接本身;Windows 还会受到链接权限、目标类型和卷路径处理影响。本文用一组小代码梳理不同打开方式,并给出跨平台读取与测试建议。
-
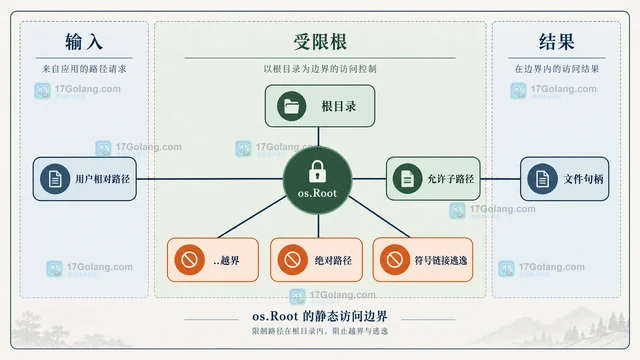
使用 os.Root 后仍遇到路径校验失败,通常是把根目录再次拼入参数,或混淆了 io/fs 路径与本地路径。本文结合 IsLocal、Localize 和 Root.Open 梳理可直接落地的相对路径规则与排错方法。
