
linux技术文章
-
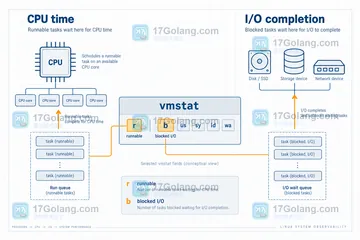 Linux vmstat 的 r 列长期升高,通常表示可运行任务在等待 CPU 时间,但不能只看一个数字下结论。本文区分 r、b、load average 与 D 状态,并给出从 CPU 核心到进程亲和性和 cgroup 配额的排查方法。215 收藏
-
文章 · linux | 1天前 | linux运维 · systemd服务 · 故障重启 · 服务限流 · Linux systemd StartLimitBurst StartLimitIntervalSec Restart
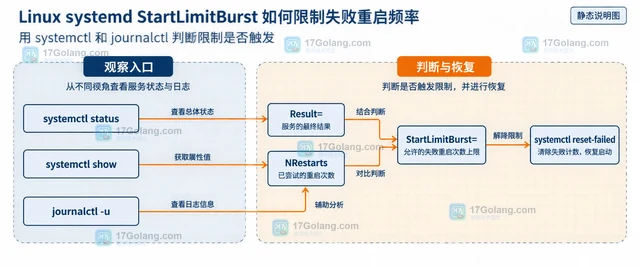 systemd 的 StartLimitBurst 负责限制一个 unit 在 StartLimitIntervalSec 时间窗口内的启动次数,常与 Restart= 和 RestartSec= 配合使用。本文用 drop-in 配置、状态日志和 reset-failed 说明如何限制失败重启频率,并区分参数边界。211 收藏
-
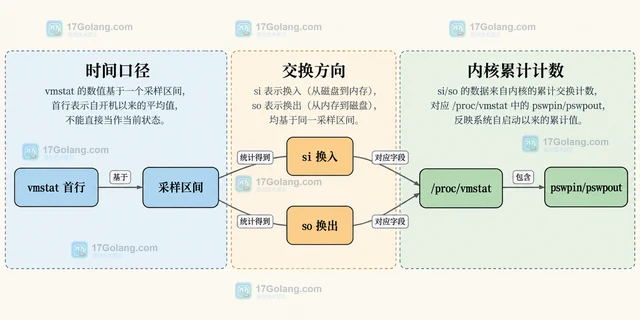 Linux vmstat 的 si/so 长期非零,通常说明系统持续发生换页,但严重程度要结合采样区间、free、major fault、PSI 和 cgroup 限额判断。本文给出从确认时间语义到定位根因、验证修复的排查清单。209 收藏
-
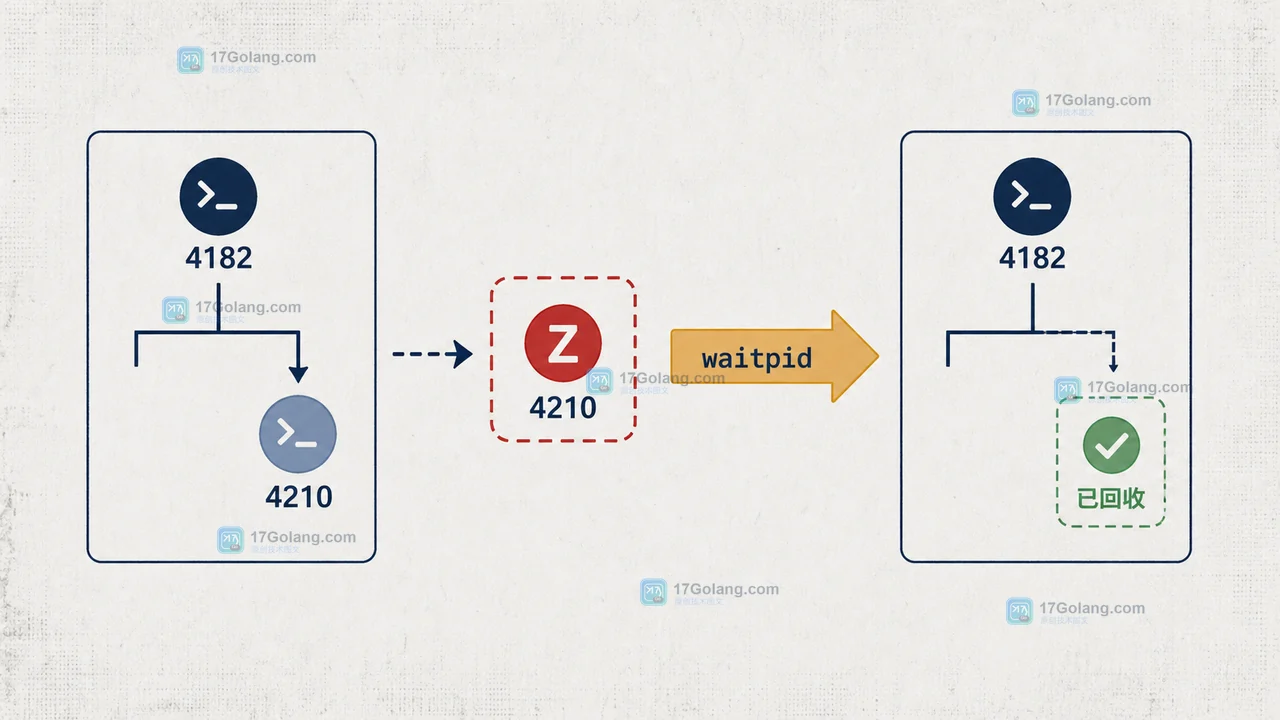 服务停止时日志已经出现 SIGTERM,但进程迟迟不退,甚至留下僵尸进程。本文用一个可复查的 Linux 场景讲清信号是否送达、进程是否处理、子进程如何回收,以及服务管理器的停止边界。208 收藏
-
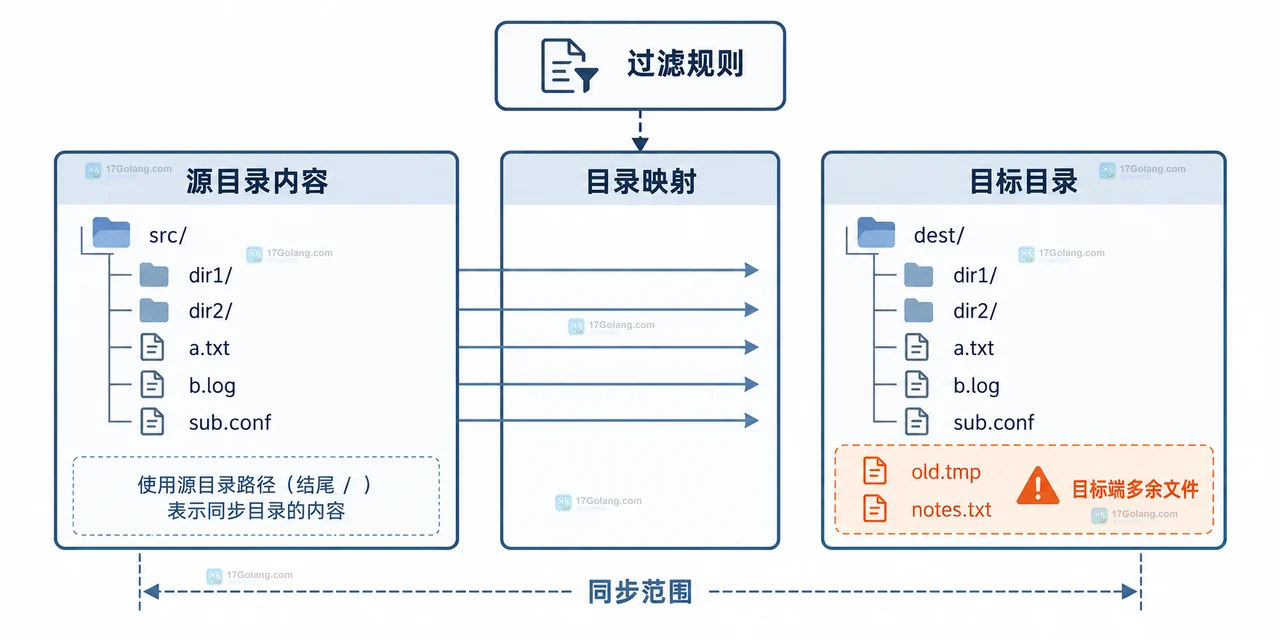 用 rsync --dry-run 预览 --delete 将删除的目标端文件,结合 --itemize-changes、目录斜杠、过滤规则和 --max-delete 建立正式同步前的检查清单。207 收藏
-
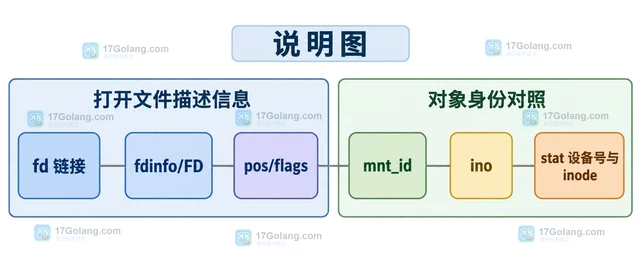 通过 /proc/PID/fd 与 fdinfo 观察文件描述符,判断普通文件、已删除文件和特殊对象是否仍被进程持有,并掌握 inode、权限与竞态边界。206 收藏
-
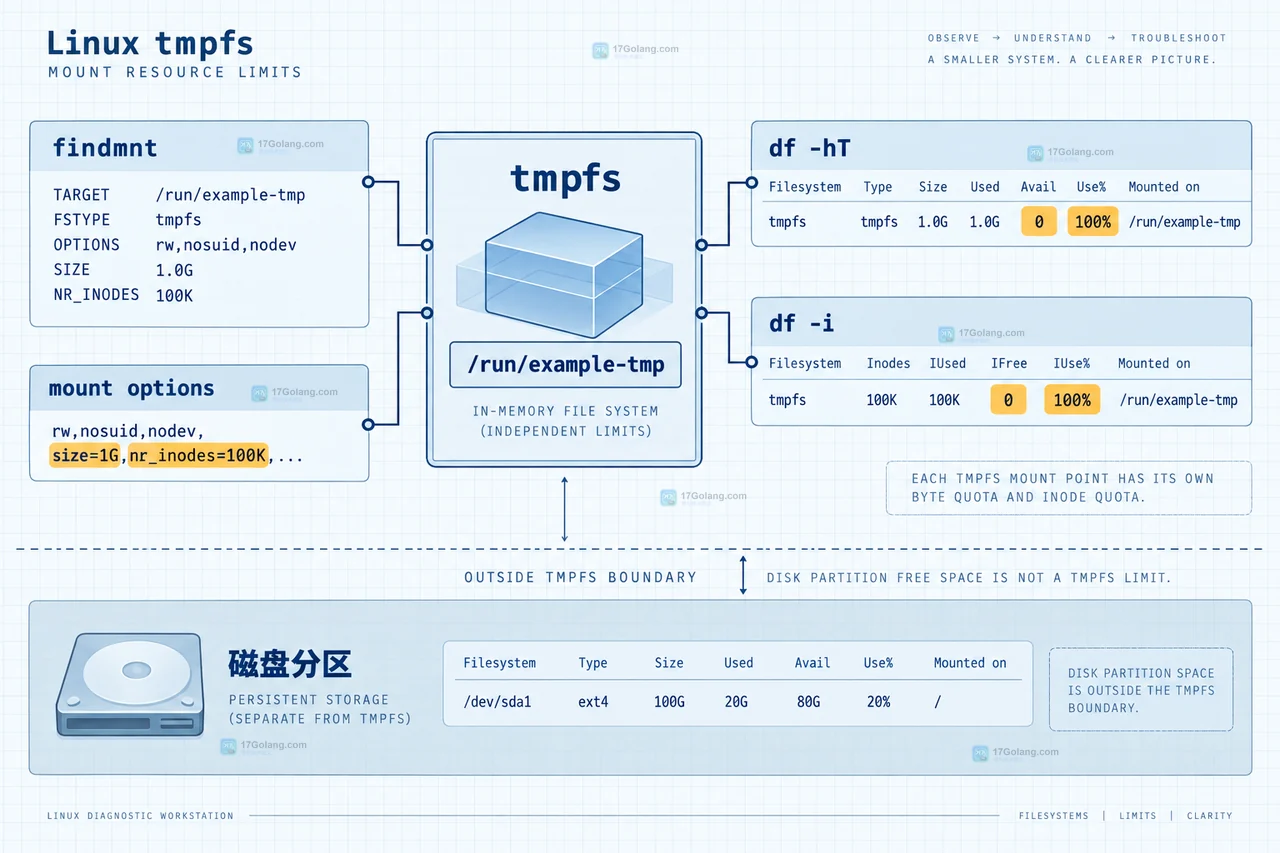 Linux 根分区明明还有空间,tmpfs 却提示已满怎么办?本文从挂载点、size、nr_inodes、Shmem 和 cgroup 五个角度排查,并给出安全清理与 remount 调整方法。204 收藏
-
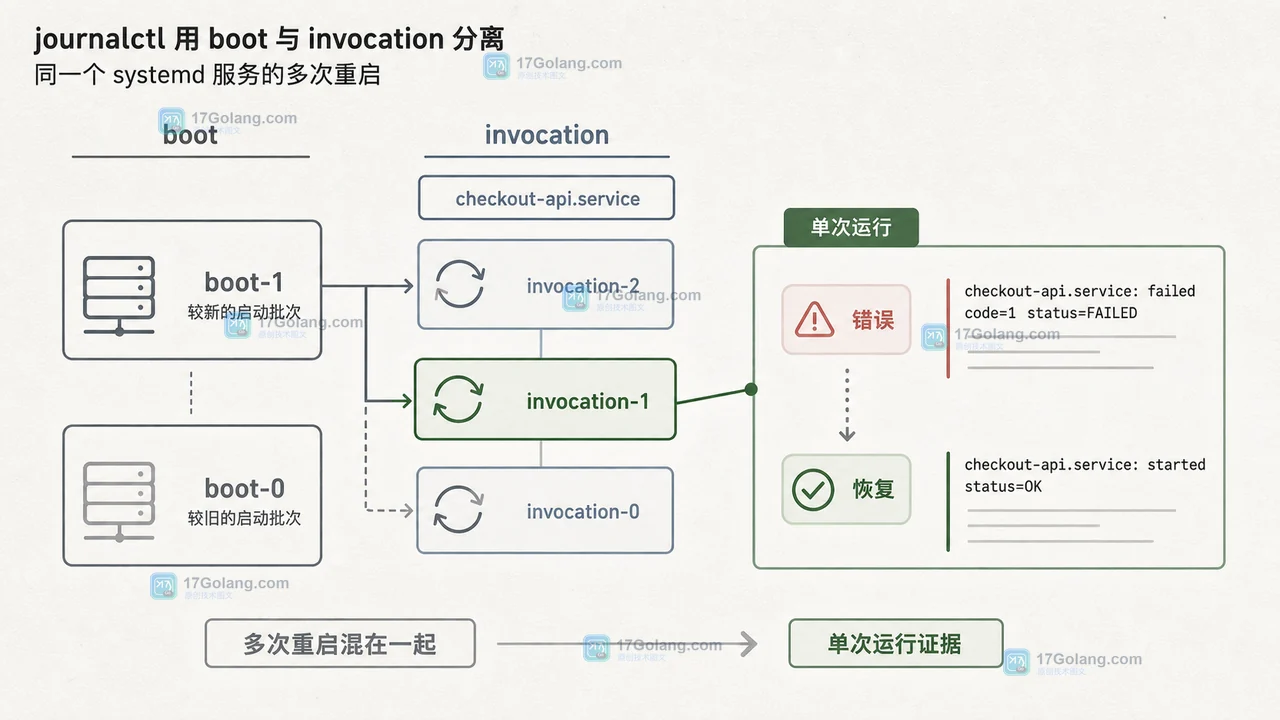 服务刚刚恢复时,先别把整本日志倒出来。本文用 journalctl 的时间、unit、boot 和 invocation 四层筛选,把一次 systemd 服务故障压缩成可核对的证据链,并给出日志不持久化时的处理边界。200 收藏
-
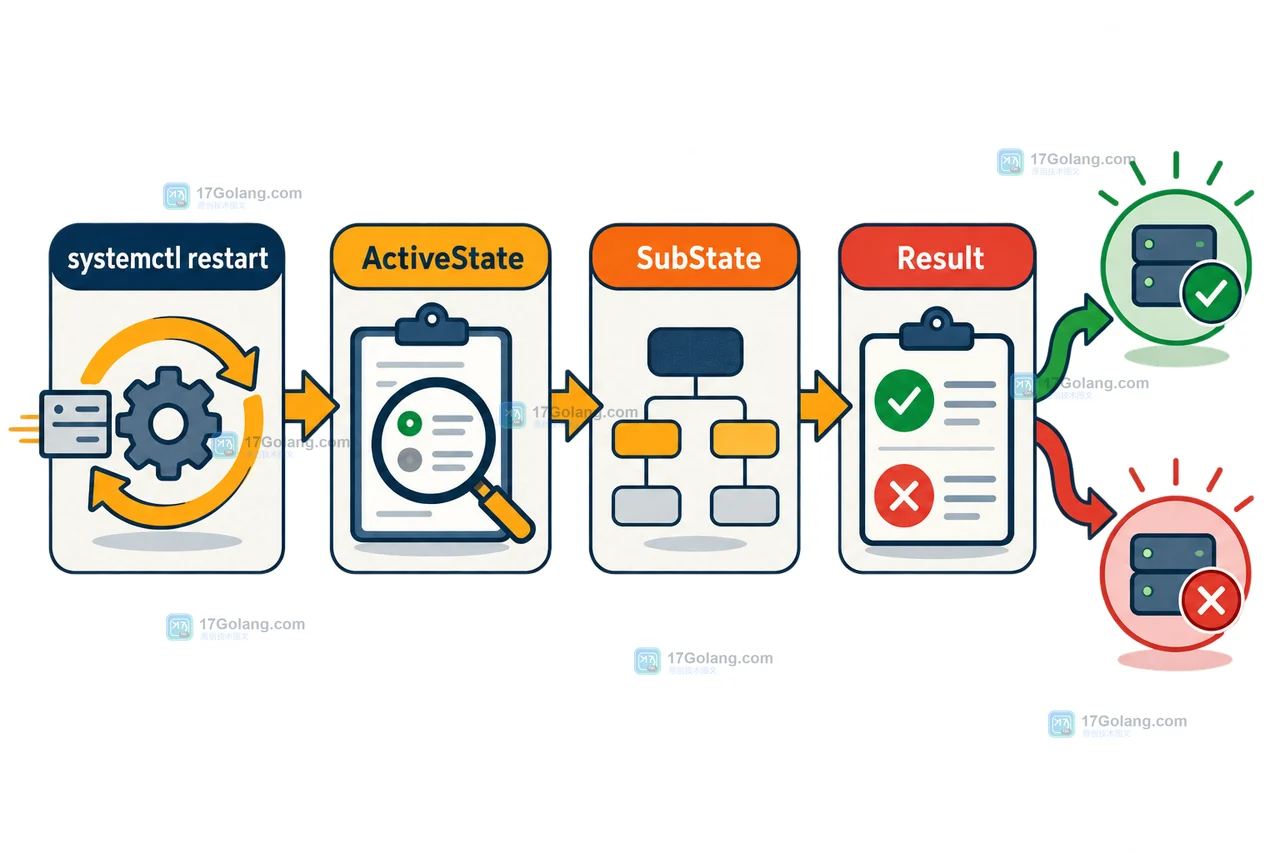 Linux 服务重启返回并不等于服务恢复。通过 ActiveState、SubState、Result 和 journalctl -u 串起状态与最近一次启动日志,定位服务为何重启后仍不可用。200 收藏
-
 Linux 上的 systemd 服务突然退出并生成 core 文件时,可以先列出崩溃记录,再查看信号、进程和可执行文件,最后决定是否进入调试器。文章同时说明 Storage、保留期限和权限边界,避免只会下载 core 却找不到可用证据。199 收藏
-
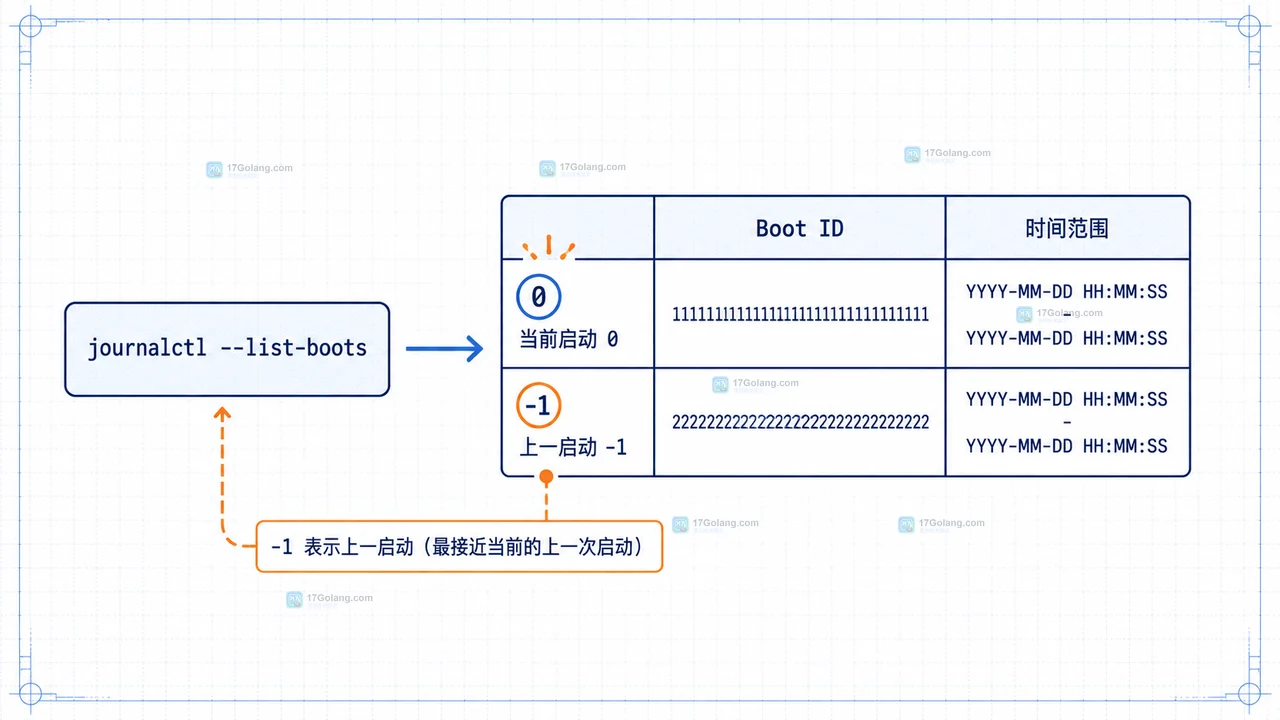 journalctl -b -1 没有输出时,不要先假设日志被清理。本文从 --list-boots、Boot ID、/var/log/journal 和 Storage= 四个点,给出一条可复现的核对与修复路径。198 收藏
-
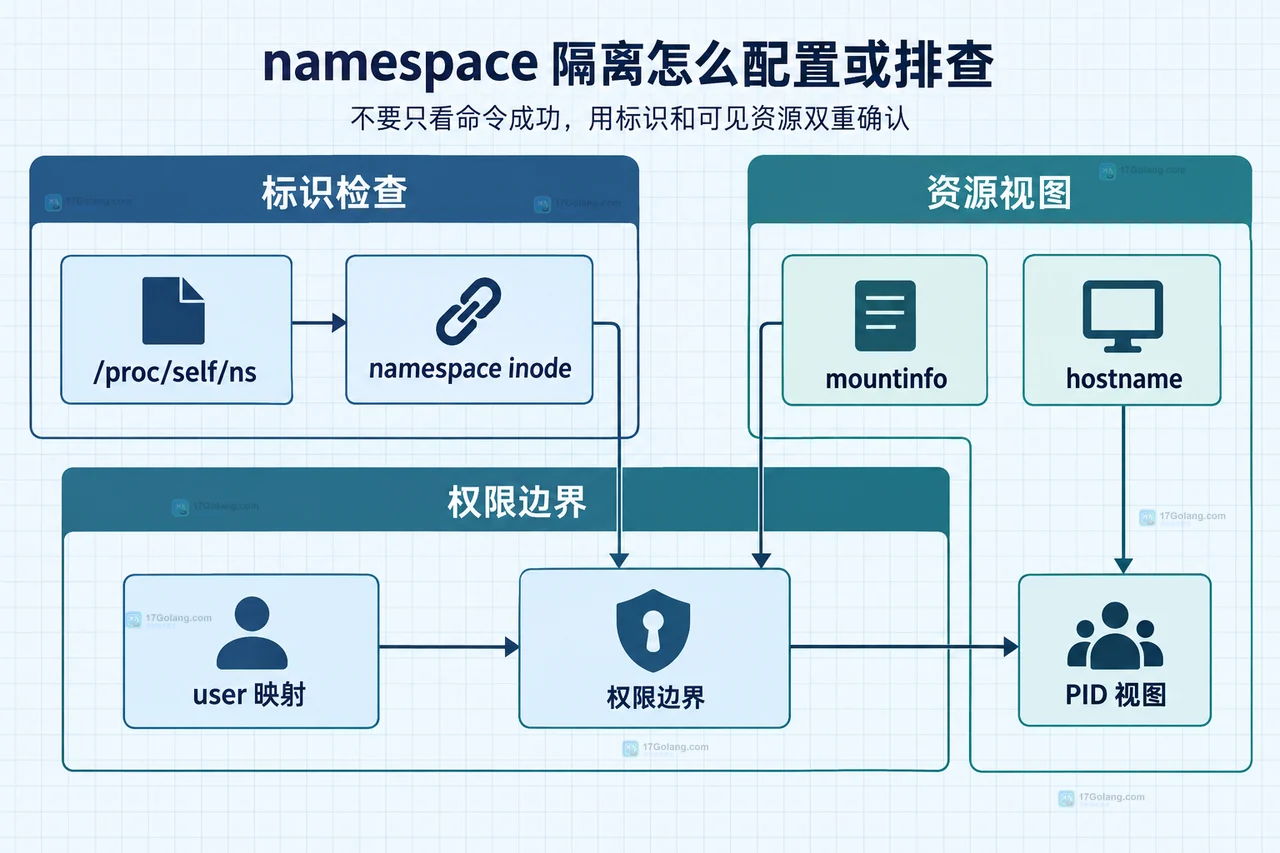 Linux namespace 隔离不是一个总开关。本文用 unshare 创建最小环境,结合 /proc/self/ns、mountinfo、PID 视图和 user 映射排查配置是否真正生效。197 收藏
-
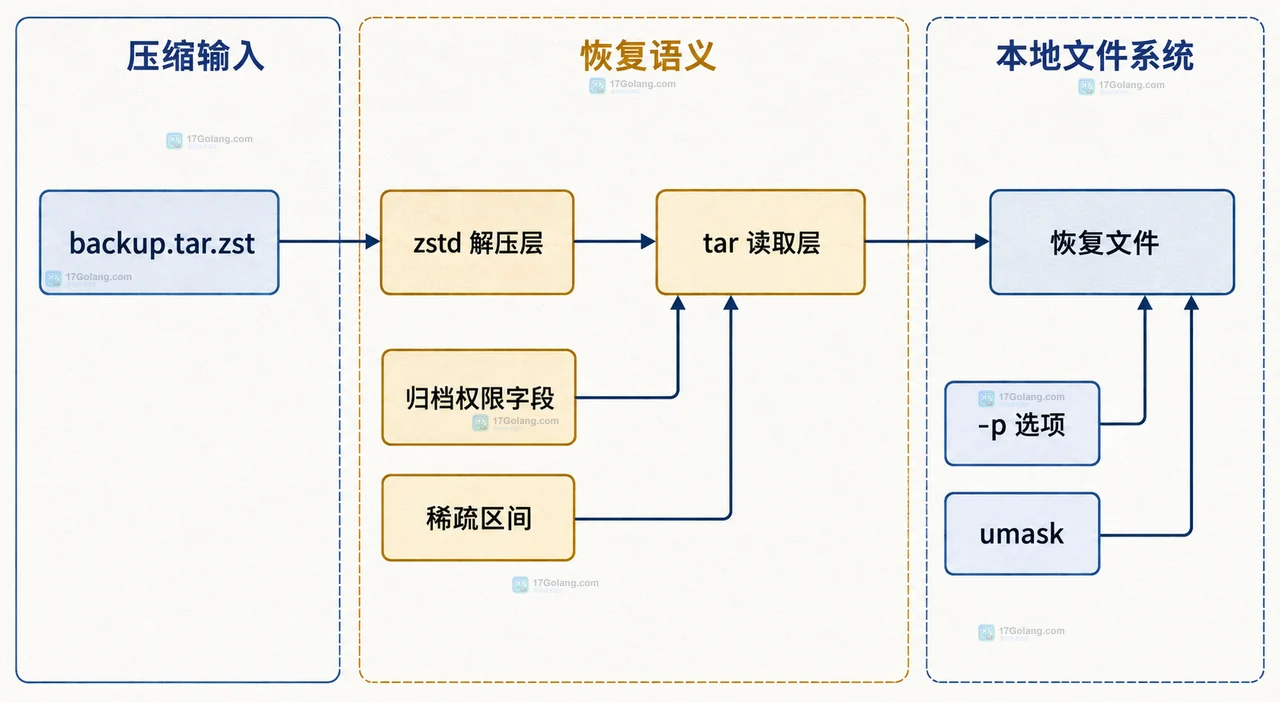 用 GNU tar 配合 zstd 归档时,--sparse 负责保留稀疏文件的空洞,解包阶段用 -p 控制权限位是否受 umask 限制。本文给出创建、恢复和复查命令。196 收藏
-
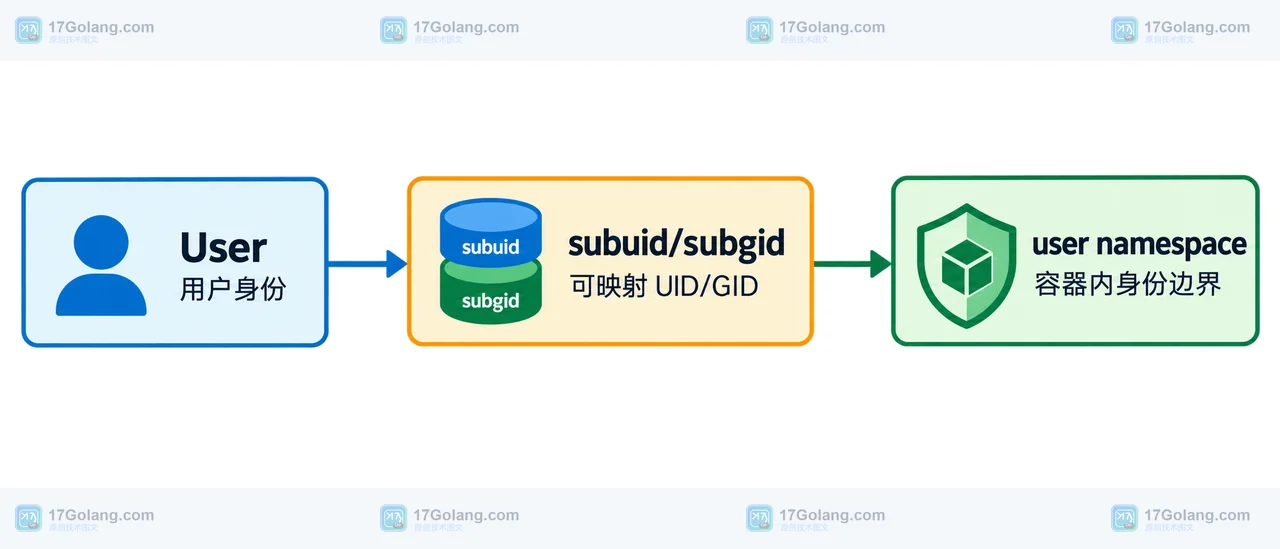 Podman rootless 容器启动失败,优先核对 /etc/subuid、/etc/subgid 是否给当前用户分配范围,再区分存储目录、网络与镜像权限问题。本文用一条排查链解释这些配置之间的边界。193 收藏
-
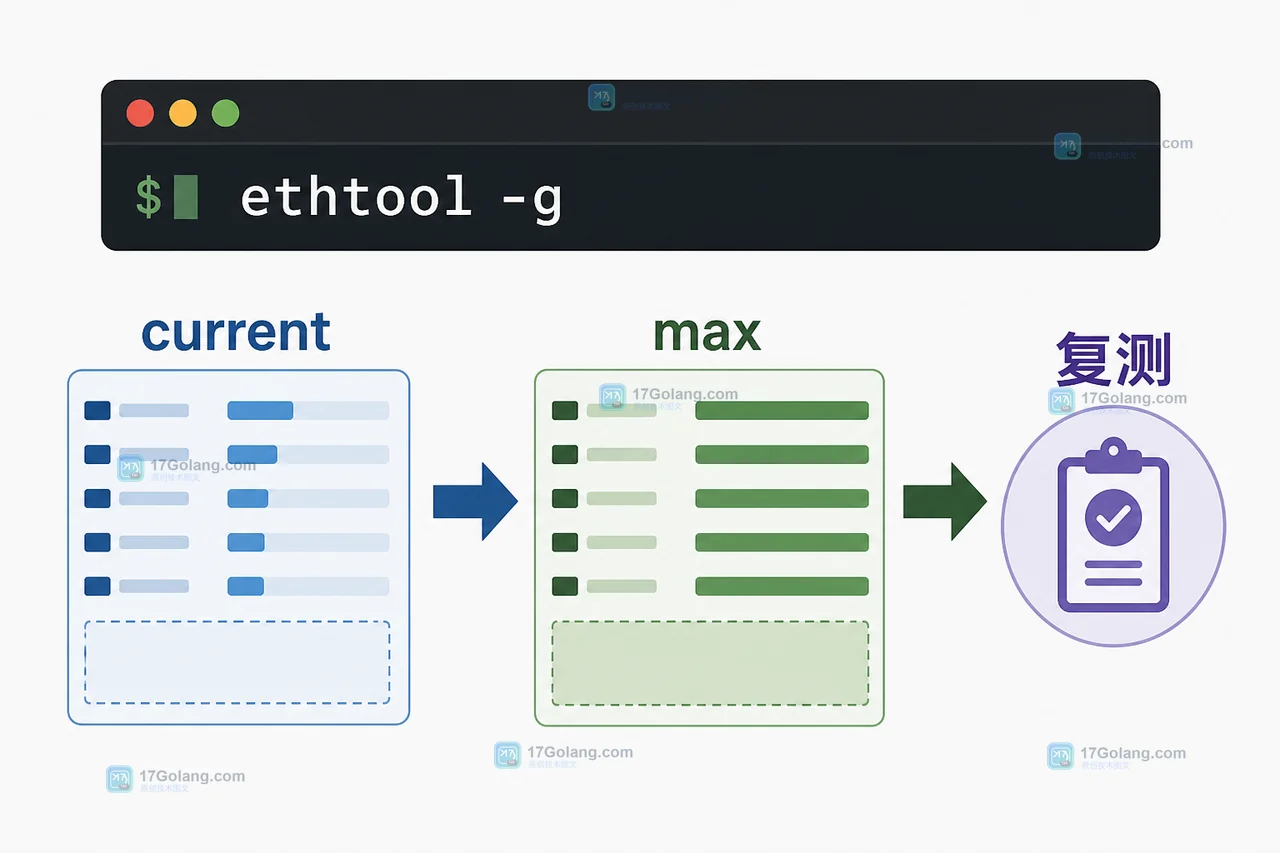 网卡丢包不能只看 ping。本文用 ethtool -S、ethtool -g 和 ip -s link 对照驱动统计、收发 ring 与内核计数,判断丢包发生在哪一层,并给出安全复测顺序。192 收藏