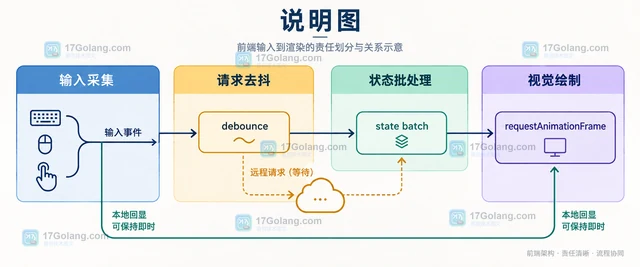
前端状态更新频繁时,批处理与去抖分别解决什么
前端状态更新频繁时,批处理负责合并同一调度窗口的重复提交,去抖负责等待连
Ollama 是一款专为在本地计算机上高效运行大型语言模型(LLM)而设计的命令行工具。它允许用户轻松下载并在本地部署如 Llama 2、Code Llama 等主流模型,同时支持用户自定义创建专属模型。作为一个免费且开源的项目,Ollama 目前完美兼容 macOS 和 Linux 操作系统,并计划在未来全面支持 Windows 系统。
此外,Ollama 提供了官方认证的 Docker 镜像,极大地简化了通过 Docker 容器部署大型语言模型的流程。这一特性确保了所有与模型的交互均在本地环境中完成,无需将敏感或私有数据上传至第三方云服务,从而保障了数据安全。在性能方面,Ollama 在 macOS 和 Linux 平台上支持 GPU 硬件加速,并提供了简洁易用的命令行界面(CLI)以及用于应用程序集成的 REST API。
对于需要在本地环境中测试、实验或部署大语言模型的开发人员和研究人员而言,Ollama 是一个极具价值的工具,因为它摆脱了对外部云服务的依赖,实现了完全自主可控的运行环境。
最新版本的 Ollama 已正式推出适用于 macOS 和 Windows 的桌面客户端。新版本新增了文件处理能力及多模态交互功能,使得用户与本地大语言模型的互动变得更加直观、便捷和高效。
获取Ollama安装包,扫码关注回复:Ollama
Ollama 内置了丰富的模型库,用户可以根据需求自由选择并安装所需的模型。目前平台已支持超过40种模型,且数量仍在持续增长中。以下是部分可供下载的热门开源模型示例:
| 模型 | 参数大小 | 文件大小 | 下载运行命令 |
|---|---|---|---|
| DeepSeek-R1 | 1.5B、7B、14B、32B等 | 12-320GB | ollama run deepseek-r1 |
| Neural Chat | 7B | 4.1GB | ollama run neural-chat |
| Starling | 7B | 4.1GB | ollama run starling-lm |
| Mistral | 7B | 4.1GB | ollama run mistral |
| Llama 2 | 7B | 3.8GB | ollama run llama2 |
| Code Llama | 7B | 3.8GB | ollama run codellama |
| Llama 2 Uncensored | 7B | 3.8GB | ollama run llama2-uncensored |
| Llama 2 13B | 13B | 7.3GB | ollama run llama2:13b |
| Llama 2 70B | 70B | 39GB | ollama run llama2:70b |
| Orca Mini | 3B | 1.9GB | ollama run orca-mini |
| Vicuna | 7B | 3.8GB | ollama run vicuna |