
MySQL 8.4 EXPLAIN ANALYZE 的 actual rows 怎么和估算对比
来源:17golang原创
时间:2026-09-15 02:22:07 181浏览 收藏
排查 MySQL 慢查询时,最容易误读的一行是 rows。它不是这次查询真实返回的行数,而是优化器在执行前做出的估算;只有把它和同一个迭代器里的 actual rows、loops 放在一起看,才能判断估算是否偏离。MySQL 8.4 的实用做法是先看计划,再用只读查询运行 EXPLAIN ANALYZE,最后沿着偏差最大的节点回到统计信息和索引。
官方文档:https://dev.mysql.com/doc/refman/8.4/en/explain.html
比较时只对齐同一个 TREE 节点:估算 rows 是优化器预期返回量,actual rows 是执行时实际返回量;loops 大于 1 时,两者以及 actual time 通常都是每轮平均值,判断总工作量必须把循环次数一起考虑。
- 先用
EXPLAIN FORMAT=TREE看估算,再用EXPLAIN ANALYZE FORMAT=TREE看真实执行。 - 偏差要在同一节点比较;父节点、子节点和最终结果的行数语义不同。
- 先复查统计信息与数据分布,再决定是否调整索引或改写 SQL。
actual rows 和估算 rows 分别在回答什么
普通 EXPLAIN FORMAT=TREE 描述的是“如果这样执行,优化器预计会发生什么”。树节点中的 rows 是估算返回行数,cost 是成本模型数值;它们由现有统计信息、谓词选择性和候选访问路径共同决定。InnoDB 的估算并不保证精确。
EXPLAIN ANALYZE 会真正执行语句,并在同一棵迭代器树上增加 actual time=a..b、actual rows 和 loops。其中 a 是拿到第一行的平均时间,b 是拿完该迭代器数据的平均时间,单位是毫秒。它改变了语句的性质:不要对写操作或不可重复的查询随意运行,先用受控的只读范围验证。
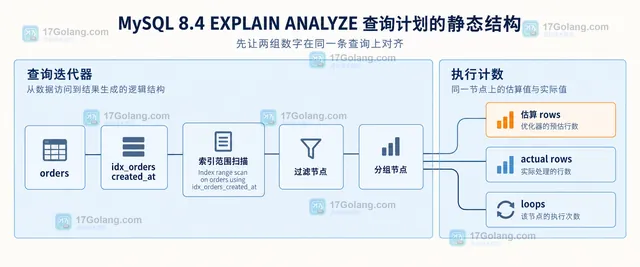
先让两组数字在同一条查询上对齐
下面用一个带日期过滤的订单查询做示例。代码只是文章中的可复现写法,输出中的数字是格式示意;重点是同一节点的对照关系。
-- 先查看优化器预估的访问路径,不执行查询结果集。
EXPLAIN FORMAT=TREE
SELECT customer_id, SUM(amount) AS total_amount
FROM orders
WHERE created_at >= '2026-08-01'
  AND created_at = '2026-08-01'
  AND created_at
-> Filter: (...) (cost=920 rows=1200)
(actual time=0.18..42.6 rows=9800 loops=1)
-> Index range scan on orders using idx_orders_created_at
(cost=920 rows=12000)
(actual time=0.12..35.4 rows=12000 loops=1)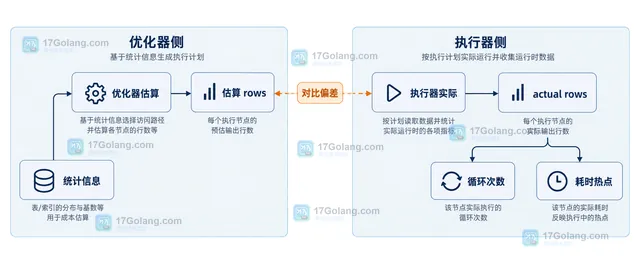
这里应该先比较 Filter 节点的 rows=1200 与 actual rows=9800,再看它的子节点。估算大约低了 8 倍,说明过滤选择性可能判断得过于乐观,但不能仅凭这一行断定“索引失效”。子节点实际扫到 12000 行,过滤后留下 9800 行,过滤条件本身确实没有筛掉太多数据。
loops 不为 1 时,actual rows 该怎么读
嵌套循环连接的内侧节点经常出现 loops 大于 1。例如一次外表扫描产生 1000 个键值,内表索引查找可能显示 actual rows=1 loops=1000。这不是只读了一行,而是每轮平均命中一行,实际查找发生了约 1000 轮。对应的 actual time 也通常是单轮平均时间,不能把它当成整个内表节点的总耗时。
| 字段 | 含义 | 对比时的动作 |
|---|---|---|
rows | 执行前对该迭代器返回量的估算 | 与同节点 actual rows 比 |
actual rows | 执行时该迭代器返回量,循环时通常按轮平均 | 结合 loops 看总访问规模 |
loops | 该迭代器被父节点请求执行的次数 | 检查是否存在重复内表访问 |
actual time | 拿首行到拿完数据的执行时间,单位毫秒 | 定位真正耗时的子树 |
因此,估算差异和耗时热点是两条线索。一个节点可能 rows 估算很准,却因为 loops 很多而耗时;也可能 rows 偏差很大,但节点本身很快。不要只盯着倍率最大的行。
偏差大时先检查统计信息和访问路径
先把偏差分成三类:过滤节点偏差大,通常要看列值分布和条件选择性;索引查找节点偏差大,要看索引列、联合索引前缀和连接条件;父节点耗时高而子节点行数正常,则要继续观察连接、排序或聚合的重复工作。
如果表数据近期大量写入、删除,或者过滤列分布明显倾斜,可以先在维护窗口更新统计信息,再重新生成计划。示例命令如下:
-- 更新优化器使用的表统计信息;生产环境先评估执行影响。
ANALYZE TABLE orders;

-- 重新观察估算是否靠近实际,避免只看总耗时。
EXPLAIN ANALYZE FORMAT=TREE
SELECT customer_id, SUM(amount) AS total_amount
FROM orders
WHERE created_at >= '2026-08-01'
  AND created_at
如果统计信息更新后偏差仍在,而且热点集中在回表、低选择性过滤或高 loops 的连接节点,再评估覆盖索引、谓词改写或连接顺序。FORCE INDEX 只能表达一次选择,不会修复错误统计;使用前应拿旧计划、新计划和实际计数做对照。
常见问题
actual rows 越接近 rows,查询就一定越快吗?
不一定。它只能说明这一节点的行数估算较接近,仍要结合 actual time、loops、磁盘访问和父节点操作判断。
为什么 EXPLAIN ANALYZE 没有传统表格输出?
MySQL 8.4 的执行分析使用 TREE 迭代器格式;不要把 FORMAT=JSON 或 FORMAT=TRADITIONAL 当作同一输出模式。
看到估算偏差后要马上加索引吗?
不用。先确认偏差是否改变了计划、是否形成真实耗时,再检查统计信息和数据分布,最后用前后两份分析结果验证索引收益。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
432 收藏
-
327 收藏
-
284 收藏
-
199 收藏
-
数据库 · MySQL | 7小时前 | MySQL · 数据类型 · JSON · SQL排错 · MEMBER OF · MySQL MEMBER OF MySQL JSON 数组成员判断 MEMBER OF 类型不匹配 JSON 数字字符串区别 MySQL JSON 查询167 收藏
-
数据库 · MySQL | 8小时前 | MySQL · 数据库查询 · JSON 函数 · SQL 边界 · JSON 数组 · JSON_CONTAINS MySQL JSON_OVERLAPS JSON 数组相交 MySQL JSON 类型比较 MySQL NULL 边界130 收藏
-
418 收藏
-
410 收藏
-
452 收藏
-
425 收藏
-
488 收藏
-
232 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习