
Go bytes.CutPrefix 解析带标记的二进制帧
来源:17golang原创
时间:2026-09-29 01:30:59 433浏览 收藏
解析带固定起始标记的二进制帧时,bytes.CutPrefix 很适合完成一件小而关键的事:确认标记确实位于字节切片开头,并在匹配成功时返回去掉标记后的帧体。它不会在中间搜索,也不会悄悄吞掉不匹配的数据,因此比“先 HasPrefix,再手工切片”更紧凑,比无法报告是否命中的 TrimPrefix 更适合协议校验。
官方文档:https://pkg.go.dev/bytes#CutPrefix
after, found := bytes.CutPrefix(frame, magic)同时完成起始标记校验和移除。- 标记缺失时返回原始
frame和false,必须检查found。 after与输入共享底层数组;输入缓冲区会复用时,长期保存前要bytes.Clone。CutPrefix从 Go 1.20 起提供,旧工具链需要用HasPrefix加切片实现等价逻辑。
我为什么改掉 HasPrefix 加手工切片
我曾在一个设备消息解码器里写过这样的逻辑:先用 bytes.HasPrefix 检查四字节 MAGIC,再执行 frame[len(magic):]。代码本身没有错,但检查和切片被分散到不同位置后,维护者加了新分支,出现了“检查 A 标记,却按 B 标记长度切片”的隐患。
if !bytes.HasPrefix(frame, magic) {
    // 标记不匹配时立即拒绝,避免继续解释未知数据。
    return Frame{}, ErrBadMagic
}
body := frame[len(magic):] // 手工长度必须始终和上面的 magic 保持一致。
CutPrefix 把两个动作绑定在一次调用里,返回值也直接表达协议分支。对我来说,它最大的价值不是少写一行,而是让“只有匹配成功才能取得帧体”成为局部、不可拆开的判断。
最小配方:校验标记后再解析帧头
下面定义一个小型帧格式:前四字节是 ASCII 可读的 GPKT 标记,随后依次是版本、标志、两字节大端负载长度和负载。上层必须先提供一个完整帧;本文只负责帧内解析,不把 CutPrefix 当成 TCP 拆包工具。
MAGIC(4) | VERSION(1) | FLAGS(1) | LENGTH(2) | PAYLOAD(N)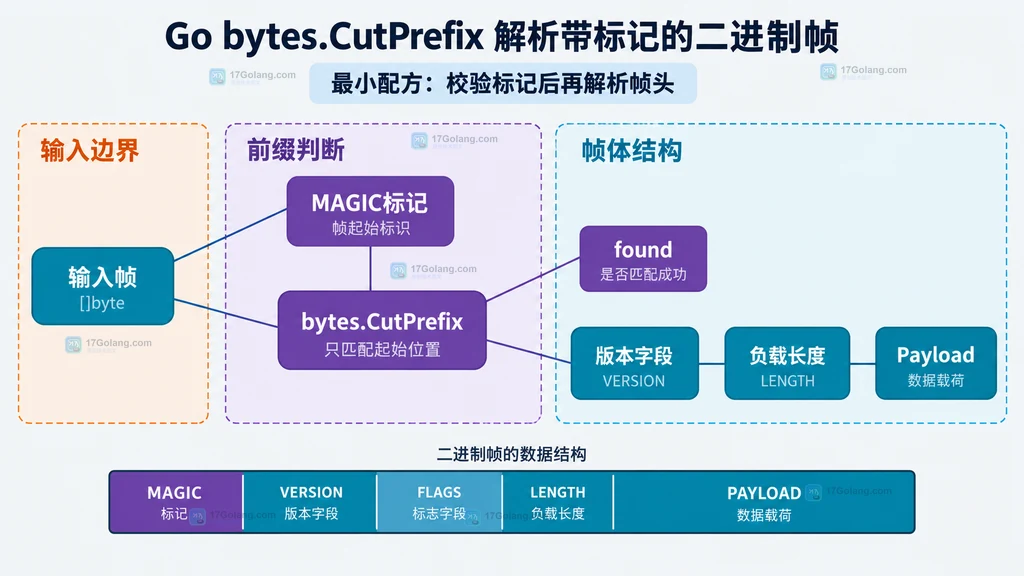
最小解析器先移除 MAGIC,再检查剩余帧头。found 为 false 时,after 实际上仍是原输入;如果忽略布尔值继续解析,就会把 MAGIC 的第一个字节误当成版本。
package protocol

import (
    "bytes"
    "encoding/binary"
    "errors"
    "fmt"
)

var dataMagic = []byte{'G', 'P', 'K', 'T'}

const (
    fixedHeaderSize = 4         // 版本、标志和两字节长度。
    maxPayloadSize  = 1  maxPayloadSize {
        // 在业务层接触负载前拒绝超限声明。
        return Frame{}, fmt.Errorf("%w: %d", ErrPayloadTooLarge, declared)
    }
    if declared != len(payload) {
        // 当前函数只接受恰好一个完整帧,不接受半帧或尾随字节。
        return Frame{}, fmt.Errorf(
            "%w: declared=%d actual=%d",
            ErrLengthMismatch,
            declared,
            len(payload),
        )
    }

    return Frame{Version: version, Flags: flags, Payload: payload}, nil
}这个顺序有意把格式边界逐层缩小:标记决定它是不是本协议,最小帧头决定字段能否读取,版本决定字段含义是否已知,声明长度决定负载范围。CutPrefix 只负责第一层,不能替代后面的长度和版本校验。
CutPrefix、TrimPrefix 和 HasPrefix 的差别
| 写法 | 返回语义 | 适合场景 |
|---|---|---|
bytes.CutPrefix | 返回去前缀后的切片和是否命中 | 协议标记、类型前缀、必须区分合法与未知输入 |
bytes.TrimPrefix | 不匹配时原样返回,没有 found | 前缀可有可无,调用方不关心是否移除 |
bytes.HasPrefix | 只返回 bool | 只做分类,不需要立即取得剩余内容 |
协议解析里我不建议用 TrimPrefix 后比较长度来推断是否匹配。空前缀、空帧或相同长度输入都会让意图变得含糊。CutPrefix 的 found 直接对应“是否接受这个帧”,错误路径更容易审阅。
另一方面,如果代码只想统计某种消息而不解析帧体,HasPrefix 仍然是清楚的选择。API 没有绝对优劣,重点是返回值能否准确表达调用方接下来要做的决定。
变体:多标记分派与切片所有权
带标记的协议常用不同 MAGIC 区分数据帧和心跳帧。最直白的实现是按优先级尝试每个固定前缀,匹配后把剩余字节交给对应解码器。由于所有标记长度和内容都写在各自调用中,不会出现共享下标计算。
var (
    dataPrefix = []byte{'D', 'A', 'T', 'A'}
    pingPrefix = []byte{'P', 'I', 'N', 'G'}
)

func DecodePacket(packet []byte) (any, error) {
    if body, found := bytes.CutPrefix(packet, dataPrefix); found {
        // DATA 标记只映射到数据帧解码器。
        return decodeData(body)
    }
    if body, found := bytes.CutPrefix(packet, pingPrefix); found {
        // PING 标记只映射到心跳帧解码器。
        return decodePing(body)
    }

    // 未知标记不尝试猜测类型,保留清晰错误语义。
    return nil, ErrBadMagic
}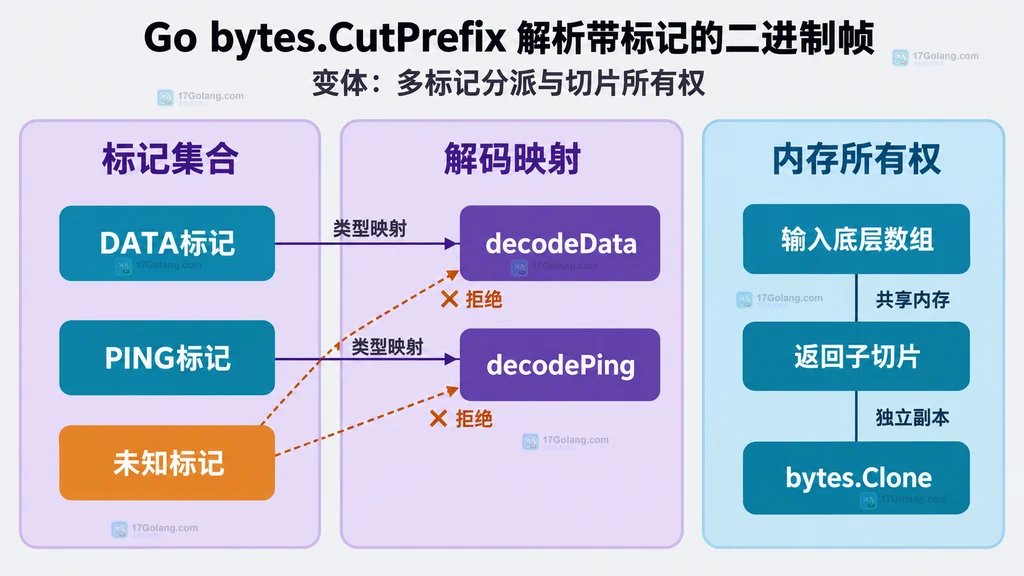
官方文档明确说明,CutPrefix 返回的是原切片的子切片,不是副本。这让同步解码很省事:只读字段时不必重新分配。但如果 packet 来自循环复用的网络缓冲区,而 Payload 要送入异步队列,下一次读取就可能覆盖旧数据。
func DecodeFrameOwned(frame []byte) (Frame, error) {
    parsed, err := DecodeFrameView(frame)
    if err != nil {
        // 保留具体格式错误,交给上层统计或断开连接。
        return Frame{}, err
    }

    parsed.Payload = bytes.Clone(parsed.Payload) // 长期持有时建立独立所有权。
    return parsed, nil
}我的取舍是把函数名写明所有权:DecodeFrameView 只返回视图,调用方保证输入生命周期;DecodeFrameOwned 返回可跨 goroutine 或缓存持有的数据。相比在注释里模糊提醒,这种命名更不容易被后来代码误用。
几个会踩到的兼容与边界问题
空前缀会匹配所有输入
bytes.CutPrefix(s, nil) 或传入空切片时会返回 s, true。如果协议标记来自配置,启动时必须验证它非空;更稳妥的做法是像示例一样把合法标记固定在代码中。
标记出现在中间不会命中
这是正确行为,不是遗漏。CutPrefix 只检查开头;如果需要按分隔符拆字段,应使用 bytes.Cut。不要为了“提高兼容性”先搜索 MAGIC 再丢掉前面的字节,那会掩盖上游拆帧错误,也可能把负载中的同值字节误判为新帧。
Go 1.19 及更早没有 CutPrefix
该函数在 Go 1.20 加入。无法升级工具链时,可以保留一个很小的兼容函数,语义要和标准库一致:
func cutPrefixCompat(s, prefix []byte) ([]byte, bool) {
    if !bytes.HasPrefix(s, prefix) {
        // 不匹配时返回原切片和 false,与 CutPrefix 保持一致。
        return s, false
    }
    return s[len(prefix):], true // 匹配后返回共享底层数组的子切片。
}
错误日志不要直接打印完整帧
二进制负载可能包含凭据或用户数据。记录坏标记时,限制十六进制预览长度,并记录总长度、远端标识和错误类型;不要把整个 packet 转成字符串。格式错误、版本不支持和长度不一致也应使用不同错误,便于监控判断是兼容问题还是链路损坏。
完整实现的落地检查
把 CutPrefix 接入实际解码器前,我会检查这些条件:MAGIC 是否固定且非空;上层是否保证一次只交付一个完整帧;最小帧头是否在索引前校验;版本不支持时是否立即拒绝;声明长度是否有上限并与实际负载一致;未知标记是否返回明确错误;返回的 Payload 是短期视图还是独立副本;项目的 go.mod 是否至少声明 Go 1.20。
适合使用 bytes.CutPrefix 的,是“标记必须位于开头,匹配后立即消费剩余字节”的场景,例如二进制帧 MAGIC、记录类型标签和固定信封前缀。它不适合代替流式拆包,也不负责验证整个帧。把它放在协议入口,作为第一道精确而零拷贝的分类判断,代码会比散落的前缀检查和手工下标更容易维护。
官方资料:https://pkg.go.dev/bytes#CutPrefix、https://go.dev/doc/go1.20#bytes、https://pkg.go.dev/encoding/binary。
-
151 收藏
-
101 收藏
-
323 收藏
-
428 收藏
-
143 收藏
-
165 收藏
-
488 收藏
-
359 收藏
-
266 收藏
-
233 收藏
-
265 收藏
-
295 收藏
-
379 收藏
-
344 收藏
-
187 收藏
-
222 收藏
-
412 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习