
MySQL 函数索引为什么常需要显式 CAST
来源:17golang原创
时间:2026-10-04 11:42:59 406浏览 收藏
MySQL 函数索引里常见的显式 CAST,主要不是为了让 SQL “看起来更严格”,而是为了把表达式结果收敛成可建立索引、长度明确、比较规则可预测的数据类型。最典型的场景是从 JSON 中提取字符串:data->>'$.name' 的结果类型是 LONGTEXT,而函数索引不能像普通文本列那样声明前缀长度,因此直接对该表达式建索引会失败。把它转换为 CHAR(30)、CHAR(64) 等有界字符串后,MySQL 才能把隐藏生成列定义为可索引的 VARCHAR 类型。
不过,能创建索引只是第一关。查询中的 JSON 路径、转换目标、长度、字符集和排序规则还要与索引定义保持一致,否则优化器可能无法把查询表达式匹配到这个函数索引。官方说明入口:https://dev.mysql.com/doc/refman/8.4/en/create-index.html
先明确 CAST 解决的不是语法装饰
MySQL 8.0.13 起支持函数索引键部分,可以直接索引表达式值。普通整数表达式往往不需要额外转换,例如绝对值或两个整数列之和,本身已经有确定的结果类型:
-- 整数表达式的结果类型明确,可以直接作为函数索引键
CREATE INDEX idx_abs_amount
ON orders ((ABS(amount)));

-- 查询表达式要与索引中的表达式保持一致
EXPLAIN SELECT id, amount
FROM orders
WHERE ABS(amount) = 100;
真正频繁出现 CAST 的地方,是表达式天然返回过宽类型、无界文本或与业务比较语义不一致时。它通常同时完成三件事:
| 作用 | 没有显式 CAST 的风险 | 设计时要决定什么 |
|---|---|---|
| 确定索引键类型 | 结果可能是 LONGTEXT、JSON 或其他不适合普通 BTREE 键的类型 | 业务值应该按字符串、整数、小数还是日期比较 |
| 限制索引键长度 | 函数索引不能使用普通列的前缀长度语法 | 最大有效长度以及超过长度时如何处理 |
| 固定比较语义 | 查询表达式与索引表达式的字符集或排序规则可能不同 | 是否区分大小写、重音和二进制差异 |
因此,不能形成“函数索引都要 CAST”的机械规则。正确判断方式是先看表达式的结果类型,再看该类型是否能成为索引键,最后检查查询端是否能复现同一表达式和比较语义。
函数索引其实是隐藏的虚拟生成列
理解函数索引的内部模型后,很多限制就不再显得突兀。MySQL 会把每个函数索引键部分实现为一个隐藏的虚拟生成列,再在该列上建立普通索引。这个虚拟列本身不额外存储一份列值,但索引结构仍然占用空间。
这意味着函数索引会同时继承两组约束:
- 生成列表达式的限制:只能使用生成列允许的函数,不能包含子查询、参数、变量、存储函数或可加载函数。
- 索引键的限制:结果类型、最大键长度、排序规则和存储引擎能力都必须满足索引要求。
表达式外层的双括号也不是多余的。外层括号属于索引键列表,内层括号用于告诉解析器这是一个表达式,而不是普通列名:
-- 正确:表达式作为函数索引键,需要额外一层括号
CREATE INDEX idx_total
ON order_items (((price * quantity)));

-- 更常见的写法:一层属于键列表,一层包住表达式
CREATE INDEX idx_total_compact
ON order_items ((price * quantity));
函数索引也不能写成 INDEX ((column_name)) 来索引一个单独列;单列本来就应该使用普通索引。它也不能直接写列前缀,例如 ((description(20)))。需要控制长度时,应让表达式本身返回有界结果,例如使用 SUBSTRING() 或 CAST()。
JSON 文本表达式为什么会卡在 LONGTEXT
JSON 字符串提取是显式转换最有代表性的案例。操作符 ->> 等价于 JSON_UNQUOTE(JSON_EXTRACT(...)),而 JSON_UNQUOTE() 的返回类型是 LONGTEXT。如果直接建立函数索引,隐藏生成列也会得到 LONGTEXT 类型:
-- 该定义会失败:JSON 文本提取结果是 LONGTEXT
CREATE TABLE employees (
  id BIGINT PRIMARY KEY,
  data JSON NOT NULL,
  INDEX idx_employee_name ((data->>'$.name'))
);
普通 TEXT 或 BLOB 列建立索引时通常需要指定前缀长度,但函数索引键部分不允许前缀长度语法。于是这里出现了一个闭环:结果是 LONGTEXT,它需要前缀;函数索引却不能声明前缀,所以定义无法成立。
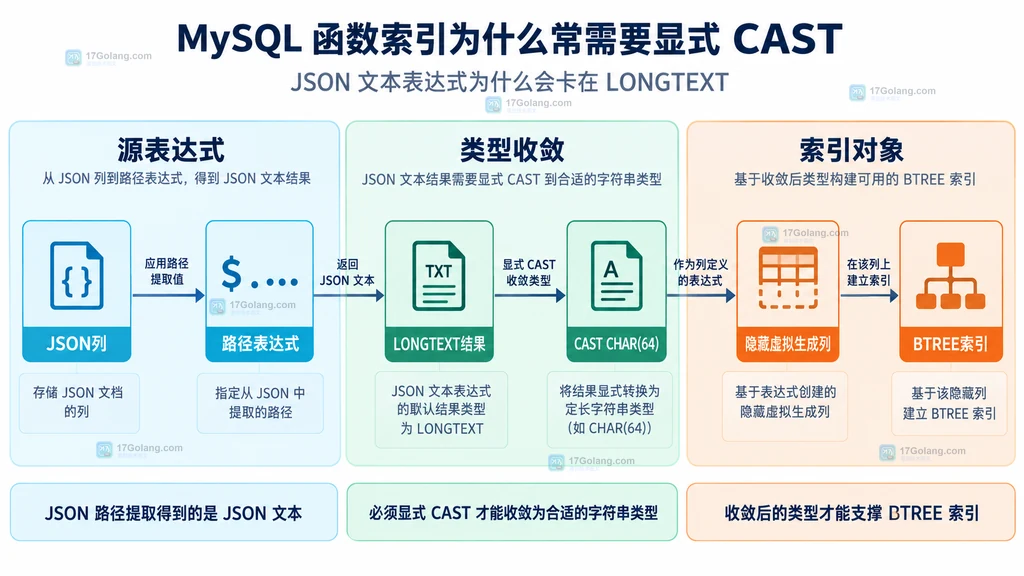
显式转换打破了这个闭环。下面的表达式把无界文本收敛为最多 64 个字符的字符串,隐藏生成列因而得到可索引的 VARCHAR(64) 类型:
-- 把 LONGTEXT 收敛为长度明确的字符串索引键
CREATE TABLE employees (
  id BIGINT PRIMARY KEY,
  data JSON NOT NULL,
  INDEX idx_employee_name (
    (CAST(data->>'$.name' AS CHAR(64)))
  )
);
CHAR(64) 不是通用答案。长度必须来自业务约束:员工姓名、订单号、地区编码和外部事件 ID 的边界都不同。如果真实值可能超过 64 个字符,转换可能带来截断或警告,也可能让不同原值映射为相同索引键;如果索引是唯一索引,这个风险会直接影响写入。最稳妥的做法是先把字段最大长度写进数据契约,再选择转换长度。
按业务语义选择转换目标
字符串只是其中一种情况。CAST 的价值在于告诉 MySQL:这个表达式应该按什么数据域建立和比较索引。选择目标类型时,应以查询条件的真实语义为准。
数字不要长期按字符串比较
如果 JSON 中的值代表金额、数量或序号,把它转成数值类型能避免字典序与数值序不一致。例如字符串中的 "100" 可能排在 "20" 前面,而数值比较不会有这个问题:
-- 金额按定点小数建立函数索引,避免字符串排序语义
CREATE INDEX idx_order_total
ON orders ((CAST(payload->>'$.total' AS DECIMAL(12,2))));

-- 查询端复用相同转换,便于优化器匹配表达式
EXPLAIN SELECT id
FROM orders
WHERE CAST(payload->>'$.total' AS DECIMAL(12,2)) >= 500.00;
转换前要处理脏数据。如果路径值可能是空字符串、带货币符号或任意文本,应先清洗数据或建立受控生成列,而不是假设所有历史 JSON 都能安全转换。
日期要固定格式和时区
JSON 中保存日期时,应先确认格式能稳定转换,而且时区含义一致。若源值是 ISO 日期而不包含时间,可以转成 DATE;若包含时区偏移,则需要先制定统一的存储和比较方案,不能只靠索引表达式临时猜测。
-- 仅适用于 payload 中恒定为 YYYY-MM-DD 的日期文本
CREATE INDEX idx_due_date
ON tasks ((CAST(payload->>'$.due_date' AS DATE)));

-- 查询端保持相同的数据类型,避免字符串与日期混合比较
EXPLAIN SELECT id
FROM tasks
WHERE CAST(payload->>'$.due_date' AS DATE)
字符串长度和排序规则要一起设计
字符串索引不仅有长度,还有排序规则。排序规则决定是否区分大小写、重音和部分等价字符。它影响的不只是索引是否能被使用,也会改变哪些行被认为相等。
查询表达式必须与索引定义对齐
函数索引建成后,优化器需要把查询里的表达式识别为同一个索引表达式。对于生成列索引,官方规则强调表达式必须相同,而且结果类型也要相同。f1 + 1 与 1 + f1 在数学上等价,但在表达式匹配上不一定被视为同一个定义。
JSON 字符串还多一层排序规则问题。JSON_UNQUOTE() 返回的字符串使用 utf8mb4_bin,而 CAST(... AS CHAR(n)) 通常采用服务器默认排序规则。若索引定义是默认不区分大小写,而查询直接使用 ->> 的二进制排序规则,两端的表达式语义并不相同,索引可能不会被采用。
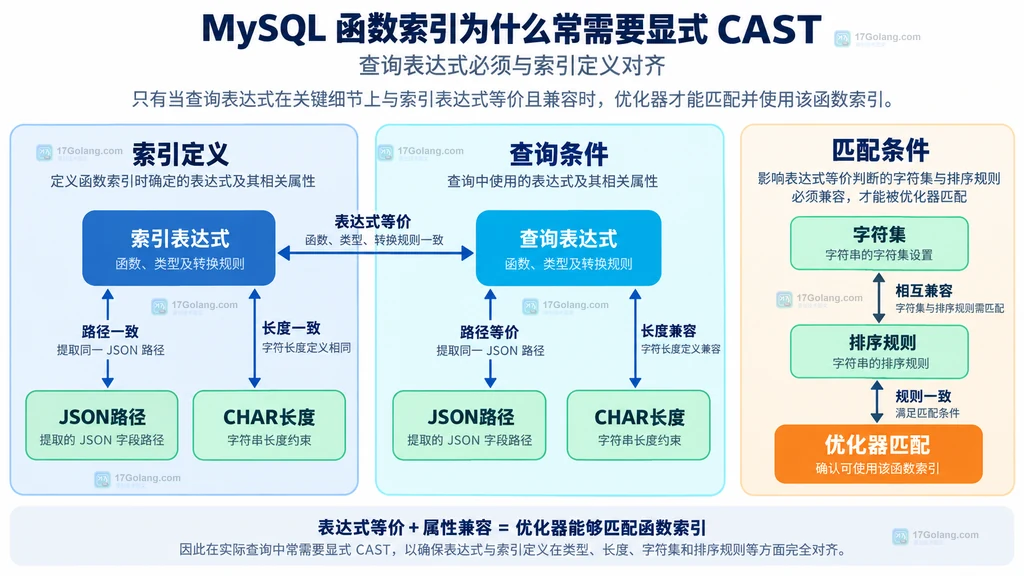
可以选择两种清晰的契约。
方案一:让索引排序规则匹配 JSON_UNQUOTE
如果查询希望直接写 data->>'$.name',可以把索引表达式显式设为 utf8mb4_bin。这样比较区分大小写,James 与 james 是不同值:
-- 索引端采用与 JSON_UNQUOTE 一致的二进制排序规则
CREATE INDEX idx_employee_name_bin
ON employees (
  (CAST(data->>'$.name' AS CHAR(64)) COLLATE utf8mb4_bin)
);

-- 查询保留 JSON 文本提取表达式,比较语义区分大小写
EXPLAIN SELECT id
FROM employees
WHERE data->>'$.name' = 'James';
方案二:查询端完整复用 CAST
如果业务希望使用转换后的默认排序规则,应在查询端写出与索引相同的完整表达式。这样类型、长度和排序规则都更直观:
-- 索引定义与查询条件使用完全相同的转换表达式
CREATE INDEX idx_employee_name_ci
ON employees ((CAST(data->>'$.name' AS CHAR(64))));

-- CHAR 长度必须与索引定义一致,避免结果类型不匹配
EXPLAIN SELECT id
FROM employees
WHERE CAST(data->>'$.name' AS CHAR(64)) = 'James';
不要只看 SQL 是否返回正确行,还要确认大小写语义是否符合业务要求。一个查询在全表扫描时和使用索引时都必须得到一致结果,不能为了“让索引命中”而悄悄改变排序规则。
从旧生成列写法迁移到函数索引
在函数索引出现之前,常见方案是显式添加生成列,再对生成列建立索引。函数索引把这层列隐藏起来,DDL 更紧凑,但并不意味着旧方案失去价值。
| 方案 | 优点 | 适合场景 |
|---|---|---|
| 显式生成列 + 普通索引 | 列名可直接查询,类型与排序规则清晰,排错更直观 | 多个查询和报表都复用同一派生值 |
| 函数索引 | 无需暴露额外业务列,DDL 更紧凑 | 派生值只服务于少数固定查询条件 |
旧写法可能类似:
-- 旧方案:显式生成列保存表达式定义,再为该列建索引
ALTER TABLE employees
  ADD COLUMN employee_name VARCHAR(64)
    GENERATED ALWAYS AS (data->>'$.name') VIRTUAL,
  ADD INDEX idx_employee_name (employee_name);

-- 应用查询直接引用生成列,表达式契约集中在表结构中
EXPLAIN SELECT id
FROM employees
WHERE employee_name = 'James';
迁移到函数索引时,不要只把生成列表达式复制进双括号。应逐项核对原生成列的类型、长度、字符集和排序规则,并确认应用查询能稳定复用等价表达式:
-- 新方案:把原生成列的类型与排序规则写进函数索引表达式
CREATE INDEX idx_employee_name_new
ON employees (
  (CAST(data->>'$.name' AS CHAR(64)) COLLATE utf8mb4_bin)
);

-- 用 EXPLAIN 检查候选索引,实际 key 与访问类型以本库输出为准
EXPLAIN SELECT id
FROM employees
WHERE data->>'$.name' = 'James';
确认新索引承担了预期查询后,再安排删除旧索引和生成列。不要在同一条未经验证的变更里先删旧结构再建新结构;生产表上的 DDL 锁、构建时长、磁盘空间和回滚窗口也应纳入变更计划。
回归检查不要只看“创建成功”
一个函数索引的验收至少包括以下五类检查:
- 版本范围:确认实例支持函数索引;MySQL 8.0.13 起才支持函数索引键部分。
- DDL 结构:使用
SHOW CREATE TABLE或数据字典确认索引定义、长度和排序规则符合预期。 - 执行计划:对等值、范围、
IN等真实查询运行EXPLAIN,检查possible_keys、key、访问类型和预估行数。 - 结果语义:准备大小写、空值、缺失 JSON 路径、超长字符串和非法数字等边界数据,比较迁移前后结果集合。
- 写入代价:索引会在插入和更新时计算表达式并维护 BTREE;读性能收益要与写入、空间和 DDL 成本一起评估。
-- 查看表结构中的函数索引定义,确认类型与排序规则
SHOW CREATE TABLE employees;

-- 更新持久化统计信息,便于优化器评估新索引
ANALYZE TABLE employees;

-- 分别检查实际业务中的等值查询和范围查询
EXPLAIN SELECT id FROM employees
WHERE data->>'$.name' = 'James';
EXPLAIN 没选择新索引,不一定代表索引定义错误。小表、低选择性条件、统计信息或成本估算都可能让全表扫描更便宜。先确认表达式确实匹配,再判断成本模型;不要用强制索引掩盖类型或排序规则不一致。
迁移清单
- 确认函数索引支持范围,并记录当前 MySQL 版本与存储引擎。
- 写下原表达式的实际返回类型,不凭字段名称猜测。
- 为字符串确定最大有效长度、字符集和排序规则。
- 为数字和日期清理不能安全转换的历史数据。
- 保证索引与查询使用同一 JSON 路径、同一转换类型和同一长度。
- 用边界样本比较结果集合,特别检查大小写、空值、缺失路径和超长值。
- 在自己的数据量与分布上运行
EXPLAIN,不照搬示例里的执行计划判断。 - 确认新索引稳定后再删除旧生成列或旧索引,并保留回滚脚本。
几个容易混淆的问题
所有函数索引都必须写 CAST 吗?
不需要。像 ABS(int_column) 这类结果类型明确且可索引的表达式可以直接建立函数索引。只有结果类型过宽、不适合索引,或者需要固定业务比较语义时,显式转换才是关键。
把 LONGTEXT 转成 CHAR(255) 就一定合理吗?
不一定。255 只是常见长度,不是业务结论。长度过大会增加索引空间,过小可能截断或造成值冲突。应根据字段契约、字符集字节数和存储引擎索引键限制选择。
为什么索引创建成功,查询还是不用?
先检查查询表达式是否与索引定义一致,包括 JSON 路径、函数参数、转换类型、长度和排序规则。若这些都一致,再检查数据分布、统计信息和成本估算。优化器选择全表扫描有时是合理结果。
函数索引和多值索引是一回事吗?
不是。本文讨论的是普通表达式函数索引。JSON 数组的多值索引使用 CAST(json_expression AS type ARRAY),用途、限制和可用运算符都不同,不应把两套写法混在一起。
归根结底,显式 CAST 的价值是把“表达式算出来什么”变成一份明确的数据契约。只要类型、长度、字符集、排序规则和查询表达式对齐,函数索引才真正从“能创建”走到“可预测地使用”。
-
332 收藏
-
374 收藏
-
398 收藏
-
499 收藏
-
384 收藏
-
352 收藏
-
178 收藏
-
441 收藏
-
413 收藏
-
283 收藏
-
224 收藏
-
319 收藏
-
401 收藏
-
394 收藏
-
376 收藏
-
243 收藏
-
228 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习