
Sentence Transformers 怎么截断嵌入维度减少存储
来源:17golang原创
时间:2026-10-06 20:59:28 165浏览 收藏
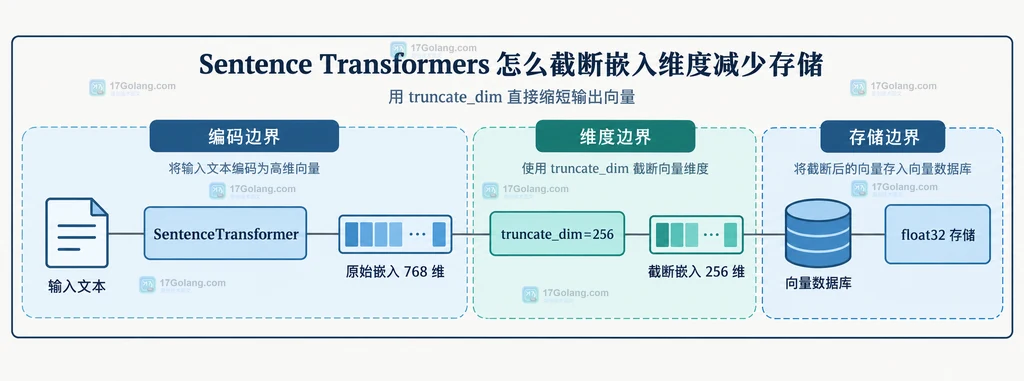
Sentence Transformers 可以在加载模型或调用 encode() 时设置 truncate_dim,让返回的稠密嵌入只保留前 N 个维度。要真正减少存储,必须把截断后的向量重新写入文件或向量数据库,并让查询端与文档端使用相同模型、相同提示词规则和相同维度。
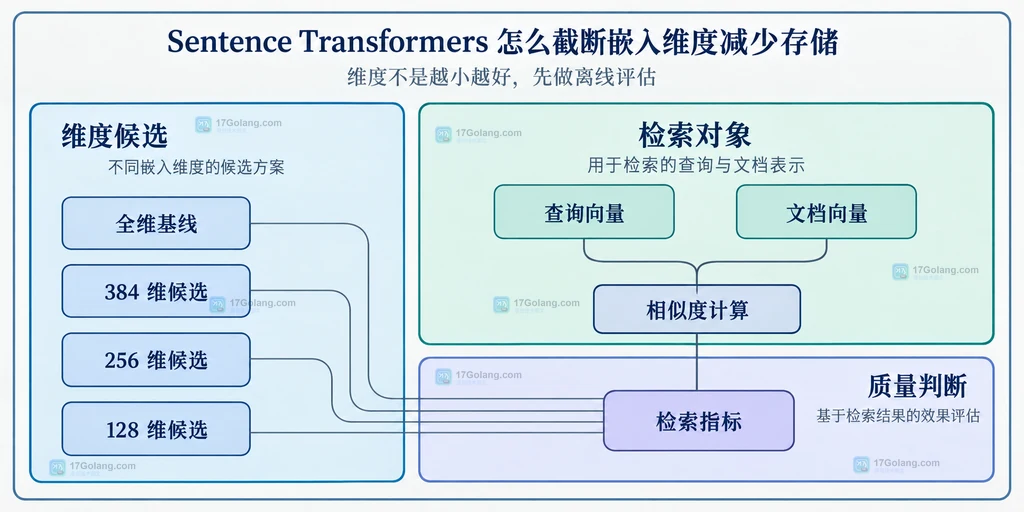
这项能力最适合专门按 Matryoshka Representation Learning 训练的模型。普通嵌入模型也能被切片,但有效信息未必集中在前部,维度越小,检索质量可能下降得越快。因此,正确做法不是直接把 768 改成 64,而是把存储预算换算成候选维度,再用真实检索集做离线比较。
官方地址:https://sbert.net/
截断改变的是向量宽度,不是模型大小
一次文本编码可以拆成两部分理解:模型先得到完整句向量,随后 Sentence Transformers 只返回前 truncate_dim 个元素。较短向量占用更少磁盘或内存,点积、余弦相似度和向量索引的下游处理量也随维度下降。
但官方 Matryoshka 文档特别说明,较短输出不会让模型本身变小,也不会让模型的训练或前向推理自动变快、变省显存。收益发生在“嵌入已经生成之后”:网络传输、持久化、索引驻留和相似度计算,而不是 Transformer 编码器内部。
| 项目 | 截断后是否通常减少 | 说明 |
|---|---|---|
| 单条向量原始字节数 | 是 | 与维度近似线性相关 |
| 向量索引内存 | 通常是 | 还取决于索引结构和元数据 |
| 相似度计算量 | 是 | 参与计算的元素减少 |
| 模型权重体积 | 否 | 截断没有删除模型层或参数 |
| 模型前向推理时间 | 不一定 | 完整编码过程仍然存在 |
用 truncate_dim 直接缩短输出向量
近期 Sentence Transformers API 允许在 encode() 中传入 truncate_dim。按调用设置更灵活:同一个模型实例可以为离线精排输出完整向量,也可以为大规模召回输出较短向量。
from sentence_transformers import SentenceTransformer

# 选用明确支持 Matryoshka 截断的模型
model = SentenceTransformer("tomaarsen/mpnet-base-nli-matryoshka")

documents = [
    "向量数据库如何控制索引内存",
    "文本嵌入可以用于语义检索",
]

# 文档端直接生成 256 维向量,避免先持久化完整维度
doc_vectors = model.encode_document(
    documents,
    truncate_dim=256,
    normalize_embeddings=True,
)

# 查询端必须采用相同维度和归一化规则
query_vector = model.encode_query(
    "怎样减少嵌入存储",
    truncate_dim=256,
    normalize_embeddings=True,
)

# shape 是最直接的本地检查点
assert doc_vectors.shape[1] == 256
assert query_vector.shape[0] == 256
如果模型没有区分 query/document 提示词,encode() 也可以完成同样的维度控制;信息检索任务若模型带有查询与文档提示词,则优先用 encode_query() 和 encode_document()。不要让文档用 256 维而查询仍是 768 维,向量数据库通常会直接拒绝维度不一致的数据。
已有向量可以统一截断,但要处理归一化
历史数据已经生成完整向量时,可以用官方的 truncate_embeddings() 批量取得前 N 维。若原始向量曾归一化,直接截短后向量长度通常不再等于 1;要继续使用点积模拟余弦相似度,应在截断后重新归一化。
import numpy as np
from sentence_transformers.util import truncate_embeddings

def truncate_and_normalize(vectors: np.ndarray, dim: int) -> np.ndarray:
    # 官方工具按指定维度截断 NumPy 数组或 PyTorch Tensor
    shortened = truncate_embeddings(vectors, truncate_dim=dim)

    # 截断会改变向量范数,点积检索前重新归一化
    norms = np.linalg.norm(shortened, axis=1, keepdims=True)
    safe_norms = np.maximum(norms, 1e-12)  # 防止除以零
    return shortened / safe_norms
这段迁移逻辑只适合模型输出的单向量句嵌入。Sentence Transformers 的多向量、晚交互编码器按 token 向量计算 MaxSim,官方文档明确指出相关评估器不支持这种 Matryoshka 式 truncate_dim,不要把两类表示方式混用。
先算清能省多少原始存储
不考虑索引图、主键、对齐和数据库元数据时,稠密向量的理论存储量可以用下面的关系估算:
原始字节数 = 向量条数 × 维度 × 每个元素字节数
例如 100 万条 float32 向量,每个元素 4 字节:768 维约为 2.86 GiB,256 维约为 0.95 GiB,原始向量部分下降约三分之二。实际向量数据库占用会更高,因为还包括索引连接、文档 ID、元数据、删除标记和复制副本。
def raw_vector_gib(count: int, dimension: int, bytes_per_value: int = 4) -> float:
    # 这里只估算连续向量数据,不包含索引和数据库元数据
    total_bytes = count * dimension * bytes_per_value
    return total_bytes / (1024 ** 3)

# 对比同一批 float32 向量的理论体积
full_size = raw_vector_gib(1_000_000, 768)
short_size = raw_vector_gib(1_000_000, 256)
print(f"768维约 {full_size:.2f} GiB,256维约 {short_size:.2f} GiB")
若还需要进一步压缩,可以在确定维度后再评估 int8、uint8、binary 或 ubinary 精度。Sentence Transformers 的编码接口提供这些精度选项,但“降维”和“量化”是两个独立变量,应分开做质量对照,否则无法判断损失来自哪一项。
维度不是越小越好,先做离线评估
Matryoshka 模型在训练时会同时约束多个前缀维度,目标是把更重要的信息前置,因此比普通模型更适合截断。它仍然不是无损压缩:主题、语言、文本长度和检索难度变化后,最合适的维度也会变化。
实战中可固定同一批查询、候选文档和相关性标注,先记录完整维度的 Recall@K、MRR 或 nDCG,再测试 384、256、128 等候选。选择“满足业务质量门槛的最短维度”,而不是选择绝对最短维度。没有人工标注时,至少保留一批线上高频查询及已知正确文档,并人工检查截断前后 Top K 排名变化。
迁移时新建索引,不要原地改维度
多数向量数据库在创建集合或索引时就固定维度,已有 768 维集合通常不能直接塞入 256 维向量。更稳妥的迁移方式是新建 256 维集合,按批次重新编码或截断文档向量,校验条数和检索指标,再把查询流量切换过去;旧索引保留一段回滚窗口。
- 确认模型卡或官方文档是否说明支持 Matryoshka 截断。
- 在真实样本上比较完整维度与多个候选维度。
- 按目标维度新建索引,并统一查询端与文档端配置。
- 核对向量条数、维度、归一化方式、距离函数和 Top K 结果。
- 切换读流量,观察质量与延迟,再决定何时删除旧索引。
几个容易混淆的问题
truncate_dim 会让 SentenceTransformer 模型更小吗?
不会。它缩短输出向量,不会移除 Transformer 层或权重。模型文件、模型加载内存和前向编码成本不会按输出维度同比下降。
普通模型可以直接从 768 维截到 128 维吗?
代码上可以切片,但质量没有保证。优先选择模型卡明确支持 Matryoshka 的模型,并用自己的检索数据评估;不能把某个官方示例模型的结果外推到所有模型。
应该在构造模型时设置,还是每次 encode 时设置?
整个服务只用一种维度时,可在构造 SentenceTransformer 时设置 truncate_dim;同一模型实例服务多种场景时,在 encode()、encode_query() 或 encode_document() 调用中设置更清楚。调用参数优先于模型默认值。
为什么截断后相似度变了?
因为向量丢掉了后部维度,方向和范数都可能改变。手动截断归一化向量后还要重新归一化;即便归一化一致,信息减少也可能改变排名,所以离线检索指标是最终判断依据。
小结
减少 Sentence Transformers 嵌入存储的关键不是简单切掉数组尾部,而是选择支持截断的模型、统一查询与文档维度、重新处理归一化、按公式估算空间,并用真实检索指标确定最低可接受维度。完成评估后新建目标维度索引迁移,既能获得明确的存储收益,也保留可回滚的质量边界。
参考资料:https://sbert.net/docs/package_reference/sentence_transformer/model.html、https://sbert.net/docs/package_reference/util/tensor.html、https://sbert.net/examples/sentence_transformer/training/matryoshka/README.html
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
454 收藏
-
358 收藏
-
328 收藏
-
科技周边 · 人工智能 | 9小时前 | python · 人工智能 · shuffle Hugging Face Datasets streaming IterableDataset buffer_size470 收藏
-
308 收藏
-
309 收藏
-
175 收藏
-
359 收藏
-
499 收藏
-
164 收藏
-
291 收藏
-
372 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习