
周末工坊记录
保留这段正文。
来源:17golang原创
时间:2026-10-13 15:35:43 305浏览 收藏
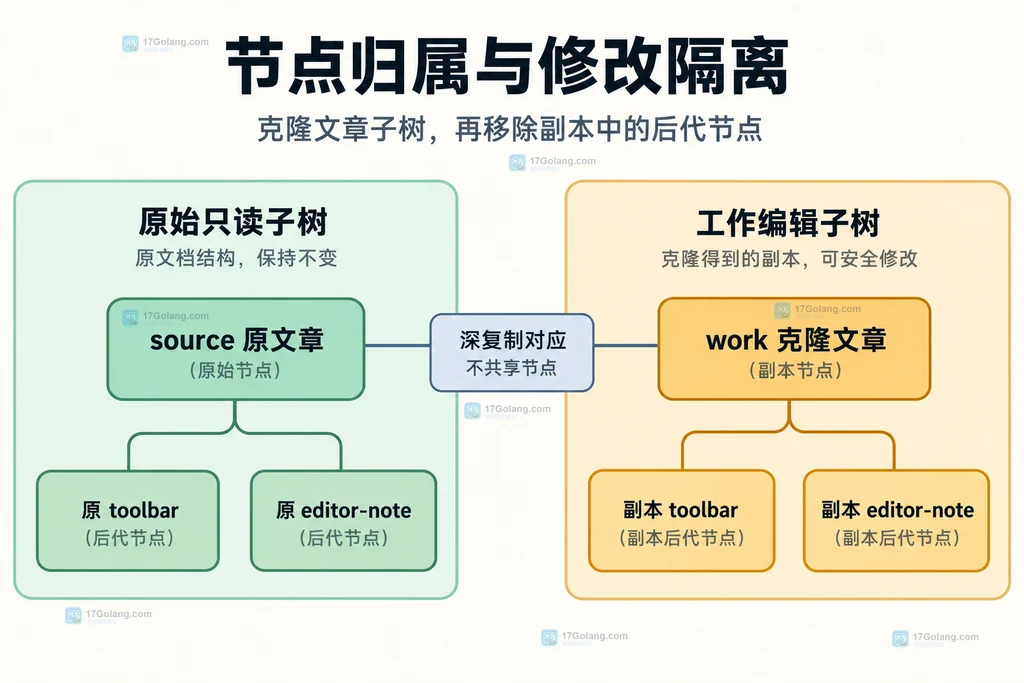
要在 goquery 副本中删节点而保留原文档,先对需要编辑的选择集调用 Clone(),再从克隆结果中 Find(...).Remove()。直接赋值选择集变量,或重新从原文档查一次相同节点,都不会产生独立的 HTML 节点树。如果要修改整份文档,则使用 goquery.CloneDocument(doc)。
官方地址:https://github.com/PuerkitoBio/goquery
假设一份页面需要生成两种内容:归档版本保留作者备注,阅读版本去掉工具栏和备注。共同输入应保持不变,每个导出任务只编辑自己的工作副本。问题不在于变量名称是否不同,而在于选择集是否仍然引用同一批底层节点。
例如 work := source 只是另一个引用。即使复制 Selection 结构体,节点指针仍可能共享。原文档上一次删除操作会改变后续导出看到的内容,这类依赖调用顺序的问题不能靠“换一个变量名”解决。Selection 的节点组成可参阅 官方类型实现。
本例只导出一个 article,所以把克隆范围限定在文章子树,避免每个小任务都复制页面导航、页脚等无关内容。这里是结构上的取舍,不是对实际吞吐量的测试结论。
下面的完整程序使用内存 HTML,不发起网页请求。source 来自原文档,work 来自 Clone。辅助节点只在 work 范围内查找和移除。示例代码为原创,未在本文环境执行;输出语句和计数条件供读者自行运行比较。
package main
import (
"fmt"
"strings"
"github.com/PuerkitoBio/goquery"
)
func main() {
input := `周末工坊记录
保留这段正文。
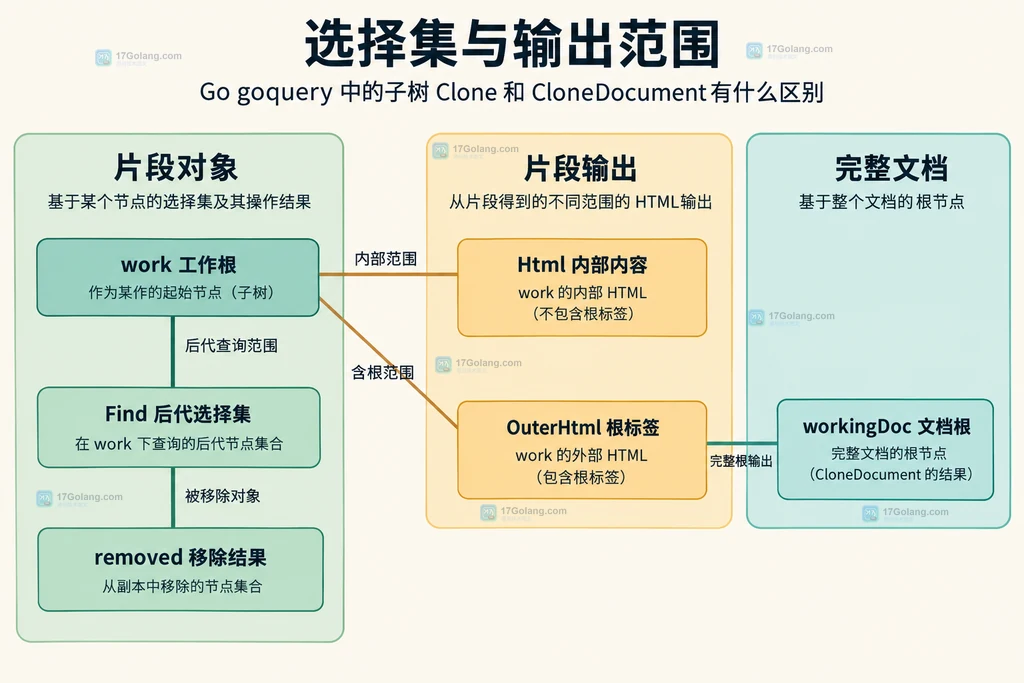
对这个输入,按代码逻辑应移除两个副本后代,原文辅助节点计数仍为两个,副本为零。不要把这些预期值当作本文实测日志。Remove() 返回被移除节点的选择集,而不是清理后的 article。因此结果必须从 work 序列化,不能把 removed 当成最终文章。
官方 Clone 与 Remove 实现明确区分了深复制和从父节点脱离的操作。克隆节点不自动插入原文档;在克隆子树内部移除后代,不需要把克隆根重新挂回页面。
Selection.Clone 适合处理选中的片段;完整文档还包含文档根以及查询上下文。如果工作需要同时编辑 head、body 和多个区域,可使用完整文档克隆,并从克隆文档重新取得后续选择集:
// 此片段接在doc解析成功后;不要复用原doc上的Selection。
workingDoc := goquery.CloneDocument(doc)
workingDoc.Find(".toolbar, .editor-note").Remove()
page, err := goquery.OuterHtml(workingDoc.Selection)
if err != nil {
    fmt.Println("页面序列化失败:", err)
    return
}
fmt.Println(page)
完整克隆的节点根实现参阅 CloneDocument 源码。不要把 Clone() 理解为“所有关联信息都变成独立文档”:克隆选择集仍有关联的文档上下文。在片段模式下,保持查询相对于 work,避免使用会访问文档根的操作重新接触原始节点。
| 处理范围 | 选择 | 注意点 |
|---|---|---|
| 一个文章片段 | source.Clone() | 从work查找并输出片段 |
| 整页多个区域 | CloneDocument(doc) | 从workingDoc取得选择集 |
| 多个选中根节点 | 选择集Clone | OuterHtml只输出第一项,需逐项处理 |
复制隔离的代价是额外节点和内存占用。只需要文章时复制文章,确实需要整页时再复制文档;尽量选择互不重叠的根,避免同时复制父节点和它的后代形成重复工作。具体节省多少,应由真实输入规模和项目测量判断,不在这里编造指标。
保留原树只读,每个编辑任务使用独立副本,是一种清楚的职责划分。但不能让多个 goroutine 同时编辑同一棵工作树,也不能在原树正被修改时把克隆当成一致性快照。克隆不是并发锁。任务完成后不要长期保存 removed 等节点选择集;它们仍引用节点,移除不等于立即释放内存。
如果下游接受 HTML 片段,OuterHtml 可以保留文章根;需要完整页面时输出完整文档。序列化方法和第一项范围可参阅 官方序列化工具实现。HTML 解析和重新输出也不承诺字节级保持原文本,原始字节归档应另存输入。
本例 Find 用于寻找后代。如果筛选条件针对选择集自身,应使用 Filter 等筛选方式;克隆根已经脱离原文档,没有父节点时 Remove 不能把它从某个父树里再删除。
检查删除操作是否实际使用 doc.Find 或 source.Find,或者复用了克隆之前取得的辅助节点选择集。删除目标必须重新从 work 或 workingDoc 中取得。
不是。本例仅按业务选择器移除指定节点,不提供通用安全净化能力。不要把版面裁剪用于替代面向不可信HTML的专门处理。
保留原文档的关键是节点归属:明确哪棵树只读、哪棵树可编辑,再限定选择器和序列化范围。变量分开只是表面,节点深复制才是隔离这次删除操作的核心。




