
Go arm64 性能下降怎样区分代码和编译器因素
来源:17golang原创
时间:2026-10-14 08:37:14 231浏览 收藏
Go 程序在 arm64 上变慢时,先不要把锅甩给编译器。更可靠的办法是固定同一份源码、输入规模、基准命令和运行方式,先做 amd64/arm64 对照;如果差异只在 arm64 出现,再在同一台 arm64 机器上替换 Go 工具链,最后用 CPU profile 和内存 profile 判断热点究竟落在业务代码、标准库、运行时还是编译器生成的代码上。
这篇文章讨论的是诊断路径,不给出“arm64 一定更慢”或“换 Go 版本一定能解决”的结论。Go 官方诊断文档把 profiling、tracing 和运行时统计列为不同工具,实际排查时也应一次只改变一个变量。
官方资料:https://go.dev/doc/diagnostics
先固定可比较的基线
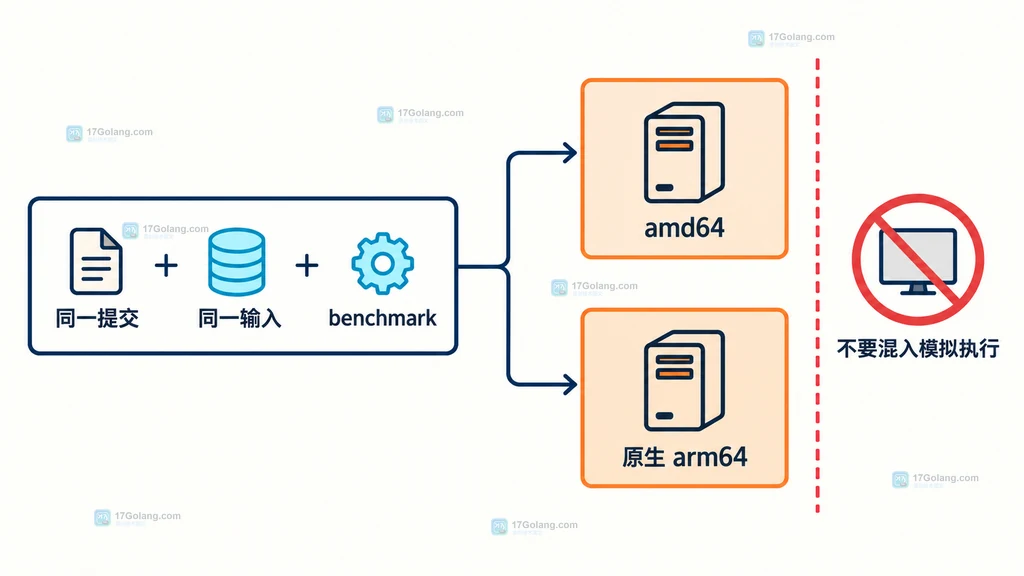
性能对比最怕一次改了太多东西:源码提交不同、Go 版本不同、输入数据不同,甚至一个环境是原生 arm64、另一个环境是模拟执行。先把这些变量写进基准记录,后面的结论才有可比性。
# 记录工具链、目标平台和 cgo 状态,先确认两台机器的比较边界。
go version
go env GOOS GOARCH CGO_ENABLED GOAMD64

# 固定测试选择,避免把普通测试耗时混进 benchmark。
go test ./... -run '^$' -bench '^BenchmarkTransform$' -benchmem -count=10 \
  -benchtime=3s | tee bench.txt
这里的 -count=10 是为了减少单次调度噪声,-benchmem 用来观察每次操作的分配次数和字节数。不要只看 ns/op:如果 arm64 的耗时上升同时伴随分配量变化,优先检查代码路径;如果分配量近似不变但 CPU 时间变化明显,再看编译器生成代码和运行时热点。
| 要固定的变量 | 记录方式 | 不固定的风险 |
|---|---|---|
| 源码与输入 | 提交号、数据规模、随机种子 | 把数据分布变化误判为架构差异 |
| 工具链 | go version、编译参数、依赖锁定 | 把编译器回归误判为业务改动 |
| 运行方式 | 原生 arm64、容器限制、是否启用 cgo | 把模拟或资源配额开销算到 Go 代码 |
| 统计方法 | 固定 -count、-benchtime 与 profile 时长 | 用一次偶然结果做发布决策 |
用同一基准做 amd64 与 arm64 对照
Go 工具链支持 arm64 目标,但“能交叉编译”不等于“能在当前机器上执行”。交叉编译得到的 arm64 测试二进制必须放到原生 arm64 环境运行;在 amd64 上借助模拟器执行时,模拟器开销会混入结果,不能用来判断 Go 代码本身的架构差异。
# 在原生 amd64 机器上记录基准;源码、输入和命令保持不变。
GOOS=linux GOARCH=amd64 go test ./... -run '^$' \
  -bench '^BenchmarkTransform$' -benchmem -count=10 -benchtime=3s

# 只负责生成 arm64 测试二进制,不在 amd64 上直接解释它的耗时。
GOOS=linux GOARCH=arm64 go test -c -o transform-arm64.test ./...

# 将同一测试二进制放到原生 arm64 主机,再使用相同参数运行。
./transform-arm64.test -test.run '^$' -test.bench '^BenchmarkTransform$' \
  -test.benchmem -test.count=10 -test.benchtime=3s
如果同一提交、同一工具链在原生 arm64 上稳定慢,而 amd64 正常,结论只能先写成“架构相关差异”,还不能直接写成“编译器 bug”。它可能来自 CPU 微架构、内存层级、系统调用、cgo 依赖或标准库对不同指令集的选择。
在同一台 arm64 机器上对比工具链
要判断编译器或运行时因素,下一步把硬件固定下来,只切换 Go 工具链。最小实验是用两个明确版本分别构建同一提交,并在同一台 arm64 主机上重复同一基准。每次切换后都记录 go version,不要依赖 PATH 的模糊状态。
# 旧工具链和新工具链分别构建同一提交,输出文件名保持可追溯。
/opt/go-old/bin/go version
/opt/go-old/bin/go test -c -o bench-old.test ./...

/opt/go-new/bin/go version
/opt/go-new/bin/go test -c -o bench-new.test ./...

# 两个二进制在同一台原生 arm64 主机上运行相同的 benchmark。
./bench-old.test -test.run '^$' -test.bench '^BenchmarkTransform$' \
  -test.benchmem -test.count=10 -test.benchtime=3s | tee old.txt
./bench-new.test -test.run '^$' -test.bench '^BenchmarkTransform$' \
  -test.benchmem -test.count=10 -test.benchtime=3s | tee new.txt
若性能下降只跟随新工具链出现,并且多次运行都能复现,编译器、运行时或标准库实现才值得进入候选列表。此时不要急着改业务代码,先保留两套二进制和基准原始输出,方便后续用 profile 比较具体热点。
也要注意编译参数会改变问题本身。比如 -race、调试符号、CGO 设置和链接方式都可能改变耗时;它们可以用于诊断,但不能把带诊断开销的结果和生产构建直接横向比较。
用 CPU 与内存 profile 定位归因
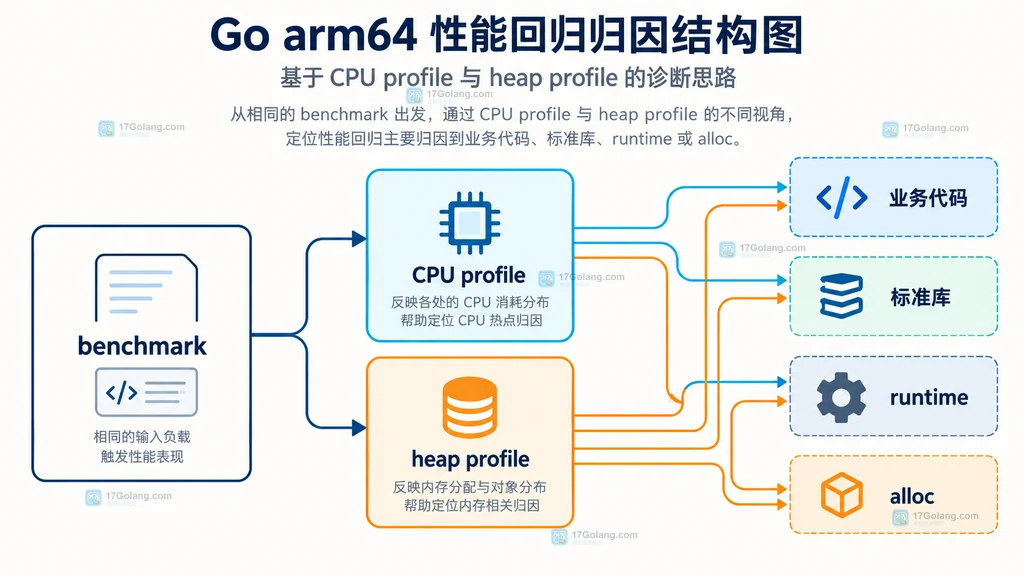
benchmark 只告诉你“慢了多少”,profile 才能告诉你“时间花在哪里”。Go 官方文档建议用 CPU profile 观察主动消耗 CPU 的函数,用 heap profile 观察分配样本;不同 profile 可能互相干扰,所以建议分开采集。
# 先单独采集 CPU profile,避免同时启用会改变调度的其它 profile。
go test ./... -run '^$' -bench '^BenchmarkTransform$' \
  -benchtime=30s -cpuprofile=cpu-arm64.out

# 以文本方式查看热点,先判断是业务函数还是 runtime/标准库占主导。
go tool pprof -top ./bench.test cpu-arm64.out

# 再单独采集内存 profile,观察分配来源而不是沿用 CPU 结论。
go test ./... -run '^$' -bench '^BenchmarkTransform$' \
  -benchtime=30s -memprofile=mem-arm64.out -memprofilerate=1
go tool pprof -top -alloc_space ./bench.test mem-arm64.out
可以按下面的信号做初步归因:
| profile 信号 | 更应该先检查 | 下一步 |
|---|---|---|
| 业务函数占 CPU 大头 | 分支、循环、锁和数据布局 | 保持输入不变,做小范围代码对照 |
| runtime 或调度函数明显升高 | 并发度、阻塞、GC 和系统调用 | 单独采集 trace 或运行时统计 |
| 分配量显著增加 | 逃逸、临时对象、字符串/切片转换 | 查看编译器优化诊断与 alloc_space |
| 标准库或 cgo 符号占主导 | 指令集选择、外部库和系统调用 | 做指令集开关或纯 Go 对照 |
做一次指令集与优化对照
如果热点集中在标准库或运行时,可以把可选指令集作为一个控制变量。Go 诊断文档列出了 GODEBUG=cpu.all=off 以及按扩展名关闭指令集的方式。这个实验的目的,是观察性能差异是否依赖可选指令路径,而不是建议线上永久关闭优化。
# 只作为对照运行,记录与默认环境的差异;不要直接当生产配置。
GODEBUG=cpu.all=off go test ./... -run '^$' \
  -bench '^BenchmarkTransform$' -benchmem -count=10 -benchtime=3s

# 查看编译器对内联和逃逸的判断,输出用于解释分配变化。
go test -gcflags='all=-m=2' ./... 2> compiler-notes.txt

# 禁用优化与内联只用于定位调试边界,不用于宣称真实性能。
go test -gcflags='all=-N -l' ./... -run '^$' \
  -bench '^BenchmarkTransform$' -count=3
如果关闭可选指令后两种架构的差距明显收窄,说明指令集路径值得继续查;如果只有禁用优化后差距消失,说明优化生成代码可能参与其中,但这仍需要用汇编、工具链版本和更小的复现用例确认。不要因为某个对照结果变好,就把 -N -l 或 cpu.all=off 带进正式发布。
发布前按证据做决定
最后把结果整理成一张小表,避免团队在“代码问题”和“编译器问题”之间凭感觉争论。
| 观察结果 | 优先结论 | 处理动作 |
|---|---|---|
| 两架构都慢,业务热点相同 | 更像代码或输入变化 | 优化热点路径并补 benchmark |
| 只在 arm64 慢,同一工具链可复现 | 架构、硬件或指令集路径 | 在另一台原生 arm64 复现并做指令集对照 |
| 同一 arm64 机器只在新工具链慢 | 工具链/运行时候选 | 保留最小复现,比较版本并评估回滚 |
| 热点从业务函数转到 runtime 或分配 | 生成代码或内存行为变化 | 结合 -m=2、profile 和汇编继续缩小范围 |
| 只在模拟环境慢 | 执行方式影响结果 | 以原生 arm64 结果作为发布依据 |
这套方法的核心是一次只改一个变量:先把架构差异和工具链差异分开,再把“慢”拆成 CPU 时间、分配、调度和指令集路径。这样即使最后没有发现编译器回归,也能留下可复用的 arm64 基准和 profile,而不是只得到一句“这台机器比较慢”。
相关问题
交叉编译成功后可以直接用 amd64 的 benchmark 结果代表 arm64 吗?不可以。交叉编译只生成目标二进制,性能必须在原生 arm64 环境测量;模拟执行的额外开销也应单独标注。
CPU profile 和 heap profile 能同时采集吗?可以尝试,但不建议用同一次采集做精确归因。先分别采集,再比较两份结果,避免一个诊断工具改变另一个工具观察到的行为。
发现新 Go 工具链变慢后应该立即回滚吗?先确认同一提交、同一输入、同一原生 arm64 主机可复现,并保留最小基准和 profile;如果影响发布指标,再按团队的回滚策略处理。
-
418 收藏
-
423 收藏
-
445 收藏
-
384 收藏
-
266 收藏
-
151 收藏
-
103 收藏
-
176 收藏
-
374 收藏
-
272 收藏
-
243 收藏
-
364 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习