
Python sqlite3 怎样在线备份数据库
来源:17golang原创
时间:2026-10-18 02:02:15 355浏览 收藏
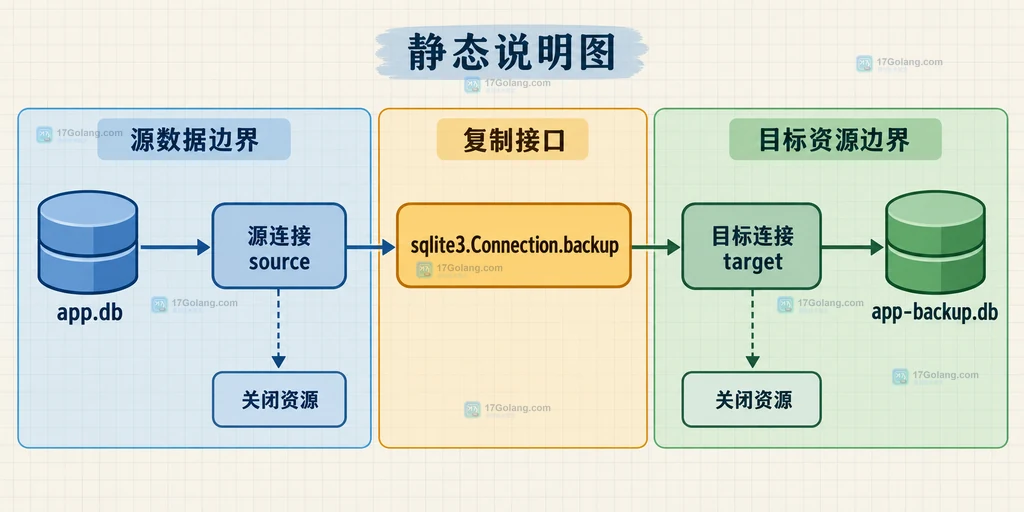
需要给正在运行的 SQLite 数据库做备份时,不建议直接对数据库文件做普通复制。Python 的 sqlite3.Connection.backup() 调用了 SQLite Online Backup API,可以把源连接的内容复制到另一个目标连接;目标通常是独立的备份文件,源库仍可被其他连接访问。
官方文档:https://docs.python.org/3/library/sqlite3.html
- 方法方向是
source.backup(target),不是把目标写回源库。 pages控制每轮复制的页数,sleep控制剩余页之间的等待。- 目标连接要单独打开;备份完成后关闭目标和源连接,再独立打开目标文件检查。
最小备份配方:源连接指向目标连接
在线备份的关键不是“复制一个文件”,而是先准备两个连接:源连接打开正在使用的数据库,目标连接打开新的备份路径。目标文件如果已经存在,其内容会被备份过程覆盖,因此不要把源路径误写到目标变量中。
import sqlite3

source = sqlite3.connect("app.db")
target = sqlite3.connect("app-backup.db")
try:
    # 每轮复制 100 页,给其他连接留下更短的读锁占用窗口
    source.backup(target, pages=100, sleep=0.1)
finally:
    # 先关闭目标,再关闭源,确保文件句柄和事务资源释放
    target.close()
    source.close()
这里的调用方向是 source.backup(target)。如果把它反过来,得到的是把备份文件覆盖回源连接的操作,语义就变成恢复或覆盖,风险完全不同。
分页、进度与锁竞争怎么配
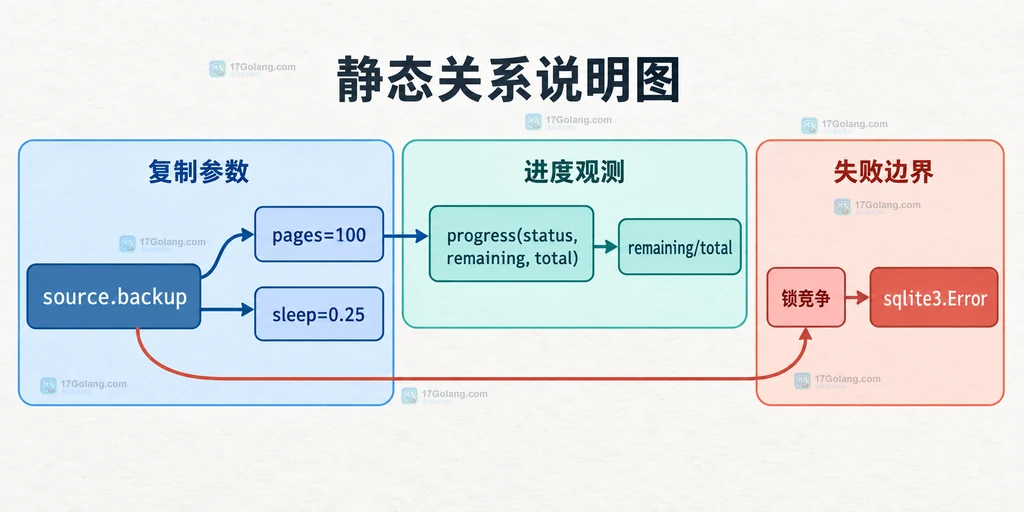
默认 pages=-1 会尽量一次完成全部复制;数据库较大或线上写入较频繁时,可用正数分页。progress 回调每轮收到三个整数:上轮状态、剩余页数和总页数。它适合记录日志或更新进度,不应该在里面执行写库业务。
import sqlite3

def show_progress(status, remaining, total):
    # remaining 与 total 都是页数;避免 total 为 0 时除零
    percent = 100.0 if total == 0 else (total - remaining) * 100 / total
    print(f"备份进度:{percent:.1f}%(剩余 {remaining}/{total} 页,状态 {status})")

source = sqlite3.connect("app.db", timeout=5.0)
target = sqlite3.connect("app-backup.db", timeout=5.0)
try:
    # pages 越小越容易让出读锁,但总调用次数也会增加
    source.backup(target, pages=100, progress=show_progress, sleep=0.25)
except sqlite3.Error as exc:
    # 把锁冲突、路径错误等 SQLite 异常交给上层记录和重试策略
    raise RuntimeError(f"SQLite 备份失败:{exc}") from exc
finally:
    target.close()
    source.close()
timeout 只是连接遇到锁时的等待边界,不是备份总超时。若源库持续高频写入,分页备份可能需要更久;这时应记录失败原因并安排重试,而不是在回调中强行修改源库。
备份完成后的独立检查与常见坑
备份调用返回后,建议重新打开目标文件做轻量检查,例如读取一张确定存在的表。检查连接必须是新的连接,这样能确认目标文件确实可以被再次打开,而不是只确认内存中的对象还活着。
import sqlite3

check = sqlite3.connect("app-backup.db")
try:
    # 用参数绑定表名之外的固定 SQL,检查目标库是否能读取
    row = check.execute("SELECT count(*) FROM records").fetchone()
    print(f"备份可读,records 行数:{row[0]}")
finally:
    # 检查完成后仍要释放独立连接
    check.close()
几个边界需要记住:目标连接不能与源连接是同一个对象;目标已有数据会被覆盖;name 默认只备份 main,使用 ATTACH DATABASE 时要明确指定附加库名称;内存数据库也可以作为源或目标,但目标生命周期只存在于该连接存活期间。
把调用封装成可复用函数
如果备份是定时任务的一部分,可以把路径、分页和等待参数集中到一个函数,调用方只处理成功或异常。不要在函数内部吞掉 sqlite3.Error,否则锁冲突和目标路径错误会被误判成成功。
from pathlib import Path
import sqlite3

def backup_sqlite(source_path: str, target_path: str) -> None:
    # 目标路径必须与源路径分开,避免把源库当成恢复目标
    if Path(source_path).resolve() == Path(target_path).resolve():
        raise ValueError("源库和备份目标不能是同一路径")
    source = sqlite3.connect(source_path, timeout=5.0)
    target = sqlite3.connect(target_path, timeout=5.0)
    try:
        # 以分页方式复制,适合仍有读写请求的应用数据库
        source.backup(target, pages=200, sleep=0.1)
    finally:
        target.close()
        source.close()
这套写法解决的是“在线复制到独立 SQLite 文件”。它不替代异地存储、备份保留策略和恢复演练;真正上线时,还要为目标文件命名、保留周期和失败告警建立单独规则。
相关问题
pages 设置越大越好吗?不一定。页数越大,调用轮次越少;页数越小,单轮占用更短。应结合数据库大小和写入压力调整。
为什么备份目标会被覆盖?backup() 的语义是让目标连接获得源库内容,因此目标已有内容不是增量合并结果。需要保留历史版本时,应先生成不同的目标文件名。
-
346 收藏
-
235 收藏
-
387 收藏
-
447 收藏
-
360 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习