
Go archive/zip 怎样读取 ZIP 条目的 Extra 字段
来源:17golang原创
时间:2026-10-18 06:48:30 385浏览 收藏
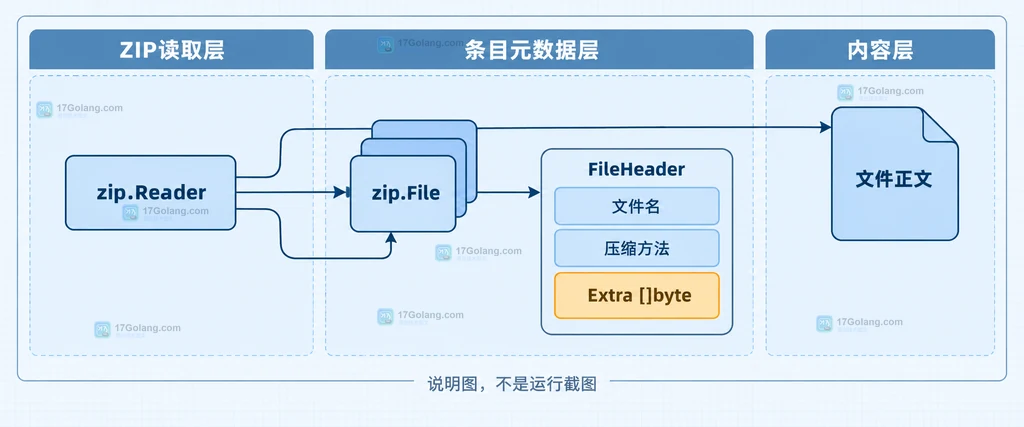
在 Go 里读取 ZIP 条目的扩展字段,入口就是 zip.FileHeader.Extra。它保存的是该条目的 Extra 区域原始字节,不是解压后的文件正文;因此通常先遍历 zip.Reader.File,再对每个 FileHeader 做一次有边界检查的 TLV 解析。
官方文档:https://pkg.go.dev/archive/zip
把 Extra 当作“条目元数据字节流”处理:先确认每个字段的头部和长度都完整,再读取数据;遇到不认识的字段可以跳过,遇到截断则返回格式错误。
- 读取位置:
f.FileHeader.Extra,不需要先打开文件正文。 - 遍历单位:一个 Extra 区域可以连续放多个字段,不能把整段字节直接当成一个值。
- 安全边界:每个字段至少需要 4 个字节的 ID 和长度,长度必须落在当前切片范围内。
先明确 Extra 与 ZIP 条目的关系
archive/zip 的 File 嵌入了 FileHeader,而 FileHeader.Extra 的类型是 []byte。这意味着标准库负责把条目元数据读出来,但不会替业务解释所有扩展字段。文件名、压缩方法、时间和 Extra 属于不同元数据;调用 f.Open() 读取的是正文,和 Extra 没有先后依赖。
按 TLV 边界读取一组 Extra 字段
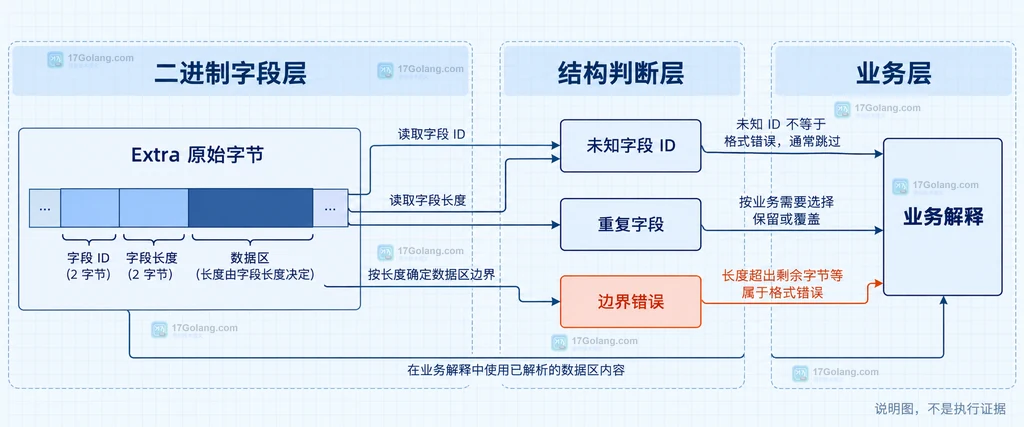
ZIP Extra 区域通常按连续字段组织:前 2 个字节是字段 ID,接着 2 个字节是数据长度,后面紧跟数据区。长度和 ID 的具体含义由相应扩展规范定义;解析器的通用职责是切出完整字段,并把未知 ID 原样交给上层或跳过。
package main

import (
    "encoding/binary"
    "fmt"
)

// ExtraField 表示一个已经通过边界检查的 ZIP 扩展字段。
type ExtraField struct {
    ID   uint16
    Data []byte
}

// parseExtra 按小端序读取 ID 和长度;它不猜测未知 ID 的业务含义。
func parseExtra(extra []byte) ([]ExtraField, error) {
    const headerSize = 4 // 每个字段由2字节ID和2字节数据长度组成。
    fields := make([]ExtraField, 0, 2)
    for offset := 0; offset  len(extra)-dataStart {
            return nil, fmt.Errorf("extra字段数据不完整: id=0x%04x", id)
        }
        fields = append(fields, ExtraField{ID: id, Data: extra[dataStart:dataEnd]})
        offset = dataEnd
    }
    return fields, nil
}

func main() {
    // 0xCAFE 字段包含两个字节;这里仅演示解析,不表示真实业务扩展。
    raw := []byte{0xfe, 0xca, 0x02, 0x00, 0x01, 0x02}
    fields, err := parseExtra(raw)
    if err != nil {
        fmt.Println("解析失败:", err)
        return
    }
    for _, field := range fields {
        // 业务层再按 field.ID 决定是否解释 Data。
        fmt.Printf("ID=0x%04x 数据长度=%d\n", field.ID, len(field.Data))
    }
}
示例只展示通用拆包,不运行也不宣称某个 ID 的标准语义。Data 是原始区域的切片视图;如果要把它保存到异步任务或修改底层缓冲区,应复制一份,避免让数据生命周期依赖原始 ZIP 读取缓冲。
未知字段、重复字段和截断输入怎么处理
读取 Extra 时最容易犯的错,是看见一个熟悉的 ID 就假设它一定是唯一字段。更稳妥的做法是先得到完整字段列表,再由业务决定:未知 ID 跳过或记录,重复 ID 按规范决定取首个、最后一个还是全部保留,缺少业务需要的字段再单独返回“未找到”。不要把“未知”误报成“格式错误”。
| 情况 | 解析层动作 | 业务层判断 |
|---|---|---|
| 头部少于4字节 | 返回格式错误 | 停止读取该条目 |
| 长度超过剩余数据 | 返回格式错误 | 不要猜测截断字段内容 |
| 未知字段 ID | 保留或跳过 | 不影响其他字段解析 |
| 同一 ID 多次出现 | 全部保留 | 按扩展规范决定合并规则 |
上面的长度检查使用“剩余字节数”比较,而不是依赖加法后再检查结果。虽然字段长度来自无符号的 16 位值,但解析器仍应让边界条件清晰,避免未来改成更大长度或拼接多个区域时引入整数问题。
接到 archive/zip 条目遍历中
解析器可以在遍历条目时调用。这个流程只读取中央目录中已经暴露的 FileHeader.Extra,不需要打开压缩正文;只有业务还需要文件内容时,才在后续对 f.Open() 负责关闭的读取器。
// inspectEntries 只检查条目元数据,不读取每个文件的正文。
func inspectEntries(r *zip.Reader) error {
    for _, f := range r.File {
        fields, err := parseExtra(f.FileHeader.Extra)
        if err != nil {
            return fmt.Errorf("条目 %q 的Extra无效: %w", f.Name, err)
        }
        for _, field := range fields {
            // 未知字段先记录 ID;不要在这里擅自解释所有扩展协议。
            fmt.Printf("%s: extra=0x%04x bytes=%d\\n", f.Name, field.ID, len(field.Data))
        }
    }
    return nil
}
如果使用 zip.OpenReader,记得在调用方关闭返回的 ReadCloser。条目名称安全策略、ZIP64 尺寸字段和正文校验是另外的职责,不要因为成功解析 Extra 就推断整个压缩包内容可信。本文只讨论 Extra 字段读取和边界。
常见问题
Extra 字段是文件正文的一部分吗?
不是。它属于 ZIP 条目的扩展元数据,读取 FileHeader.Extra 不等于读取或解压文件正文。
可以直接把 Extra 转成字符串吗?
不建议。Extra 是二进制字段集合,可能包含长度、数值或其他编码;应先按字段 ID 和长度拆分,再按对应规范解释。
遇到不认识的字段 ID 要报错吗?
通常不必在通用解析层报错。只要结构边界完整,未知字段可以保留或跳过;只有业务明确要求某个字段而它缺失时,才返回业务层错误。
实际使用时可以把解析器保持在一个小边界内:archive/zip 负责发现条目和提供 Extra 原始字节,通用解析器负责安全拆包,具体扩展规范再决定字段含义。这样既能兼容未知字段,也不会把截断数据误当成有效元数据。
-
860 收藏
-
843 收藏
-
826 收藏
-
809 收藏
-
792 收藏
-
272 收藏
-
333 收藏
-
252 收藏
-
Golang · Go教程 | 49分钟前 | 错误处理 · Go教程 · database/sql · Go commit 事务 rollback database/sql sql.Tx BeginTx249 收藏
-
171 收藏
-
Golang · Go教程 | 54分钟前 | Go教程 · database/sql · Go database/sql rows.Next Rows.Scan sql.RawBytes 二进制字段159 收藏
-
477 收藏
-
485 收藏
-
335 收藏
-
366 收藏
-
287 收藏
-
200 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习