
前端 Intl.Segmenter 怎样按语言边界切分文本
来源:17golang原创
时间:2026-10-20 03:02:34 432浏览 收藏
前端需要按语言边界处理搜索高亮、字数统计、光标移动或摘要截取时,不要先假设“一个 JavaScript 字符就是一个用户感知字符”,也不要用空格切分所有语言。更稳妥的做法是创建 Intl.Segmenter,把文本语言放进 locales,再根据任务选择 grapheme、word 或 sentence。
真正决定结果的是语言规则和分词粒度。中文、日文等没有空格分隔单词的语言,应使用对应 locale 的 word 分词;如果运行环境没有这个能力,就明确降级,不要把简单的空格切分伪装成等价结果。
grapheme:按用户感知的字符边界处理删除、计数和光标移动。word:按语言规则得到词片段,适合搜索高亮和词数统计。sentence:按句子边界拆分摘要或段落。index:是原字符串中的 UTF-16 code unit 下标,不是自然语言字符序号。
先区分字符、单词和句子边界
String.prototype.split(" ") 只认识空格,遇到中文、日文、泰文等文本时通常只能得到整段字符串;split("") 也只是按 UTF-16 code unit 拆分,复杂 emoji 可能被拆成无法单独显示的部分。Intl.Segmenter 返回的是可迭代的 Segments 对象,每一项至少包含原文片段和它在输入字符串中的位置。
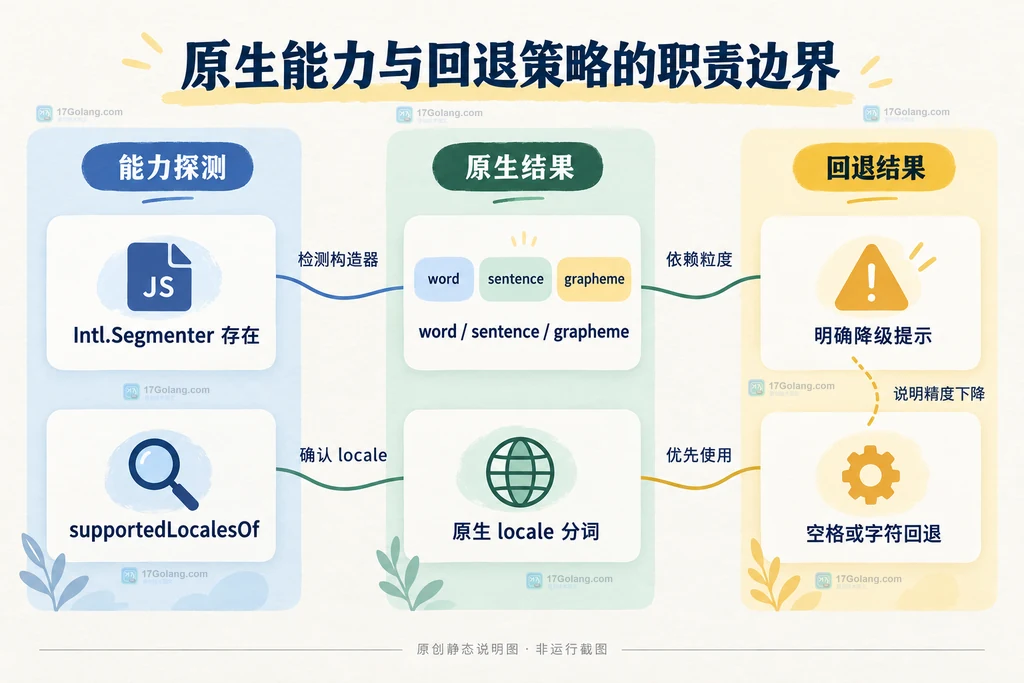
因此,先写清楚业务要数什么,再选粒度:限制昵称长度通常需要 grapheme,提取中文关键词通常需要 word,按完整句子生成摘要则用 sentence。不要把三种结果混在同一个工具函数里。
按语言和粒度创建 Segmenter
构造器的第一个参数接受 locale,第二个参数通过 granularity 指定边界层级。下面的例子保留每个分词对象,调用方可以决定是否过滤空格、标点和非词片段。
/**
 * 按语言和粒度返回可序列化的分词项。
 * 关键点:word 粒度可能包含空格和标点,不能只读取 segment 文本。
 */
function segmentText(text, locale = "zh-CN", granularity = "word") {
  if (typeof Intl.Segmenter !== "function") {
    throw new Error("当前运行环境不支持 Intl.Segmenter");
  }

  const segmenter = new Intl.Segmenter(locale, { granularity });
  return Array.from(segmenter.segment(text), (item) => ({
    text: item.segment,
    index: item.index,
    // isWordLike 只在 word 粒度下有业务意义,其他粒度不要据此判断。
    isWordLike: granularity === "word" ? item.isWordLike === true : undefined,
  }));
}

const words = segmentText("前端 Intl.Segmenter 按语言切分文本", "zh-CN", "word");
console.log(words.filter((item) => item.isWordLike));
对 word 结果使用 isWordLike 过滤时,保留空格和标点的原始片段仍然有价值:如果要把结果重新拼回原文,应该保留全部片段;如果只是做关键词高亮,可以只取 isWordLike === true 的项。
把分词结果转换成业务数据
实际项目常见的分歧是“展示全部边界”还是“只展示词”。可以把这两个动作拆开,先统一生成对象,再在业务层过滤,这样搜索高亮不会丢失原始位置,字符计数也不会误用词粒度。
/**
 * 生成适合搜索高亮的词片段;不改变原文,只移除非词片段。
 */
function wordTokens(text, locale) {
  const segmenter = new Intl.Segmenter(locale, { granularity: "word" });
  return Array.from(segmenter.segment(text))
    .filter((item) => item.isWordLike)
    .map((item) => ({
      value: item.segment,
      start: item.index,
      end: item.index + item.segment.length,
    }));
}

const tokens = wordTokens("搜索中文和 English 文本", "zh-CN");
// start 与 end 使用 UTF-16 下标,可直接交给 slice 做原文截取。
const first = tokens[0];
const originalPart = first ? "搜索中文和 English 文本".slice(first.start, first.end) : "";
console.log({ tokens, originalPart });
这里的 end 用 item.segment.length 计算,和 JavaScript 的 slice 保持同一套 UTF-16 下标规则。如果业务需要“用户看到的第几个字符”,应另外用 grapheme 粒度计数,不能直接拿 end - start 当作视觉字符数。
处理能力探测与回退
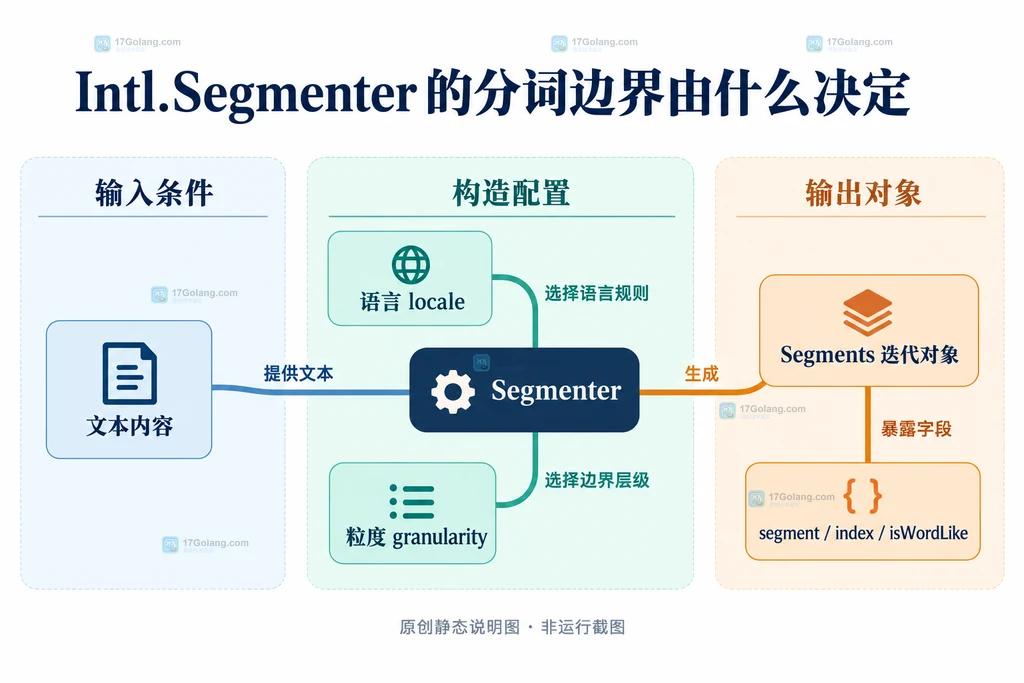
MDN 将 Intl.Segmenter 标记为 Baseline 2024,但老设备、旧浏览器或特殊运行时仍可能没有构造器。回退代码要把“原生语言分词”和“近似拆分”区分开:前者可以做精细边界,后者只提供保底行为。
/**
 * 能力不足时返回可解释的降级结果;空格回退不宣称等同于语言分词。
 */
function safeWordSegments(text, locale = "zh-CN") {
  if (typeof Intl.Segmenter !== "function") {
    return {
      supported: false,
      precise: false,
      items: text.trim() ? text.trim().split(/\s+/u) : [],
      reason: "Intl.Segmenter 不可用,仅按空白近似切分",
    };
  }

  const supported = Intl.Segmenter.supportedLocalesOf([locale]).length > 0;
  // 即使 locale 需要回退,仍让运行时选择可用的本地化规则。
  const segmenter = new Intl.Segmenter(locale, { granularity: "word" });
  const items = Array.from(segmenter.segment(text));
  return {
    supported,
    precise: true,
    items,
    reason: supported ? "使用请求的 locale" : "locale 由运行时回退",
  };
}
supportedLocalesOf 只回答给定 locale 是否能在不回退到运行时默认 locale 的情况下支持;它不是“能不能构造 Segmenter”的替代品,所以仍要先检查构造器。对于中文、日文等文本,如果精确分词是核心功能,可以在产品层提示用户升级环境或加载经过评估的 polyfill,而不是静默返回看似准确的词数。
用 containing 和 index 做定位
当编辑器、搜索框或长文本阅读器需要根据光标位置找出当前片段时,可以使用 segment() 返回的 Segments 对象的 containing(index)。传入的仍是 UTF-16 code unit 下标,因此要和 DOM Range、JavaScript slice 或字符串长度的计数约定保持一致。
/**
 * 找出包含某个 UTF-16 下标的文本片段;越界位置返回 null。
 */
function segmentAt(text, locale, index) {
  const segmenter = new Intl.Segmenter(locale, { granularity: "word" });
  const segments = segmenter.segment(text);
  return segments.containing(index) ?? null;
}

const hit = segmentAt("中文搜索词", "zh-CN", 2);
console.log(hit ? { text: hit.segment, start: hit.index } : "没有对应片段");
如果项目还要支持老环境,建议把能力探测放在初始化层,业务代码只接收统一的数据结构;这样切分、回退和提示逻辑不会散落在每个组件里。
常见问题
Intl.Segmenter 能直接替代 split(" ") 吗?
不能简单视为替换。它解决的是按 locale 和粒度识别边界,结果包含空格、标点或非词片段;需要关键词时应根据 isWordLike 再过滤。
中文分词应该使用哪个 locale?
可从文本或用户设置得到 zh-CN、zh-TW 等 locale,并保持整个功能链路一致。locale 不是把文本翻译成另一种语言,而是选择分词规则。
grapheme 能用来统计中文词数吗?
不能。grapheme 面向用户感知字符,中文词数应使用 word,而且是否把标点和空白计入结果要由业务明确决定。
为什么 index 和用户看到的字符位置不一致?
JavaScript 字符串下标按 UTF-16 code unit 计算,部分 emoji 或组合字符可能占用多个 code unit。需要用户感知字符边界时,使用 grapheme 得到的片段长度更符合界面语义。
-
130 收藏
-
120 收藏
-
168 收藏
-
233 收藏
-
306 收藏
-
284 收藏
-
432 收藏
-
464 收藏
-
379 收藏
-
295 收藏
-
182 收藏
-
150 收藏
-
204 收藏
-
114 收藏
-
306 收藏
-
184 收藏
-
404 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习