
AI 输出过滤怎样与业务规则分层
来源:17golang原创
时间:2026-10-20 04:18:16 400浏览 收藏
AI 应用最容易混乱的地方,不是模型能不能生成答案,而是答案生成后到底能不能交付。一个回复可能没有明显安全风险,却缺少订单号;也可能字段完整,但包含业务不允许展示的内容。把这些情况都塞进一个“输出过滤器”,最终只能得到一个模糊的失败状态。
更稳妥的分层是:安全过滤先判断“能不能展示”,结构与业务规则再判断“是否符合当前场景”,最后由交付层决定直接返回、重试还是人工复核。Hugging Face 官方文档入口:https://huggingface.co/docs。这里的入口用于查阅模型与推理组件文档,业务规则仍应由应用服务自己持有。
模型输出过滤负责风险边界,业务规则负责领域正确性,两者要分开记录、分开处理,不能用一个布尔值代替全部判断。
为什么安全过滤通过了,结果仍然不能交付
安全过滤通常关注敏感内容、越权指令、隐私泄露或明显不适合展示的文本,它回答的是“这段内容是否可以继续流转”。业务规则关注的则是必填字段、状态机、权限范围、金额或时间约束,它回答的是“这段内容是否适合当前业务动作”。
例如,模型返回一份售后建议,文本本身没有风险,但缺少工单号,或者把“待审核”写成了“已退款”。这不是安全过滤失败,而是业务校验失败。如果两类问题都记成 blocked,运营人员无法知道应该改提示词、重试模型,还是修正业务数据。
把拒绝结果拆成可追踪的三层状态
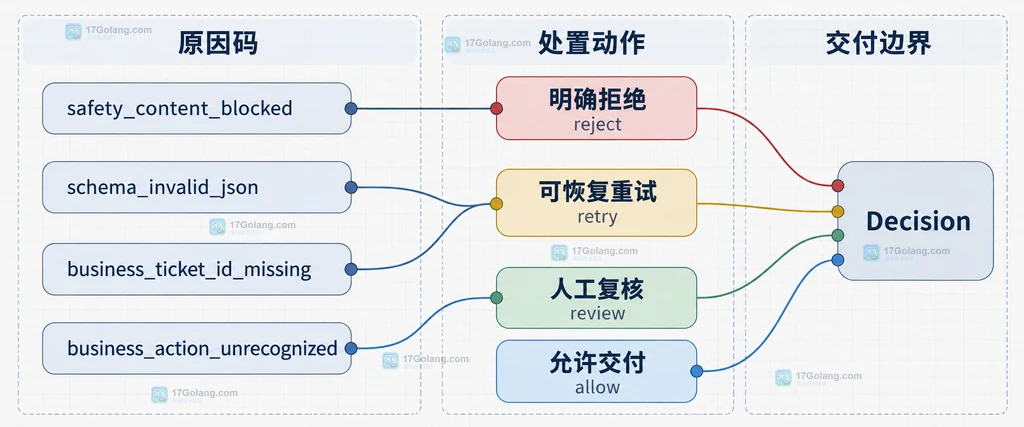
可以把一次输出处理拆成三个相邻层次。第一层是 safety,只负责内容风险;第二层是 schema,负责把模型文本解析为约定结构;第三层是 business,负责领域规则。每层都返回状态和原因,交付层再把它们合成为用户可理解的结果。
常见状态可以这样设计:allow 表示通过,reject 表示明确不能继续,retry 表示输入或格式可修复,review 表示需要人工判断。不要让底层把“字段缺失”直接变成“违规”,否则重试策略会被错误触发。
一个最小的分层实现
下面的示例故意不绑定某个模型厂商。model_output 可以来自本地模型、远程推理服务或一个已经完成的聊天模板调用;门禁层只接收文本,并把每一步的原因保留下来。
from dataclasses import dataclass
import json

@dataclass
class Decision:
    # status 只表达当前层的处置动作,reason 用于日志和重试分流。
    status: str
    reason: str
    data: dict | None = None

def safety_filter(text: str) -> Decision:
    # 这里只放内容风险规则,不判断订单、权限等业务字段。
    forbidden = ("泄露密钥", "绕过审核")
    if any(word in text for word in forbidden):
        return Decision("reject", "safety_content_blocked")
    return Decision("allow", "safety_passed")

def business_check(data: dict) -> Decision:
    # 业务层只验证当前场景需要的字段和状态,不重复做内容审查。
    if not data.get("ticket_id"):
        return Decision("retry", "business_ticket_id_missing", data)
    if data.get("action") not in {"reply", "escalate"}:
        return Decision("review", "business_action_unrecognized", data)
    return Decision("allow", "business_passed", data)

def gate(model_output: str) -> Decision:
    # 先做安全门禁,再解析结构,最后执行领域规则。
    safety = safety_filter(model_output)
    if safety.status != "allow":
        return safety
    try:
        payload = json.loads(model_output)
    except json.JSONDecodeError:
        # 格式错误通常可以带约束重试,不应被误报成安全违规。
        return Decision("retry", "schema_invalid_json")
    return business_check(payload)
这个顺序有两个好处:安全拒绝不会进入业务动作,结构错误也不会污染安全指标。实际项目还应把请求标识、规则版本和模型版本写入日志,但不要把原始敏感输出无条件写入普通日志。
哪些结果应该重试,哪些结果应该拦截
可以用原因码决定后续动作,而不是根据总状态猜测:
safety_content_blocked:直接拒绝或转人工,不能只靠再次调用模型绕过。schema_invalid_json:可以带更明确的结构约束重试,并设置次数上限。business_ticket_id_missing:优先补充上下文或让模型重新生成,不要把缺失字段自动填成未知值。business_action_unrecognized:交给人工或业务负责人确认,避免把未知动作映射到默认动作。
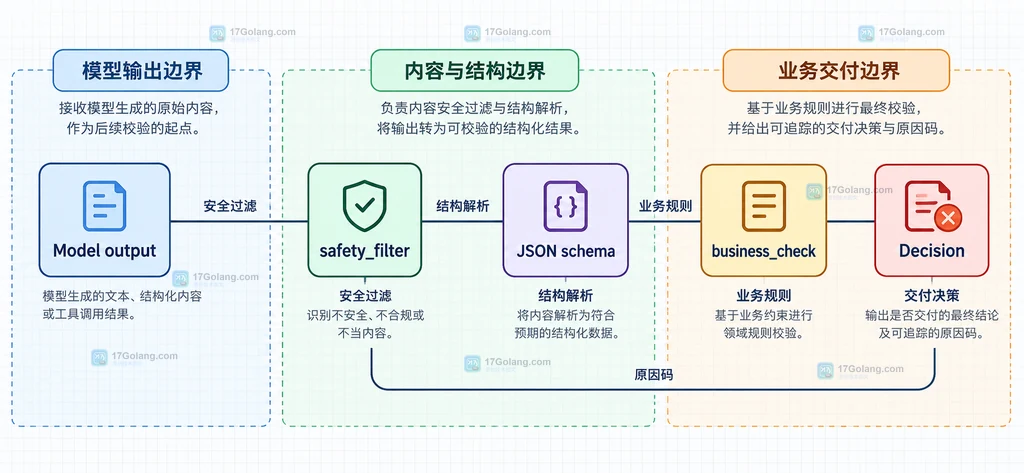
如果同一请求连续重试仍然只有格式错误,应结束重试并返回可解释的失败;如果安全层明确拒绝,则应保留拒绝原因和规则版本,方便后续复盘。重试是修复可恢复错误的机制,不是绕过安全层的通道。
落地时最容易踩的三个边界
第一,不要把提示词里的“请输出 JSON”当成结构保证,最终仍要在服务端解析并处理异常。第二,不要让业务校验重新实现一套内容安全词表,否则规则会分叉;安全规则应有独立版本。第三,不要只记录最终的 blocked 或 success,至少保留层级、原因码和处置动作。
上线前可以准备四组固定样例:正常结构且业务通过、含敏感内容、合法文本但 JSON 损坏、字段完整但业务状态冲突。每次更换模型或规则版本时重放这四组样例,就能看出变化发生在安全层、结构层还是业务层。
相关问题
安全过滤应该放在模型前还是模型后? 输入侧可以拦截明显危险请求,输出侧仍要保留,因为模型可能生成不符合业务的内容;两侧职责不同。
业务规则能不能直接写进提示词? 提示词适合说明期望格式和语义,但权限、状态和交付条件必须在服务端再次判断,不能把模型自报结果当成事实。
总结来说,安全过滤决定内容能否继续流转,结构校验决定结果是否可解析,业务规则决定结果是否可交付。把三层状态和原因码保留下来,重试、人工复核与运营排查才有明确入口。
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
314 收藏
-
419 收藏
-
199 收藏
-
400 收藏
-
288 收藏
-
484 收藏
-
444 收藏
-
286 收藏
-
229 收藏
-
443 收藏
-
218 收藏
-
416 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习