
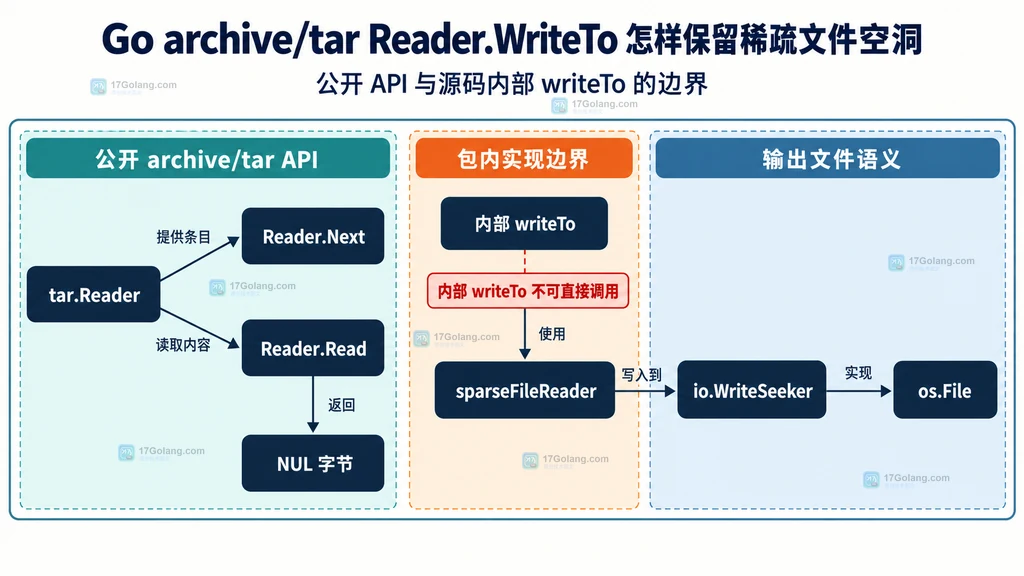
先说结论:当前 Go 标准库 archive/tar 的公开 tar.Reader 没有可直接调用的 Reader.WriteTo 方法。你在源码里看到的 writeTo 是包内实现,用来让稀疏文件读取器在具备 io.WriteSeeker 能力时跳过空洞;它不是业务代码可以调用的导出 API。
官方地址:https://pkg.go.dev/archive/tar
因此,“怎样保留稀疏文件空洞”要先拆成两个问题:普通公开 API 能读出什么,以及你的程序是否另外掌握空洞位置元数据。没有第二份元数据时,Reader.Read 会把稀疏空洞表现为 NUL 字节,直接写到普通文件后通常得到的是逻辑内容,而不是自动保留的稀疏布局。
Reader.WriteTo 为什么搜得到,却不能直接调用
官方文档列出的公开读取入口是 NewReader、Next 和 Read。源码内部还维护了文件读取器的 WriteTo(io.Writer) 能力,并由未导出的 writeTo 转发给当前条目。这两层名称相似,但可见性完全不同。
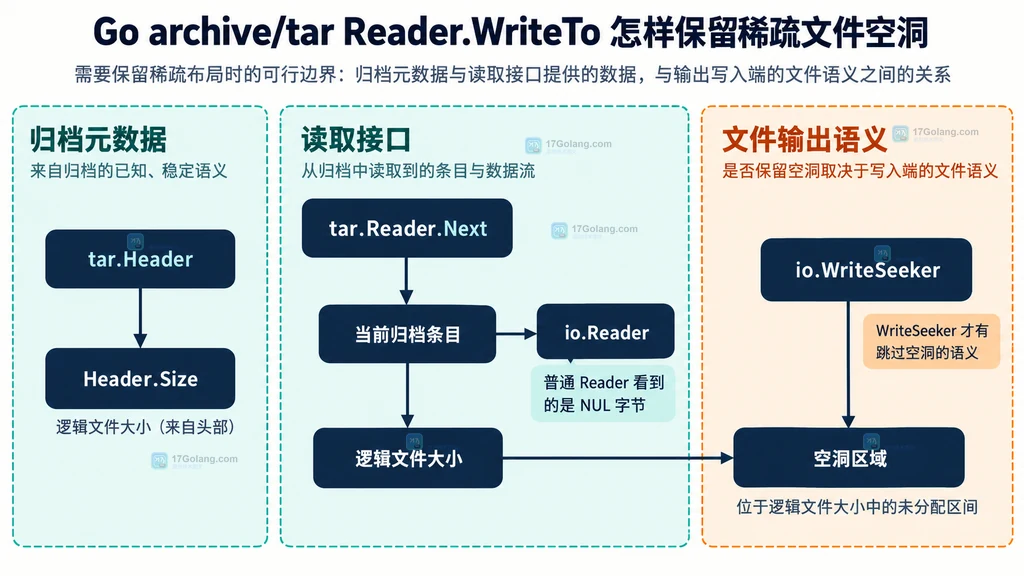
tar.Reader对外提供顺序读取;调用方可以用Next定位条目,再用Read消费内容。- 内部的稀疏文件读取器知道空洞片段,在目标实现
io.WriteSeeker时才有机会用定位跳过空洞。 - 包外代码不能调用未导出的
writeTo,也不能把源码内部的稀疏片段读取器当作公开类型断言出来。
Reader.Read 对稀疏空洞的实际语义
稀疏文件的空洞在逻辑文件中占据位置,但归档数据里不一定存有同样数量的零字节。archive/tar 的公开读取语义是:当当前文件稀疏时,空洞区域通过 Reader.Read 读回 NUL 字节。
这意味着调用 io.Copy 时,读取器会把逻辑内容连续写给目标。目标是普通 io.Writer 时,它不会因为“这些字节原本是空洞”而自动调用 Seek。这也是很多解包后文件看起来内容正确、但占用空间变大的原因。
公开 API 下的普通解包写法
如果目标只是把归档中的一个普通文件解包到可信的固定路径,直接使用 Next 和 Read 即可。下面的示例故意不调用不存在的 Reader.WriteTo,并把关闭目标文件放在复制结果之后。
package main

import (
	"archive/tar"
	"fmt"
	"io"
	"os"
)

func extractRegularEntry(r io.Reader, targetPath string) error {
	tr := tar.NewReader(r)
	for {
		hdr, err := tr.Next()
		if err == io.EOF {
			return fmt.Errorf("找不到普通文件条目")
		}
		if err != nil {
			return fmt.Errorf("读取 tar 头失败: %w", err)
		}
		// 这里只处理普通文件,目标路径由可信调用方提前确定。
		if hdr.Typeflag != tar.TypeReg {
			continue
		}

		out, err := os.OpenFile(targetPath, os.O_CREATE|os.O_WRONLY|os.O_TRUNC, 0600)
		if err != nil {
			return fmt.Errorf("打开目标文件失败: %w", err)
		}
		// Reader.Read 会把稀疏空洞按 NUL 字节提供给 io.Copy。
		_, copyErr := io.Copy(out, tr)
		closeErr := out.Close() // 复制完成后立刻释放文件描述符。
		if copyErr != nil {
			return fmt.Errorf("写出归档内容失败: %w", copyErr)
		}
		if closeErr != nil {
			return fmt.Errorf("关闭目标文件失败: %w", closeErr)
		}
		return nil
	}
}
这段代码能正确还原逻辑内容,但它没有承诺还原物理稀疏性。不要仅凭文件大小相同就判断磁盘块占用也相同;逻辑长度和实际分配块数是两个指标。
想保留空洞,先确认手里有没有空洞元数据
保留稀疏布局需要知道“哪些区间是空洞”。只有目标支持 io.WriteSeeker 并不够:如果调用方不知道空洞的起止位置,就没有安全依据可以跳过哪一段。
可以按下面的边界判断:
| 手里的信息 | 可以做什么 | 不能据此推断什么 |
|---|---|---|
只有 tar.Reader 和 io.Reader | 读取逻辑内容并写成普通文件 | 不能自动知道每段 NUL 是否原本是空洞 |
| 另有可信的空洞区间元数据 | 在 io.WriteSeeker 目标上设计跳过空洞的恢复层 | 不能把这层能力归因给公开的 Reader.WriteTo |
只看到了 Go 源码内部 writeTo | 理解标准库内部优化的实现边界 | 不能在包外通过同名方法调用它 |
最容易踩到的三个判断错误
把源码内部 writeTo 当成导出方法
如果编译器提示 tar.Reader 没有 WriteTo,这不是调用姿势少了一个参数,而是公开 API 根本没有这个方法。应回到 Next 与 Read 的公共接口。
把 NUL 字节等同于“原本一定是空洞”
读取结果中的 NUL 只是逻辑字节值。它可能来自稀疏空洞,也可能就是文件内容本身。没有可靠的空洞元数据时,按零字节猜测并跳过会改变文件语义。
把逻辑长度等同于磁盘占用
普通文件和稀疏文件可以拥有相同的逻辑长度,却使用不同数量的磁盘块。需要比较空间占用时,应由文件系统工具或平台 API 单独测量,不能从 Header.Size 一项推导。
排查清单:先问能力,再选实现
- 确认代码调用的是公开的
tar.Reader方法,而不是源码中的未导出符号。 - 确认需求是“内容正确”还是“物理稀疏布局也要保留”。
- 如果只要内容,使用
Next、Read和普通输出文件即可。 - 如果要保留空洞,先找到可信的空洞区间来源,再设计可定位的输出层。
- 分别记录逻辑大小和实际分配空间,避免把两者混成一个结果。
总结
Go archive/tar Reader.WriteTo 怎样保留稀疏文件空洞 的关键答案不是补一个调用参数,而是认清 API 边界:公开 Reader 没有可调用的 WriteTo,源码内部 writeTo 也不能被包外复用;公开 Read 会把稀疏空洞呈现为 NUL 字节。普通解包可以直接完成,真正的稀疏布局恢复则需要独立、可信的空洞元数据与可定位输出能力。
相关问题
为什么解包后的文件内容一样,磁盘占用却更大? 因为连续写入 NUL 字节会物化原来的空洞,逻辑内容相同不代表分配块数相同。
能不能自己给 tar.Reader 增加 WriteTo 方法? 可以在自己的包装类型上定义方法,但它只能使用公开读取结果;如果没有空洞区间元数据,包装方法也不能可靠恢复原始稀疏布局。




