
我在处理一段来自文档字段的二进制内容时,第一次看到 ASCII85 文本,直觉是“把尖括号去掉,再交给解码器”。这个思路只对了一半:Go 的 encoding/ascii85 负责把编码字符还原成字节,但常见的 <~ 和 ~> 包装标记需要由调用方先处理。输入很短时用 Decode 最直接,输入来自文件或网络流时则应该用 NewDecoder。
官方地址:https://pkg.go.dev/encoding/ascii85
ASCII85 是编码,不是加密。正确做法是先明确输入边界,再选择一次性或流式解码,并始终检查实际写入字节数和错误。
先把输入边界分清楚
ASCII85 通常用五个可打印字符表示四个字节,常见文本还会在外面包一层 <~ 与 ~>。标准库的 Decode 不会替调用方剥离这两个标记;它会忽略空格和控制字符,但遇到非法编码字符会返回 CorruptInputError。
这一步在工程上很重要:如果上游协议规定了包装标记,业务层就应当先检查首尾,再把中间内容交给库。不要把“能解出几个字节”当作输入完整有效。
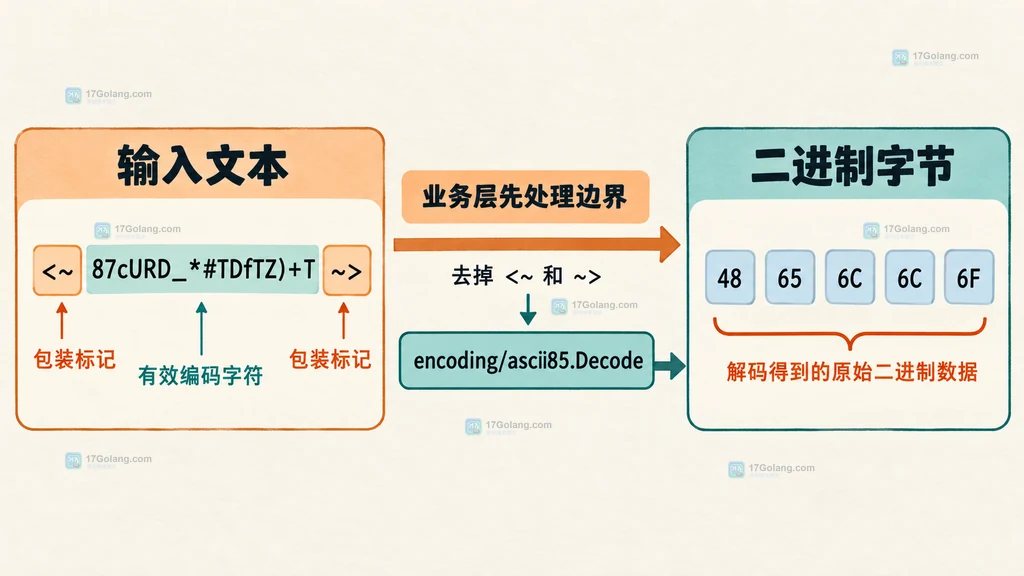
短文本用 Decode 读取写入数
ascii85.Decode 接收目标缓冲区、输入缓冲区和 flush 参数,返回写入目标的字节数、消耗的输入字节数以及错误。小块数据可以先去掉包装,再按 MaxEncodedLen 估算目标容量。
package main

import (
	"encoding/ascii85"
	"fmt"
	"strings"
)

func decodeText(text string) ([]byte, error) {
	// 先处理协议层包装,避免把 <~ 和 ~> 当成 ASCII85 数据传入库。
	text = strings.TrimSpace(text)
	if strings.HasPrefix(text, "<~") || strings.HasSuffix(text, "~>") {
		if !strings.HasPrefix(text, "<~") || !strings.HasSuffix(text, "~>") {
			return nil, fmt.Errorf("ASCII85 包装标记不完整")
		}
		text = strings.TrimSuffix(strings.TrimPrefix(text, "<~"), "~>")
	}

	src := []byte(text)
	// MaxEncodedLen 是上限估算;实际结果以 n 为准,不能直接使用整个 dst。
	dst := make([]byte, ascii85.MaxEncodedLen(len(src)))
	n, consumed, err := ascii85.Decode(dst, src, true)
	if err != nil {
		return nil, fmt.Errorf("ASCII85 解码失败,已消费 %d 字节:%w", consumed, err)
	}
	return dst[:n], nil
}

func main() {
	// 示例输入只用于说明调用方式,不代表线上文件或运行截图。
	data, err := decodeText("<~87cURD_*#TDfTZ)+T~>")
	if err != nil {
		panic(err)
	}
	fmt.Printf("decoded bytes: %d\\n", len(data))
}
这里有三个容易忽略的点:
flush=true表示当前输入就是流的结尾,最后不足一个完整 32 位块的部分也要被处理。- 返回的
n才是有效输出长度;目标切片的剩余容量不属于结果。 - 返回错误时可以利用
consumed记录大致出错位置,但不要把部分输出当成完整文件继续使用。
为什么流式输入要换 NewDecoder
如果文本来自文件、消息队列或 HTTP 请求,一次性把全部内容读进内存会让输入大小直接决定内存峰值。ascii85.NewDecoder 接收一个 io.Reader,返回另一个 Reader,调用方可以按固定缓冲区读取。
package main

import (
	"encoding/ascii85"
	"fmt"
	"io"
	"strings"
)

func readDecoded(text string) ([]byte, error) {
	// 这个示例把标记处理放在流解码器之外,实际项目可在协议层先完成校验。
	text = strings.TrimSpace(text)
	if !strings.HasPrefix(text, "<~") || !strings.HasSuffix(text, "~>") {
		return nil, fmt.Errorf("需要完整的 ASCII85 包装")
	}
	body := strings.TrimSuffix(strings.TrimPrefix(text, "<~"), "~>")
	decoder := ascii85.NewDecoder(strings.NewReader(body))
	// 读取块大小固定,避免由输入长度直接决定单次分配。
	buf := make([]byte, 1024)
	var out []byte
	for {
		n, err := decoder.Read(buf)
		if n > 0 {
			out = append(out, buf[:n]...)
		}
		if err == io.EOF {
			return out, nil
		}
		if err != nil {
			return nil, fmt.Errorf("流式 ASCII85 解码失败:%w", err)
		}
	}
}

func main() {
	// 生产代码还应给上游 Reader 加长度限制和取消机制。
	data, err := readDecoded("<~87cURD_*#TDfTZ)+T~>")
	if err != nil {
		panic(err)
	}
	fmt.Printf("decoded bytes: %d\\n", len(data))
}
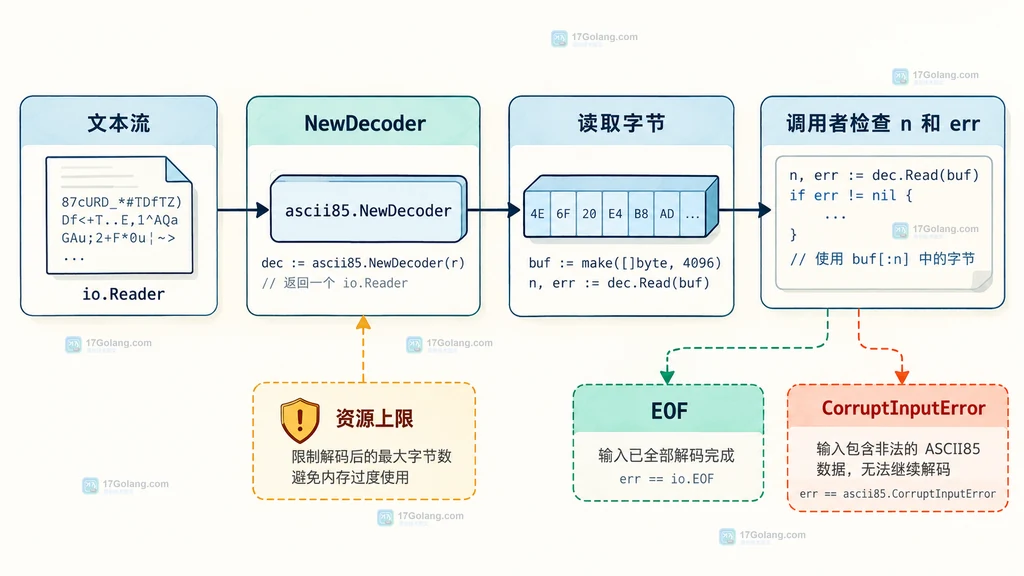
流式版本的关键不是“换一个函数名”,而是把内存和错误边界交给读取循环管理。若输入来自不可信请求,还要在 Reader 外层加长度上限;若任务可以取消,则应让上游 Reader 对应的请求上下文或连接关闭真正生效。
残块和非法输入怎样处理
ASCII85 按 32 位块工作,所以输入可能在最后留下不满一组的编码字符。一次性调用时用 flush=true 明确告诉解码器“现在到结尾了”;流式读取则让 NewDecoder 在读到结尾后处理尾部。
格式风险主要有三类:
| 现象 | 应检查什么 | 处理建议 |
|---|---|---|
| 只带一侧包装标记 | 首尾是否同时存在 | 在业务层直接拒绝,不进入解码 |
| 返回 CorruptInputError | 编码字符是否被截断或混入无效字符 | 记录输入位置,丢弃不完整结果 |
| 读取量异常增长 | 上游是否有长度上限 | 使用限长 Reader,避免无界累积 |
ASCII85 只负责编码转换,不负责完整性校验、身份认证或机密性保护。如果数据还需要防篡改,应在协议层增加摘要或签名;不要因为编码文本看起来不可读,就把它当作安全边界。
我会怎样在项目里做选择
我现在会按数据来源做一个很简单的分界:配置字段、短消息和测试夹具使用 Decode,因为返回值清楚、便于一次性处理;文件、上传流和可能变大的消息使用 NewDecoder,并在外层加入长度限制与取消机制。
落地前可以按下面的顺序自查:
- 是否明确上游是否包含
<~ ~>包装? - 是否只使用实际写入的
n个字节? - 是否处理了
CorruptInputError和 EOF? - 外部输入是否有最大长度、超时和取消路径?
- 是否把编码与加密、签名、压缩等职责分开?
相关问题
ASCII85 和 Base64 应该怎么选?
先看对端协议。Base64 在 Web 和通用 API 中更常见,ASCII85 在 btoa、PostScript、PDF 等文本场景中更常见;不要只按编码后的长度或字符观感做决定。
Decode 能不能直接处理带包装标记的文本?
不能把包装标记当作库会自动处理的内容。根据官方文档,常见包装需要由调用方先去除,然后再调用 Decode。
为什么不直接把全部输入读成字符串?
小输入可以这样做,但文件和网络数据最好采用流式 Reader,并给外部输入设置上限。这样更容易控制内存峰值,也能把错误发生的位置和处理阶段分开。




