
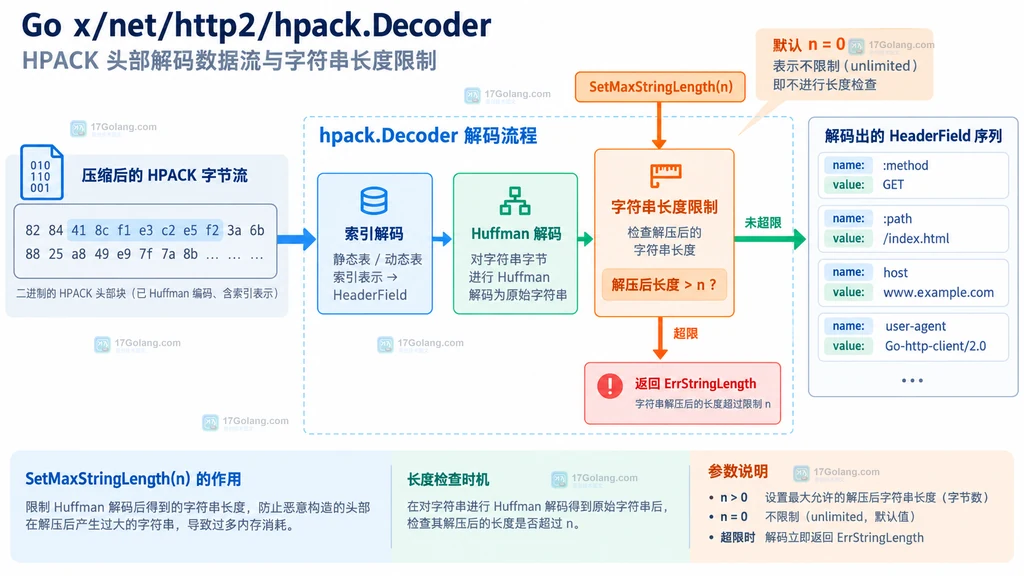
在 Go 的 golang.org/x/net/http2/hpack 中,Decoder 解码的是 HTTP/2 的 HPACK 头部块。输入里的字节数是压缩后的长度,真正交给应用的 HeaderField 名称和值可能在 Huffman 解码、索引展开后变长,所以只按网络包大小做限制并不够。
官方文档:https://pkg.go.dev/golang.org/x/net/http2/hpack#Decoder.SetMaxStringLength
SetMaxStringLength 限制的是解压后的 HeaderField 名称和值长度。超过上限时,Decoder.Write 返回 hpack.ErrStringLength;传入 0 表示不限制,也是 NewDecoder 的默认行为。
先把“输入很短”与“结果很长”分开看
HPACK 会使用静态表、动态表和 Huffman 编码减少传输体积。一个很短的编码片段可能指向已有表项,也可能在解码后得到更长的名称或值。因此,SetMaxStringLength 的判断点放在字符串已经展开之后,而不是简单比较 Write 收到的 []byte 长度。
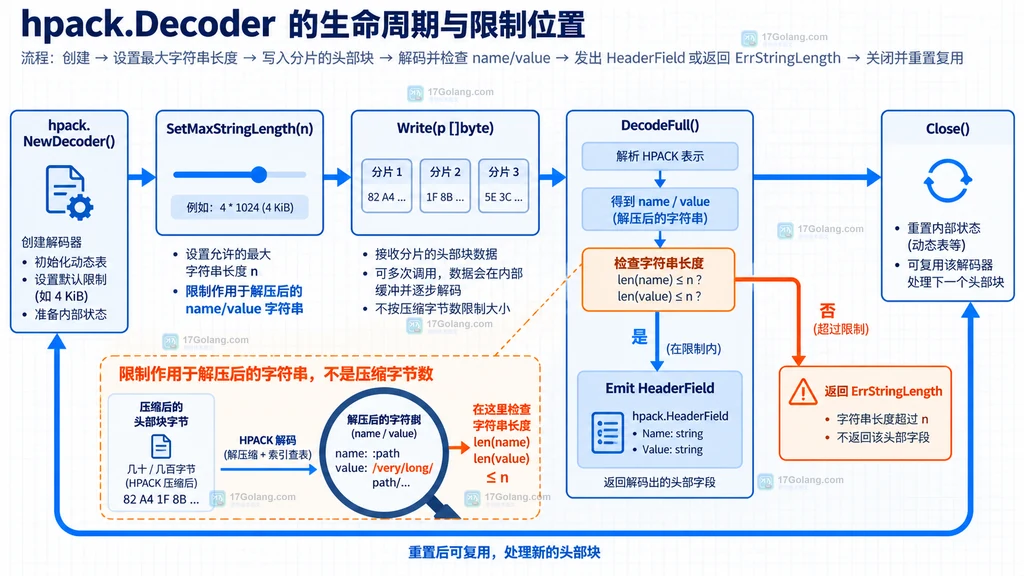
这也解释了一个常见误判:把网络层的最大帧大小、请求头总大小和单个字符串上限当成同一个参数。它们保护的是不同阶段。本文只讨论 hpack.Decoder 对单个名称或值字符串的限制。
最小配置:给 Decoder 设置可解释的上限
初始化 Decoder 后立即设置上限,通常比在每次回调里再猜测长度更清楚。下面的示例把名称和值的最大长度设为 4096 字节,并将 ErrStringLength 单独处理。示例只展示调用关系,未声称在本机执行过。
package main

import (
    "errors"
    "fmt"

    "golang.org/x/net/http2/hpack"
)

func decodeHeaderBlock(block []byte) error {
    // 回调在 Write 所在的 goroutine 中执行;这里只保存已经解码的字段。
    decoder := hpack.NewDecoder(4096, func(field hpack.HeaderField) {
        fmt.Printf("%s: %s\n", field.Name, field.Value)
    })
    // 限制解压后的 name/value,避免压缩输入展开成过大的字符串。
    decoder.SetMaxStringLength(4096)

    // Write 可能只消费当前分片;调用方应保存 n,并继续提供剩余字节。
    _, err := decoder.Write(block)
    if errors.Is(err, hpack.ErrStringLength) {
        // 这是输入超过策略上限,不应当当作普通网络重试信号。
        return fmt.Errorf("header string exceeds policy: %w", err)
    }
    if err != nil {
        // 其他解码错误仍按协议错误处理,并保留原始错误。
        return fmt.Errorf("decode HPACK block: %w", err)
    }
    return nil
}
这里的关键不是 4096 这个数字,而是把策略和错误类型绑定起来。业务如果允许更长的 Cookie 或自定义元数据,可以提高上限;如果入口只接受少量固定头部,则应使用更小的值,并在协议层另行限制总头部大小。
为什么要识别 ErrStringLength,而不是只判断 Write 出错
官方文档明确说明,字符串超限时 Write 返回 ErrStringLength。用 errors.Is 识别它,可以把“输入超过策略”与 Huffman 解码错误、索引错误等其他失败分开,日志和响应策略也更容易保持稳定。
func classifyHPACKError(err error) string {
    // 先识别可预期的长度策略拒绝,避免把它归入未知故障。
    if errors.Is(err, hpack.ErrStringLength) {
        return "header-too-large"
    }
    if err == nil {
        // nil 表示当前分片没有发现错误,不代表整个连接已经结束。
        return "ok"
    }
    // 其余错误交给上层按协议解码失败记录和处理。
    return "decode-error"
}
如果解码器被放在 HTTP/2 服务器的边界层,长度策略错误通常应该被记录为请求输入问题,而不是无限重试。实际响应码和连接处理仍由使用 hpack 的上层协议实现决定,不能仅凭这个包的错误值推导出完整的 HTTP 响应策略。
增量 Write 中,限制发生在解码生命周期的哪里
Decoder 支持增量处理头部块。调用方可能多次传入 Write,每次都要保留未消费的字节并根据返回值继续推进。达到字符串上限时,错误发生在解码阶段;不要因为输入分片本身没有超过上限,就认为最终 HeaderField 一定安全。
func finishHeaderBlock(decoder *hpack.Decoder, parts [][]byte) error {
    // 每个分片都必须按顺序写入同一个 Decoder,不能并发复用同一实例。
    for _, part := range parts {
        if _, err := decoder.Write(part); err != nil {
            // 一旦出现长度或协议错误,停止继续喂入当前头部块。
            return err
        }
    }
    // Close 表示当前头部块结束,并准备让 Decoder 进入下一轮复用状态。
    return decoder.Close()
}
Close 不是长度限制开关。它声明当前头部块已经结束,并在可复用时重置解码状态;如果还有未完成的数据,Close 会返回错误。因此,长度策略应在创建或复用前明确设置,分片流程则要保证顺序和结束时机。
上限怎么定:从头部类型和业务边界反推
可以先按实际业务头部分类估算,再用拒绝日志观察是否误伤。Cookie、授权票据和自定义追踪字段往往比普通方法名或内容类型更长;如果多个字段的总量也有限制,还需要在更高层统计 HeaderField 总大小,不能用单字符串上限替代总量控制。
| 判断对象 | 它限制什么 | 不能替代什么 |
|---|---|---|
| SetMaxStringLength(n) | 解压后单个名称或值字符串 | 不能代表整个请求头总量 |
| Write 输入分片大小 | 本次送入解码器的编码字节 | 不能代表展开后的字符串长度 |
| Close() | 当前头部块是否完整并重置状态 | 不能替代长度策略 |
| 业务层总量策略 | 多个 HeaderField 的累计预算 | 不能替代 HPACK 解码器自身的错误处理 |
如果把默认的 0 留在生产入口,意味着该 Decoder 对单个字符串不设这个上限。这样可能是刻意的兼容选择,但应当确认上游已经提供了足够的请求头大小约束,并记录为什么不在 hpack 层设置限制。
排查超限时按这几项复查
- 确认设置的是
SetMaxStringLength,而不是误改动态表大小;两者保护的对象不同。 - 记录发生错误的头部类别和策略上限,但不要把完整敏感值写入日志。
- 检查错误是否确实是
hpack.ErrStringLength,再决定返回输入错误还是记录协议异常。 - 确认分片按顺序写入同一 Decoder,并在一个头部块结束时调用
Close。 - 用真实业务头部的长度分布调整上限,避免单纯把数值调得极大。
相关问题
SetMaxStringLength 的 0 是不是禁止所有字符串?
不是。官方定义中,0 表示 unlimited,是 NewDecoder 的默认值;它意味着没有这个单字符串上限。
压缩后的字节数小于上限,为什么仍然可能报错?
因为判断针对解压后的名称或值。索引展开和 Huffman 解码都可能让最终字符串明显长于编码输入。
可以把 ErrStringLength 当成网络暂时故障重试吗?
不建议。它表示当前解码结果违反了本地长度策略,更适合作为输入边界错误记录和处理。
只设置字符串上限就能限制所有 HTTP/2 请求头吗?
不能。它只针对单个名称或值;整个头部列表、帧和连接仍需要由上层协议实现配合限制。
总结来说,限制 hpack.Decoder 字符串长度的原因是“压缩输入大小不能代表解压结果大小”。在边界处设置明确的上限,用 errors.Is 识别 ErrStringLength,再把增量 Write 与 Close 生命周期处理完整,才能让这项保护既有效又可排查。




