
Go slices.BinarySearchFunc 返回 false 时如何定位插入位置
来源:17golang原创
时间:2026-10-31 16:07:00 177浏览 收藏
先记住:false 时的 n 就是插入位置
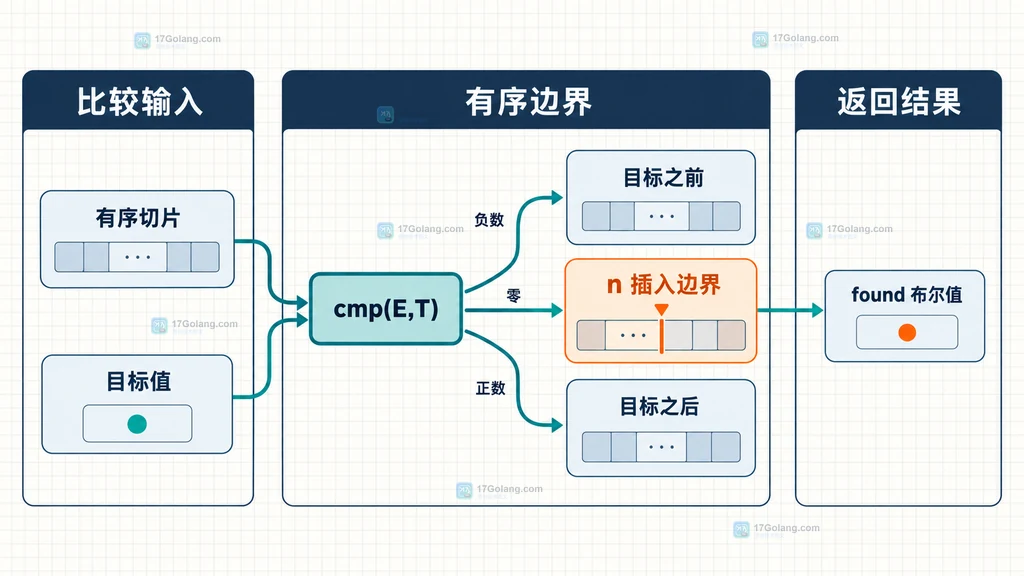
slices.BinarySearchFunc 返回两个值:下标 n 和布尔值 found。当 found 为 true 时,n 指向匹配元素;当 found 为 false 时,n 指向目标值按当前排序规则应该出现的位置。把元素插入 n,就能继续保持切片有序。
这个结论的前提是:切片已经按同一个比较函数升序排列,而且比较函数对“排在前面、相等、排在后面”返回负数、零、正数。
- n:匹配位置,或未命中时的插入位置。
- found:是否存在比较结果为零的元素。
- cmp:必须和切片的实际排序规则一致。
返回值为什么能直接当插入下标
二分查找会把范围不断缩小,直到找到第一个不应排在目标前面的边界。这个边界就是 n:目标存在时,它是匹配项的位置;目标不存在时,它是目标应插入的位置。空切片和插到末尾也遵循同一规则,不需要额外分支。
package main

import (
    "fmt"
    "slices"
    "strings"
)

type Person struct {
    Name string
    Age  int
}

func main() {
    people := []Person{
        {Name: "Alice", Age: 30},
        {Name: "Bob", Age: 28},
        {Name: "Dora", Age: 34},
    }
    target := Person{Name: "Cindy", Age: 26}

    // 比较器只按 Name 定义顺序,必须和 people 的排序规则相同。
    n, found := slices.BinarySearchFunc(people, target, func(a, b Person) int {
        return strings.Compare(a.Name, b.Name)
    })
    // 未命中时 n 是第一个不能排在目标前面的下标。
    if !found {
        people = slices.Insert(people, n, target)
    }
    fmt.Println(n, found, people)
}在这个例子里,Cindy 位于 Bob 和 Dora 之间,所以返回的 n 可以直接交给 slices.Insert。如果目标排在所有元素之后,n 会等于 len(people);如果切片为空,n 会是零。
比较函数必须和排序规则一致
BinarySearchFunc 不会替你检查切片是否按比较器有序。比如切片按 Name 升序排列,却在搜索时改用 Age,得到的下标就没有插入意义;把升序比较器换成降序也会产生同样的问题。
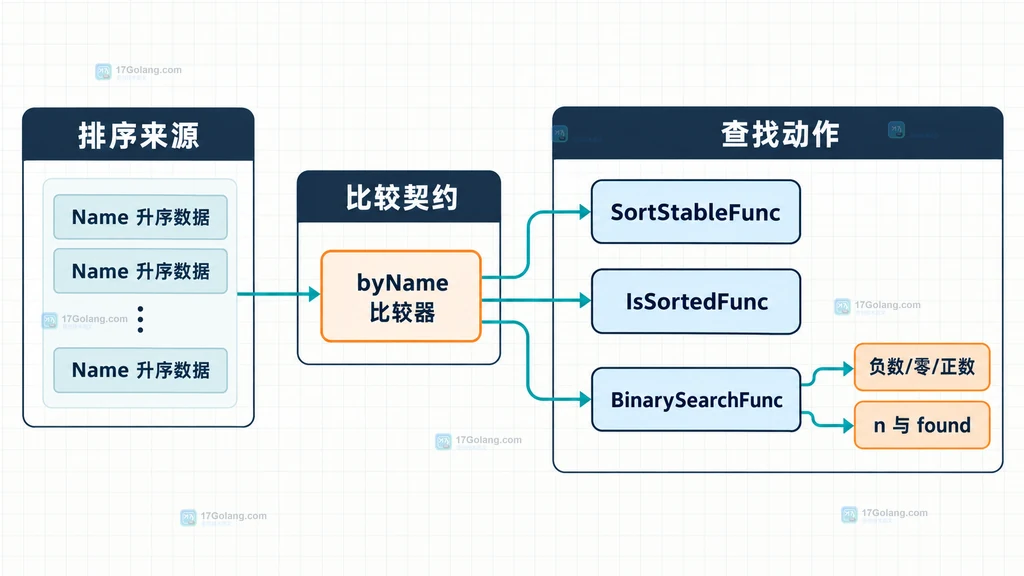
比较函数只需要遵守三路结果:cmp(a, target) 表示 a 应排在目标前,等于零表示匹配,大于零表示应排在目标后。更重要的是,排序和搜索必须共享这条规则。
func byName(a, b Person) int {
    // 统一把 Name 作为唯一的排序和查找字段。
    return strings.Compare(a.Name, b.Name)
}

// 排序、检查和查找都复用同一个比较器。
slices.SortStableFunc(people, byName)
if !slices.IsSortedFunc(people, byName) {
    panic("people 未按 byName 排序")
}
n, found := slices.BinarySearchFunc(people, target, byName)
把比较器单独命名并复用,通常比在多个调用点重复写匿名函数更容易审查。这里的检查是开发阶段的护栏,不是对二分查找结果的补救;排序不成立时,应该先修正数据来源或排序流程。
把未命中和重复元素分开处理
found == false 时,通常是“插入后保持顺序”;found == true 时,则要先决定业务动作:跳过重复项、替换已有项,还是允许重复值。不能把两种情况都写成无条件插入,否则命中时会制造重复记录。
如果排序字段允许重复,返回的命中下标代表一个匹配位置。题目只需要定位未命中的插入点,因此不要在 found == true 时假定它就是重复区间的末端;需要“插到所有相同值之后”时,应另写清晰的上界策略,并把该策略作为独立需求验证。
常见问题
found 为 false 时,n 会不会超出切片长度?
不会。它的范围是 0 到 len(x),等于长度表示应追加到末尾,所以可以直接作为 slices.Insert 的下标。
为什么结果看起来不对?
先检查切片是否按同一个比较器排序,再检查比较器的正负号方向是否一致。不要只看元素类型相同;按不同字段排序时,类型相同也无法保证查找边界有效。
发布前的检查清单
- 排序阶段和搜索阶段是否复用了同一个比较函数?
- 比较函数是否对前、中、后分别返回负数、零、正数?
- 未命中时是否只在
found == false分支插入n? - 是否覆盖空切片、插入开头和插入末尾这三个边界?
把 n 理解为“有序边界”,把 found 理解为“是否命中”,这两个返回值就能稳定地服务于自定义字段排序和有序插入。
-
860 收藏
-
843 收藏
-
826 收藏
-
809 收藏
-
792 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习