
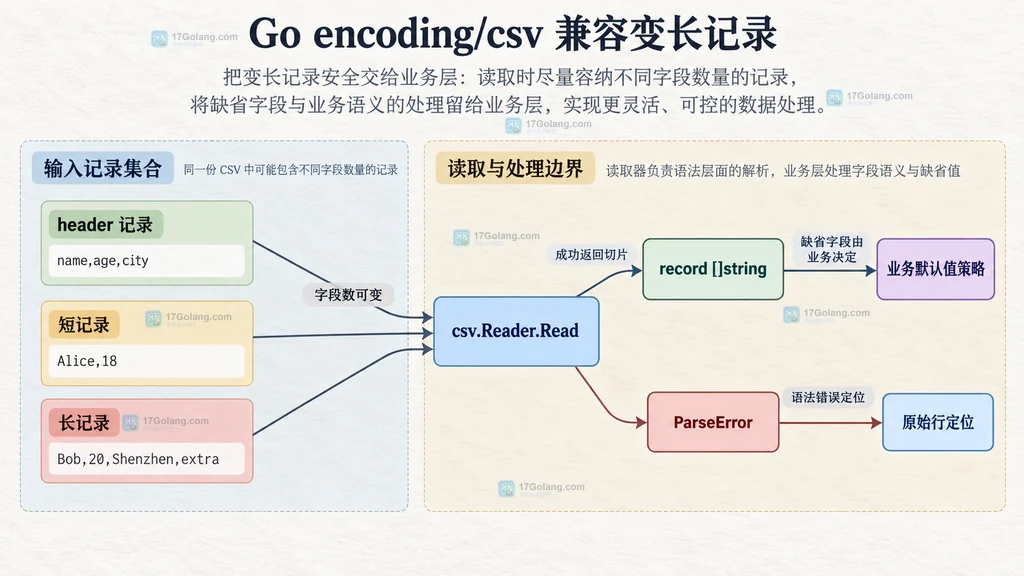
我第一次把供应商导出的 CSV 接进 Go 服务时,最先遇到的不是编码问题,而是同一个文件里有的记录只有 3 列,有的记录却多出 1 列备注。直接使用 encoding/csv.NewReader 读取时,Reader 会把首条记录的字段数当作后续默认标准,遇到长度变化就返回 csv.ErrFieldCount。
如果这类变长记录是协议允许的,处理方式是把 FieldsPerRecord 设为负值。这样 Reader 不再检查每条记录的字段数量,但业务代码必须把 []string 当作长度可变的数据:有值才取,没有就使用明确的默认策略。字段数量检查被放宽,不代表 CSV 引号、换行和分隔符语法错误也应该被忽略。
兼容变长记录的关键只有两层:Reader 用负的 FieldsPerRecord 接受不同长度,业务层用长度判断补齐或跳过缺省字段;ParseError、底层读取错误和不可信的字段内容仍要正常处理。
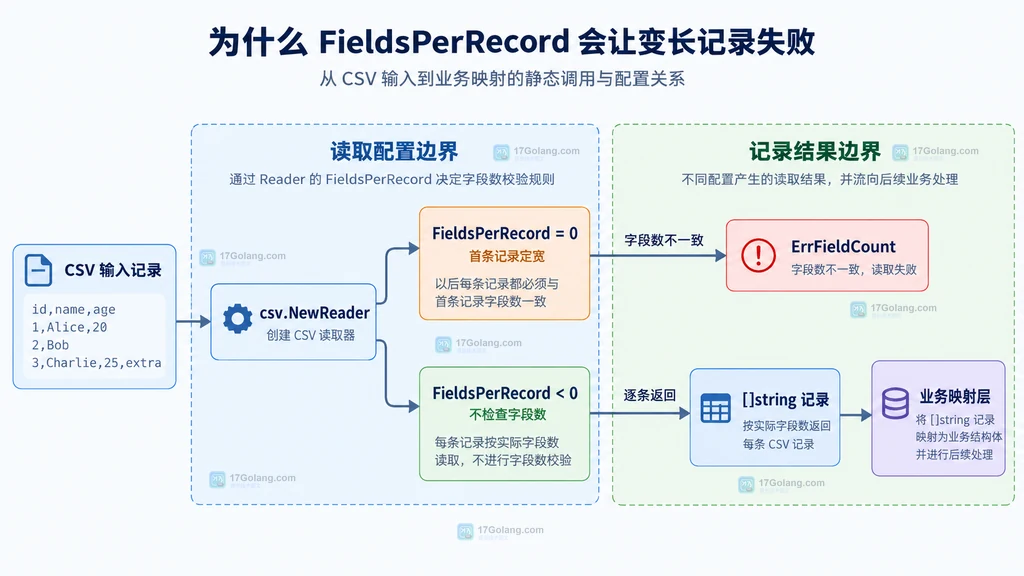
FieldsPerRecord = 0:首条记录确定字段数,后续不一致会返回ErrFieldCount。FieldsPerRecord < 0:不检查字段数,每次返回实际读到的字段切片。- 长度差异由业务规则处理,CSV 语法错误仍由 Reader 返回。
我先确认 FieldsPerRecord 为什么会挡住变长记录
csv.NewReader 返回的 Reader 默认把 FieldsPerRecord 设为 0。官方文档对这个值的定义是:第一次读取时记录字段数,之后要求记录保持相同长度。因此问题不在于 CSV 文件“不能有短行或长行”,而在于默认配置把字段数量当成了隐含 schema。
如果文件第一行有 3 个字段,第二行有 4 个字段,默认 Reader 返回的记录可能仍然带着部分字段,但同时伴随 ErrFieldCount。只判断 err != nil 并直接丢弃所有记录,会把本来可兼容的数据也丢掉;反过来,如果完全忽略错误,又可能吞掉真正的 CSV 语法问题。
允许字段数变化:把检查范围缩小到语法层
对于明确允许缺省列、扩展列或尾部备注的输入,可以在第一次读取前设置负值。下面的例子只演示 Reader 的字段数策略和逐条读取,不把示例输出冒充成本机运行结果。
package main

import (
	"encoding/csv"
	"fmt"
	"io"
	"strings"
)

func main() {
	// 这个输入故意包含 2 列、3 列和 1 列记录,用来说明长度可变的边界。
	input := "id,name\n1,Ada,备注\n2\n"
	reader := csv.NewReader(strings.NewReader(input))
	// 负值表示不按固定列数检查,Reader 会返回每条记录的实际字段。
	reader.FieldsPerRecord = -1

	for {
		record, err := reader.Read()
		if err == io.EOF {
			// 正常读完文件,不把 EOF 当成失败。
			break
		}
		if err != nil {
			// 引号、换行等 CSV 语法错误仍然需要保留。
			fmt.Printf("读取失败: %v\\n", err)
			continue
		}
		fmt.Printf("字段数=%d, 记录=%v\\n", len(record), record)
	}
}
这里的重点是设置时机和语义:配置要放在第一次调用 Read 之前;负值只关闭字段数一致性检查,不会把非法引号自动变成合法 CSV。对于真实服务,我还会把读到的行号或输入偏移记录下来,方便定位供应商文件中的异常位置。
变长切片不能直接按固定下标访问
Reader 放宽检查后,短记录返回的切片可能没有业务想要的列。我的做法是把“取第几列”和“缺省值是什么”放在一个小函数里,避免在多个业务分支里散落 record[2] 这样的越界风险。
// fieldOrDefault 读取可选列;列不存在时返回业务约定的默认值。
func fieldOrDefault(record []string, index int, fallback string) string {
	if index < 0 || index >= len(record) {
		return fallback
	}
	return strings.TrimSpace(record[index])
}

func toRow(record []string) map[string]string {
	// 前两列是必需信息,缺失时交给上层决定是否拒绝整条记录。
	row := map[string]string{
		"id":   fieldOrDefault(record, 0, ""),
		"name": fieldOrDefault(record, 1, ""),
		// 第三列是可选备注,缺失时使用空字符串。
		"note": fieldOrDefault(record, 2, ""),
	}
	return row
}
这样做的好处是把 CSV 的物理形态和业务对象分开:短记录可以映射成空备注,长记录的额外字段也可以暂时保留在原始切片里。至于“缺少 id 是否应该拒绝”,那属于业务 schema,而不是 encoding/csv 能替你决定的规则。
哪些错误仍然不能因为变长而忽略
字段数量不一致和 CSV 语法错误是两件事。未闭合引号、非法引号位置或底层 Reader 读取失败,仍然应该进入错误处理路径。若业务确实需要“尽可能导入”,可以记录原始错误和行位置后跳过这一行,但不要把 LazyQuotes 当成通用容错开关,更不要用字符串切割替代 CSV 解析器。
如果你的数据合同要求每行必须有固定字段,负的 FieldsPerRecord 反而会掩盖供应商格式退化。这种场景应保留默认检查,或者把字段数检查移到业务层,并明确记录拒绝原因。变长模式适合“列可选、尾部可扩展、不同来源字段集合不同”的输入,不适合没有 schema 约束的任意脏数据。
Go encoding/csv 变长记录常见问题
FieldsPerRecord 设为 -1 后,所有记录都会成功吗?
不会。它只取消字段数量检查。CSV 引号、换行或底层读取仍可能产生错误,调用方仍要处理 err。
短记录缺少的字段应该由 Reader 自动补空吗?
不会。Reader 返回实际字段切片,默认值、补齐规则或拒绝规则要由业务层决定。
可以直接忽略 ErrFieldCount 吗?
只有在你明确接受字段数变化、并且已经处理返回记录时才可以按业务策略处理。固定 schema 的导入任务应保留这类错误。
结语
这次调整让我把问题拆得更清楚:FieldsPerRecord 负责决定 Reader 是否要求固定列数,业务映射负责决定缺省字段如何落地,语法错误和底层错误则始终保留。先确认输入合同,再选择负值配置,变长 CSV 才不会从“读取失败”变成“静默导入错误”。




