
MySQL collation_connection 怎样排查字符串比较异常
来源:17golang原创
时间:2026-11-02 05:22:27 149浏览 收藏
排查 collation_connection 引起的字符串比较异常,应先在出问题的同一连接中读取会话变量,再分别检查比较两边的字符集、排序规则和 COERCIBILITY。它主要影响普通字面量的排序规则;列有自己的规则,列与普通字面量比较时通常由列一侧决定,修改连接设置不会顺带改掉列定义。
对我来说,最容易走偏的地方是把“都是 utf8mb4”理解为“比较结果一定一致”。字符集解决字符如何表示,排序规则决定大小写、重音等比较语义;两者需要分别看。下面以 MySQL 8.4 文档对应的行为说明方法,代码仅作读者可执行示例,未在本次写作环境运行。
MySQL 官方地址:https://www.mysql.com/
连接字符集文档:https://dev.mysql.com/doc/refman/8.4/en/charset-connection.html
我会先把连接设置和列定义分开
设想一个用户名查询:控制台能匹配,应用里却匹配不到;或者两份字面量比较结果不同。我会先把问题归到三个独立边界:客户端发来的编码声明、当前会话处理字面量的规则、表中列的规则。这样能避免还没看操作数就先修改服务器默认值。
会话里,character_set_client 表示服务器如何理解客户端发送的语句,character_set_connection 与 collation_connection 关联语句中的字符处理,character_set_results 关联结果返回的编码。这些设置和“列排序规则”不是一组可互相替代的配置。普通字面量受到连接规则影响;显式带字符集引介符的字面量还要看它自身声明。
我倾向把会话状态记在问题连接旁边,而不是用另一个管理连接的输出代替。图中比较表达式同时关联普通字面量与列排序规则,强调需要看实际操作数。
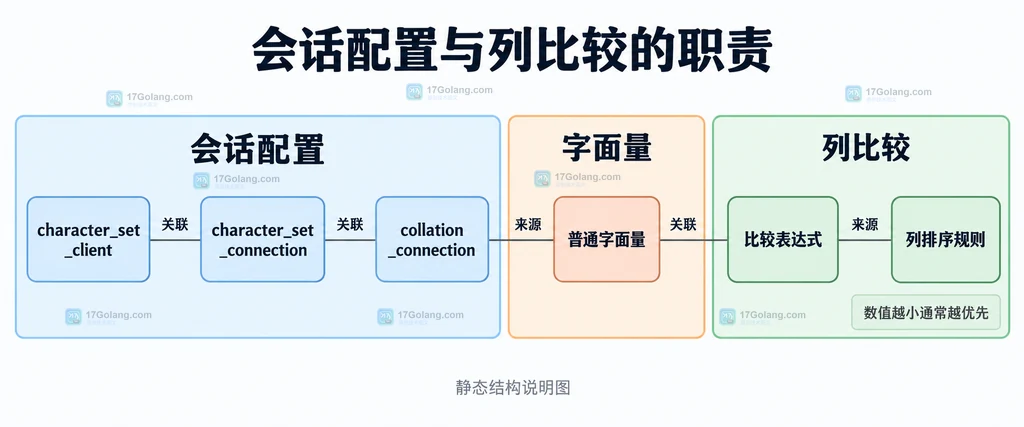
在出问题的同一会话留下参数记录
我会把连接 ID 一起记录,确认查询确实在同一物理连接上。应用使用连接池时,两次独立调用不保证借到同一连接;诊断与复现应在驱动提供的同一连接作用域内完成。
-- 只读采样:在复现查询所在的同一会话执行。
SELECT
    CONNECTION_ID() AS connection_id,
    VERSION() AS server_version,
    @@SESSION.character_set_client AS client_charset,
    @@SESSION.character_set_connection AS connection_charset,
    @@SESSION.character_set_results AS result_charset,
    @@SESSION.collation_connection AS connection_collation;

-- 观察普通字面量自身的属性,不根据显示出来的文字猜编码。
SELECT
    CHARSET('CaseNote') AS literal_charset,
    COLLATION('CaseNote') AS literal_collation,
    COERCIBILITY('CaseNote') AS literal_coercibility;
需要比较的是应用连接与控制台连接各自的实际值。如果只看到服务器默认变量相同,证据还不够:连接初始化、驱动配置和后续 SET 都可能改变会话。预处理参数也不应直接按控制台内联字面量推断;保留原来的参数绑定方式,在应用会话内做对照。
涉及真实用户名、客户编号等信息时,我更愿意只记脱敏后的样例、参数类型和连接配置,不把完整业务数据贴入公共日志。
用字面量对照隔离比较规则
先排除表结构,只用 ASCII 大小写做最小对照。下列 SET 只适合独立诊断连接;它改变会话编码声明,实际客户端发送的字节仍应与声明一致。不要把它复制进正在服务请求的随机池连接。
-- 保存当前会话配置,稍后恢复;不要在生产共享连接上直接试。
SET @saved_client = @@SESSION.character_set_client,
    @saved_connection = @@SESSION.character_set_connection,
    @saved_results = @@SESSION.character_set_results,
    @saved_collation = @@SESSION.collation_connection;

-- 确认目标实例支持示例中的两种规则。
SHOW COLLATION WHERE Collation IN (
    'utf8mb4_0900_ai_ci', 'utf8mb4_0900_as_cs'
);

-- 对照一:大小写不敏感。
SET NAMES utf8mb4 COLLATE utf8mb4_0900_ai_ci;
SELECT 'CaseNote' = 'casenote' AS same_text,
       COLLATION('CaseNote') AS literal_collation;

-- 对照二:大小写敏感。
SET NAMES utf8mb4 COLLATE utf8mb4_0900_as_cs;
SELECT 'CaseNote' = 'casenote' AS same_text,
       COLLATION('CaseNote') AS literal_collation;

-- 恢复诊断会话;先恢复字符集,再恢复它对应的排序规则。
SET SESSION character_set_client = @saved_client;
SET SESSION character_set_connection = @saved_connection;
SET SESSION character_set_results = @saved_results;
SET SESSION collation_connection = @saved_collation;
按所选规则推导,第一个比较应为 1,第二个应为 0。这是预期语义,不是本机实测输出;若 SHOW COLLATION 没返回对应项,就不要继续执行不存在规则的 SET,应按目标版本支持的规则调整对照。
这个实验回答“会话是否影响普通字面量”,还没有回答“为什么某一列的 WHERE 匹配异常”。我认为把这两件事拆开,比反复换 collation_connection 更容易找到责任范围。
回到列和表达式判断谁拥有优先级
回到业务表后,先看列定义,再看表达式属性。以下以 user_profile.login_name 为占位示例,请替换为实际表列名;若表为空,第二条查询没有行,不代表列没有排序规则,应以元数据为准。
-- 查看目标列本身的定义,避免只看表的默认排序规则。
SELECT COLUMN_NAME, COLUMN_TYPE, CHARACTER_SET_NAME, COLLATION_NAME
FROM information_schema.COLUMNS
WHERE TABLE_SCHEMA = DATABASE()
  AND TABLE_NAME = 'user_profile'
  AND COLUMN_NAME = 'login_name';

-- 查看操作数与字面量的优先级;不修改业务数据。
SELECT
    CHARSET(login_name) AS column_charset,
    COLLATION(login_name) AS column_collation,
    COERCIBILITY(login_name) AS column_coercibility,
    COLLATION('CaseNote') AS literal_collation,
    COERCIBILITY('CaseNote') AS literal_coercibility
FROM user_profile
LIMIT 1;
COERCIBILITY 数字越小,通常越优先:显式 COLLATE 为 0,列为 2,普通字面量为 4。因此无显式覆盖的“列 = 字面量”通常沿用列规则;连接改成大小写敏感,不会自动把大小写不敏感的列变成敏感列。
如果两边都是列,优先级可能相同,还要结合双方字符集和排序规则处理;不能简单套一句“左边赢”。碰到 Illegal mix of collations 时,我会把左右表达式分别取 CHARSET、COLLATION、COERCIBILITY,必要时拆开 CONCAT、CASE 等复合表达式,而不是仅检查连接变量。
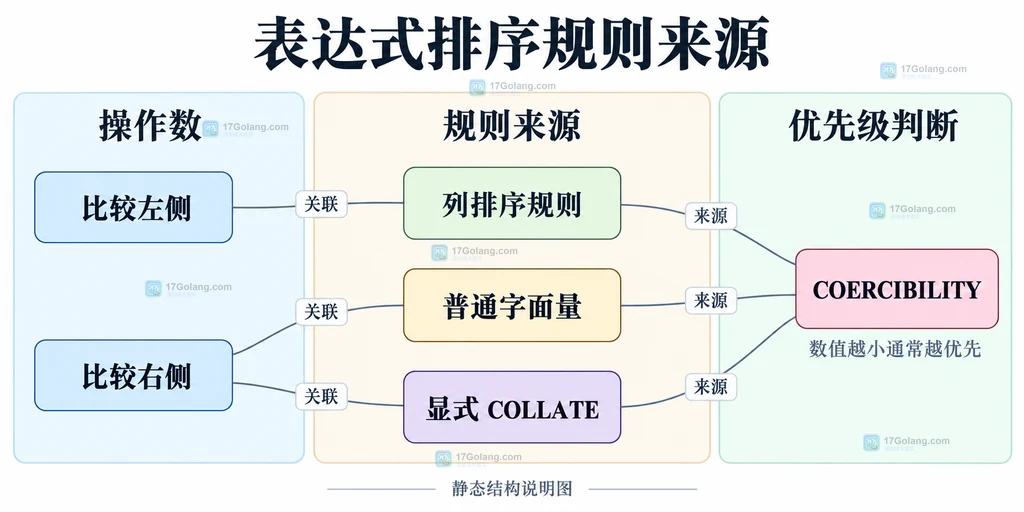
把修复放到正确的配置边界
如果问题来自初始化不一致,我的选择是把编码与排序规则放到驱动或连接创建配置里,并让每个新建连接采用一致配置。下面是 SQL 层面的示意,不是替代任意驱动配置的通用 DSN:
-- 仅在客户端确实使用 UTF-8、目标实例支持此规则时使用。
-- 每个物理连接都需采用一致配置,而不是只对连接池执行一次。
SET NAMES utf8mb4 COLLATE utf8mb4_0900_ai_ci;
SET NAMES 会一起设置 client、connection、results 相关字符集,并可通过 COLLATE 指定连接规则。单独改 collation_connection 则不等于完整声明客户端编码。连接重建、重置之后,也需要确认初始化策略仍然生效。
如果业务明确要求单条比较区分大小写,可以在字符集兼容的前提下使用显式规则。下面只用 ASCII 字面量隔离规则选择,不涉及驱动参数或表数据:
-- 字符集引介符明确字面量属于 utf8mb4,COLLATE 指定本次比较。
SELECT
    _utf8mb4'CaseNote' COLLATE utf8mb4_0900_as_cs
      = _utf8mb4'casenote' AS exact_case_match;
把同样思路用到实际查询时,先确认列字符集与规则兼容,再观察实际执行计划与访问方式。我不会给整张表的所有查询机械加 COLLATE;这会分散业务相等语义,也可能改变优化器可用的访问方式。
只有列的业务规则本身需要统一,才考虑表结构迁移。迁移会涉及历史数据、排序、唯一键冲突及查询行为,不能靠修改会话变量替代。乱码或历史错误编码也不是改排序规则就会修好;先看字节与编码声明,再谈比较语义。
上线前按异常类型做最后判断
| 现象 | 我会先看 | 修复落点 |
|---|---|---|
| 普通字面量比较不同 | 会话规则与字面量属性 | 连接初始化或局部规则 |
| 改会话后列查询没变 | 列 COLLATION_NAME | 列语义或查询表达式 |
| 两列比较报混用错误 | 左右字符集、规则和优先级 | 兼容转换或统一列设计 |
| 只有部分请求异常 | 物理连接初始化与参数绑定 | 连接池建连策略 |
| 显示乱码 | 字节、客户端声明、返回编码 | 编码链路及历史数据 |
改 collation_connection 会修改已有列吗?
不会。它是会话处理的一部分,列定义需要单独查看。
utf8mb4 相同就不会混用排序规则吗?
不能这么判断。同一字符集有多种排序规则,具体表达式仍需按优先级和兼容规则分析。
连接设置和查询加 COLLATE 应该选哪个?
连接设置适合统一客户端会话的基础约定;显式 COLLATE 适合边界明确的局部比较需求。长期业务等价关系应在数据模型中保持一致,避免每个调用方各自解释。
官方参考:https://dev.mysql.com/doc/refman/8.4/en/charset-collation-coercibility.html;https://dev.mysql.com/doc/refman/8.4/en/charset-collate.html。本页 SQL 与说明围绕会话和操作数独立编写,示意图不代表真实数据库截图。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
数据库 · MySQL | 24分钟前 | MySQL · mysql Performance Schema table_io_waits_summary_by_index_usage INDEX_NAME 索引等待404 收藏
-
490 收藏
-
408 收藏
-
数据库 · MySQL | 45分钟前 | MySQL · 事务 · 数据库 · InnoDB · mysql innodb 只读事务 START TRANSACTION READ ONLY 事务写入176 收藏
-
434 收藏
-
数据库 · MySQL | 51分钟前 | MySQL · 数据库 · DDL · 迁移 · InnoDB · mysql innodb ALTER TABLE INSTANT ADD COLUMN 在线DDL 表结构变更149 收藏
-
189 收藏
-
360 收藏
-
264 收藏
-
数据库 · MySQL | 1小时前 | MySQL · 事务 · InnoDB · 性能排查 · mysql innodb 锁等待 information_schema.innodb_trx 未提交事务189 收藏
-
347 收藏
-
118 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习