
AI 训练和在线推理共用一批加速卡时,难点通常不是“有没有 Kubernetes”,而是两类工作负载对资源的要求完全不同:训练更在意稳定容量、队列和配额,在线推理更在意延迟、流量信号和快速扩缩。CNCF 公布的招商银行终端用户案例,给出的思路是用一个统一 Kubernetes 控制面共享异构加速卡,同时把训练调度、推理伸缩、加速器切分和数据访问拆给不同组件。
官方案例:https://www.cncf.io/announcements/2026/09/07/china-merchants-bank-wins-cncf-end-user-case-study-contest-for-unifying-ai-training-and-inference-on-kubernetes/
这个案例值得借鉴的不是某个组件清单,而是“统一资源池、分离工作负载控制逻辑”的架构边界。官方披露的效率数字可以用来理解目标,但不能直接当成其他团队的性能承诺。
先看清训练与推理为什么会互相争资源
分布式训练往往要等齐多个 worker 和加速器,稳定容量比瞬时响应更重要;在线推理则受请求流量影响,需要快速增加或释放副本。若两者只共享一个粗粒度队列,训练可能长时间占住资源,推理又可能因为突发流量拿不到足够容量。
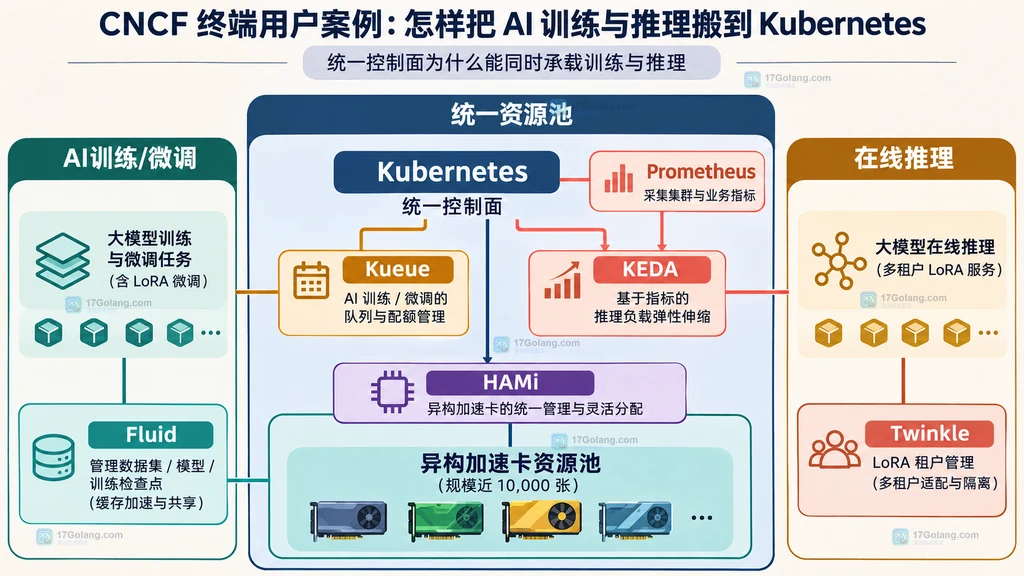
招商银行案例把问题拆成三层:资源层负责统一纳管异构加速卡,工作负载层分别处理训练排队和推理弹性,数据层减少数据集、权重与 checkpoint 访问带来的等待。这样既保留一套基础设施,又不要求训练和推理采用同一套调度节奏。
统一控制面里的组件各自负责什么
Kubernetes 提供资源编排的基础边界;Kueue 面向训练任务管理准入、队列和配额,避免作业还不能真正运行时就提前占住容量;KEDA 与 Prometheus 配合,把在线推理的伸缩连接到实时需求信号;HAMi 负责在不同工作负载之间进行更细粒度的异构加速资源分配;Fluid 则加速数据集、模型权重和 checkpoint 的访问,让加速卡少等数据。
这套分工的关键是控制信号不同但资源池可以共享。训练侧看队列、配额和可用容量,推理侧看请求与延迟等需求指标,资源侧再把这些约束落到异构加速器上。组件不是越多越好,只有当团队确实同时面对这些边界时,拆分才有价值。
把训练、推理和数据访问放进同一资源池
共享并不等于让所有任务进入同一条队列。更稳妥的做法是保留统一资源目录和容量视图,再为训练、在线推理与多租户微调定义不同的准入和优先级。训练可以通过队列等待可用的成组资源,在线推理根据需求信号扩缩,HAMi 把可分配的加速器切分落到工作负载边界,Fluid 让数据和模型访问路径不成为新的瓶颈。
从工程角度看,平台团队应先画出三张表:加速器类型与可用容量,训练任务的队列和配额,推理服务的流量、延迟与副本。三张表都由统一控制面观察,但不把训练的等待时间和推理的响应时间混成一个指标。
Twinkle 的多租户微调为什么能减少重复占用
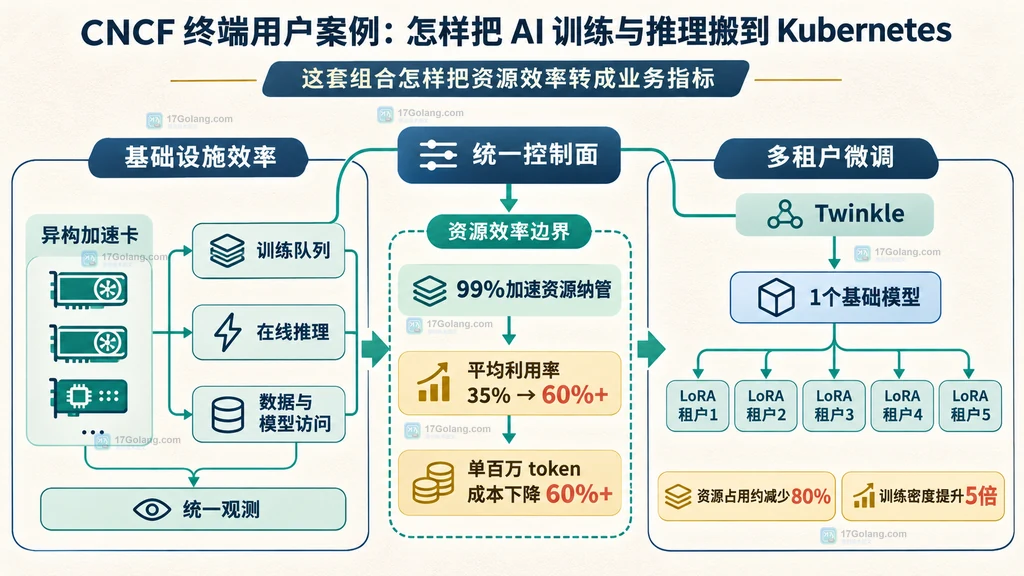
多租户 LoRA 微调常见的浪费,是每个租户都复制一份相同的基础模型。CNCF 页面介绍,招商银行的 Twinkle 训练框架默认让五个 LoRA 租户共享一个基础模型实例。这样,基础模型不再按租户重复驻留,加速器可以把更多空间留给租户自己的适配参数和训练任务。
官方案例给出的结果是,在这一设置中,基础模型副本从五份减少为一份,使加速器资源占用减少 80%,训练密度提升 5 倍。这里的限定语很重要:这是该案例的特定设置,不代表任意模型大小、租户数量和硬件组合都能得到相同结果。
如何读懂案例中的效率指标
CNCF 官方披露,招商银行把 99% 的加速计算资源纳入这套框架,平均利用率从 35% 提升到 60% 以上,并在可比模型和服务条件下,将处理 100 万 token 的成本降低 60% 以上。读这些数字时,应该把它们当成一条因果链:资源先被统一纳管,工作负载才能共享;共享减少空闲,利用率才可能提升;当利用率和调度效率改善后,单位 token 成本才有机会下降。
这条链不能脱离基线。准备复用这个思路的团队至少要记录资源纳管率、训练等待时间、推理 P95 延迟、加速器平均利用率、数据与模型访问等待,以及单位 token 成本。只有口径、模型和服务条件相近,迁移前后的比较才有意义。
哪些团队适合借鉴这条路线
如果团队只有单一模型、少量加速卡和一种工作负载,先把训练和推理都纳入一套复杂平台,可能得不偿失。若团队已经同时运行训练、微调与在线推理,硬件类型较多,且经常出现训练等待、推理突发扩容或数据访问拖慢加速器,那么“统一资源池、分离控制信号”的方向更值得评估。
落地时可以先从指标和资源目录开始,再逐步引入队列、弹性伸缩、细粒度加速器分配和数据加速。每引入一个组件,都应能对应一个明确的等待、争抢或空闲问题;如果说不清它改善了哪项指标,就不要仅因为案例里出现过它而照搬。
几个容易混淆的问题
这个案例是不是把训练和推理放进了同一条调度队列?
不是。公开说明强调的是共享统一控制面和异构资源池,同时让训练准入、推理伸缩和资源分配分别承担不同职责。
Kueue、KEDA 和 Prometheus 能互相替代吗?
不能按替代关系理解。案例中 Kueue 面向训练队列与配额,KEDA 和 Prometheus 连接在线推理的伸缩与观测信号,职责边界不同。
五个 LoRA 租户共享一个基础模型后一定能提升五倍吗?
不能。五倍训练密度是官方案例在特定 Twinkle 设置下披露的结果,实际效果还取决于模型、租户、硬件、数据访问和调度条件。
结语
招商银行案例给出的可复用经验,是把“共享硬件”升级为“共享资源池但分离控制逻辑”:Kubernetes 统一基础边界,Kueue 管训练准入,KEDA 与 Prometheus 关注推理需求,HAMi 管异构加速资源,Fluid 减少数据等待,Twinkle 进一步降低多租户微调中的基础模型重复占用。评估这条路线时,先用自己的资源纳管率、等待时间、利用率和单位成本建立基线,再决定引入哪些组件。




