
Go pprof 怎样区分 CPU 样本与墙钟时间
来源:17golang原创
时间:2026-11-02 23:31:22 197浏览 收藏
Go 的 CPU profile 统计采样期间程序消耗 CPU 时的调用栈,pprof 将这些样本聚合为热点;墙钟时间则是从某个起点到终点实际经过的时间。等待网络、休眠、排队都会增加业务耗时,却不会按等待时长计入 CPU 样本。判断时先区分报告中的采集窗口、CPU 样本总量,以及你单独记录的请求或任务耗时,不能只看一个带“秒”的数字。
最小做法是:用 runtime/pprof 写 CPU profile,同时用 time.Now 与 time.Since 围住业务段;再用 go tool pprof 阅读样本类型和调用归属。下文采用“配方—关键读法—变体—坑点”的结构,示例为原创教学代码,未宣称本机实测数据。
Go 官方诊断文档:https://go.dev/doc/diagnostics
CPU 采集接口:https://pkg.go.dev/runtime/pprof
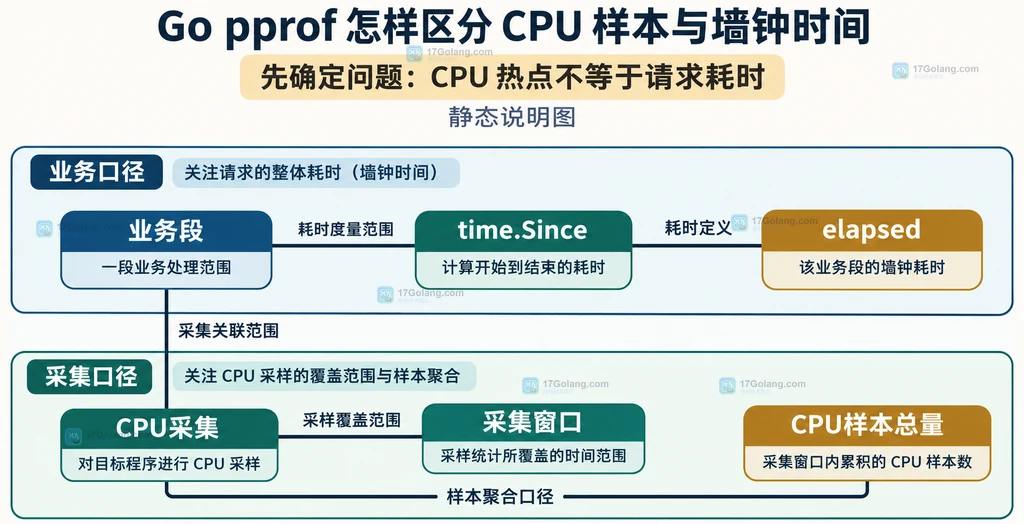
先确定问题:CPU 热点不等于请求耗时
同一个程序里至少有三种时间口径。采集窗口是 profiler 启用到停止所覆盖的区间;业务墙钟时间是你为某次工作定义的起止区间;CPU 样本总量是这个进程在采集期间的 CPU 消耗估计。它们可能接近,也可能差很多。
| 对象 | 回答的问题 | 不能直接推出什么 |
|---|---|---|
| 采集窗口 Duration | 这份 profile 覆盖多长区间 | 其中某个请求的耗时 |
| CPU 样本总量 | 采集中累计消耗多少 CPU | 串行经过多少秒 |
| 业务墙钟时间 elapsed | 指定业务段实际经历多久 | 其中哪一个函数消耗 CPU 最多 |
| 函数 flat / cum | 样本如何归属函数及其下层调用 | 每次调用的精确执行时间 |
CPU profile 面向当前进程,不天然等于一个请求。服务内同时运行的其他请求、后台任务和运行时工作都可能贡献样本。要讨论请求延迟,必须先定义请求的计时范围;要讨论整个采集窗口的 CPU 成本,才看 CPU profile 的总量和热点。
最小配方:一份 CPU 文件加一段业务计时
下面把计算和休眠放在同一个任务里,让“经过时间”与“CPU 消耗”有明确的概念差别。保存为 main.go。休眠用于表达等待,计算结果写到输出,避免只写一个没有可见用途的空循环。
package main

import (
    "fmt"
    "os"
    "runtime/pprof"
    "time"
)

func calculate(seed uint64) uint64 {
    // 让计算结果参与最终输出,保留示例中的实际工作。
    x := seed
    for i := 0; i
采集启动失败时不继续声称文件可用;已经有 CPU profiler 开启也会使启动失败。正常路径中,StopCPUProfile 等待 profile 写入完成,随后关闭文件。这里选择显式停止,是为了把业务计时范围与 profiler 的收尾范围写清楚。
# 构建并运行同一份程序;保留二进制用于符号解析。
go build -o profdemo main.go
./profdemo
# 读取 CPU 样本的文本热点,不需要打开浏览器。
go tool pprof -top -sample_index=cpu ./profdemo cpu.prof
预期可以得到业务段的 elapsed 和采集文件,报告中的热点随机器、调度与采样而变化。不要要求某个函数必须恰好占某个百分比。程序较短时样本可能稀少,可以增加计算轮数后重新采集独立样本,而不能把一次采集中没出现的函数认定为没有成本。
关键读法:样本类型、flat 与 cum
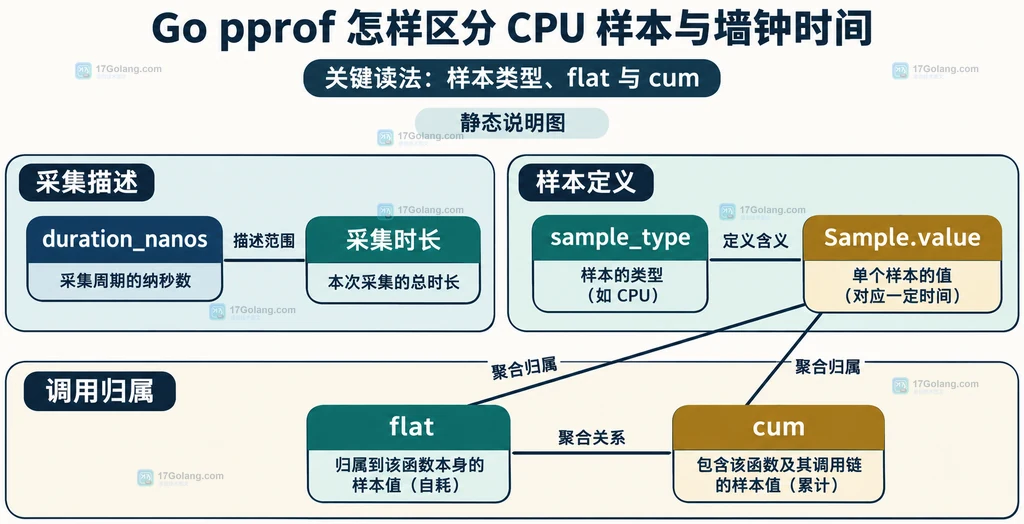
先确认输入是 CPU profile,再确认报告使用 cpu 样本值。pprof 是通用 profile 阅读器,样本值可以代表时间、字节或事件数;选项 sample_index 用来选择已有的样本值,不是把 CPU 数据转换成墙钟数据的开关。没有 wall 样本的文件不能通过改一个参数凭空补出等待时间。
读 top 时,flat 是直接归到当前函数的值,cum 包括其下层调用贡献。父函数的 cum 高、flat 低,通常说明要沿它的下层热点继续看。不要把每一行 cum 相加,它们会覆盖相同的调用栈样本。
# 按累计 CPU 成本排序,观察上层调用所承载的热点。
go tool pprof -top -cum -sample_index=cpu ./profdemo cpu.prof
# 将样本归属到原创示例的计算函数源码。
go tool pprof -list=main.calculate -sample_index=cpu ./profdemo cpu.prof
通常的未过滤 CPU 报告里,函数百分比相对 CPU 样本总量计算,不能解读为请求墙钟时间占比。例如“某函数占 CPU 样本 60%”只说明它在该 CPU 统计口径中的份额。应用筛选、裁剪或不同聚合选项后,还要同时读报告的总量与筛选说明,避免把不同分母的数字横向比较。
profile 中的 duration_nanos 描述采集时长,sample_type 定义样本值的类型和单位,Sample.value 才承载样本数值。采集时长字段不负责给每个函数分配等待时间。这正是报告头部的时间与函数表中的时间不能混用的原因。
两种变体:等待多与并行多
等待多:把示例的休眠拉长,业务墙钟时间会随等待增加;CPU 样本不会按休眠时长等比例增加。网络等待、连接池排队或同步等待也可能带来类似现象,但具体原因仍需对应数据,不能看到 CPU 少就直接断言“都是网络”。
并行多:多个工作线程同时消耗 CPU 时,采集窗口内的累计 CPU 时间可能大于窗口的墙钟时长。作为解释用的假设:若若干执行线程在同一秒内合计使用了约两秒 CPU,CPU 总量大于一秒并不矛盾。这个数字是口径示意,不是本文程序的测量结果。
在同一进程、同一采集窗口且样本充分的前提下,CPU 总量除以窗口时长可以粗略表达平均使用了多少个 CPU 核心的计算能力。它不是“单个请求的 CPU 比例”,也不是已经按机器核心总数或容器配额归一化的监控利用率。业务段的 elapsed 与采集窗口并不完全相同,尤其本例还包含 profiler 收尾。
对比两轮优化时,保持输入、并发、负载、采集时长和构建条件可比,同时看 CPU 绝对量、吞吐与延迟。百分比下降可能只是别的函数变忙;吞吐增加时,进程 CPU 总量上升也不一定意味着每次任务更贵。
常见误判与下一步工具
| 现象 | 先做的判断 | 补充观察 |
|---|---|---|
| 延迟高但 CPU 样本少 | 是否有等待、排队或调度问题 | 业务分段计时、执行 trace |
| 上层函数 cum 很高 | 成本可能落在下层调用 | 结合 flat、源码归属继续阅读 |
| CPU 总量超过窗口时长 | 是否存在并行 CPU 执行 | 并发和运行资源约束 |
| 短任务没有出现热点 | 是否样本不足 | 代表性工作负载与更充分的采集 |
执行 trace 用来观察调度、系统调用、GC 等事件,有助于分析延迟和利用率;CPU profile 更适合先找计算热点。block profile 关注同步阻塞,并非所有外部 I/O 等待的总账;goroutine profile 是栈快照,也不能直接充当一段时间的等待时长。需要时分别采集,避免同时打开多种诊断造成额外干扰。
为什么 sleep 几乎不占 CPU 热点?它主要让 goroutine 等待,相关调用与调度仍可能有少量 CPU 成本,但不会把整段休眠当成持续计算。
火焰图宽度能代表请求耗时吗?先看底层 profile 的样本语义。CPU profile 的宽度表示 CPU 样本权重,不能因为画成火焰图就改成请求耗时。
能从 CPU 总量减去 elapsed 得到等待时间吗?不能。二者的范围、并发累加方式和采样口径不同,差值没有这样的通用含义。
一次采集能否开启两套 CPU profiler?同一进程已开启 CPU 采集时,再次 StartCPUProfile 会失败。让一个采集入口管理生命周期,读取已有文件时不需要重复开启 profiler。
先明确“这次工作用了多久”,再用 CPU profile 解释“CPU 花在哪里”,这两个答案结合起来才有助于选择优化方向。
pprof 官方使用说明:https://github.com/google/pprof/blob/main/doc/README.md
profile 格式说明:https://github.com/google/pprof/blob/main/proto/profile.proto
-
860 收藏
-
843 收藏
-
826 收藏
-
809 收藏
-
792 收藏
-
195 收藏
-
145 收藏
-
330 收藏
-
Golang · Go教程 | 41分钟前 | Go教程 · Go net/http 反向代理 httputil ReverseProxy NewSingleHostReverseProxy Rewrite SetURL435 收藏
-
365 收藏
-
381 收藏
-
177 收藏
-
422 收藏
-
Golang · Go教程 | 49分钟前 | Go教程 · 模块管理 · Go 离线构建 go.work go mod vendor vendor/modules.txt go work vendor Go工作区374 收藏
-
483 收藏
-
266 收藏
-
388 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习