
Redis LATENCY DOCTOR怎样从延迟报告定位事件类型
来源:17golang原创
时间:2026-11-04 11:10:28 246浏览 收藏
我第一次用 Redis 排查间歇性慢请求时,最容易误读的是“延迟报告里出现了一个事件名,就等于找到了根因”。实际上,LATENCY DOCTOR 给的是 Redis 服务端延迟监控的分析报告:它会按事件类型汇总尖峰,给出平均值、偏差、周期和最坏值,再提供下一步建议。
这篇只解决一个问题:怎样从报告里的事件标签定位排查方向。官方地址:https://redis.io/docs/latest/commands/LATENCY-DOCTOR/
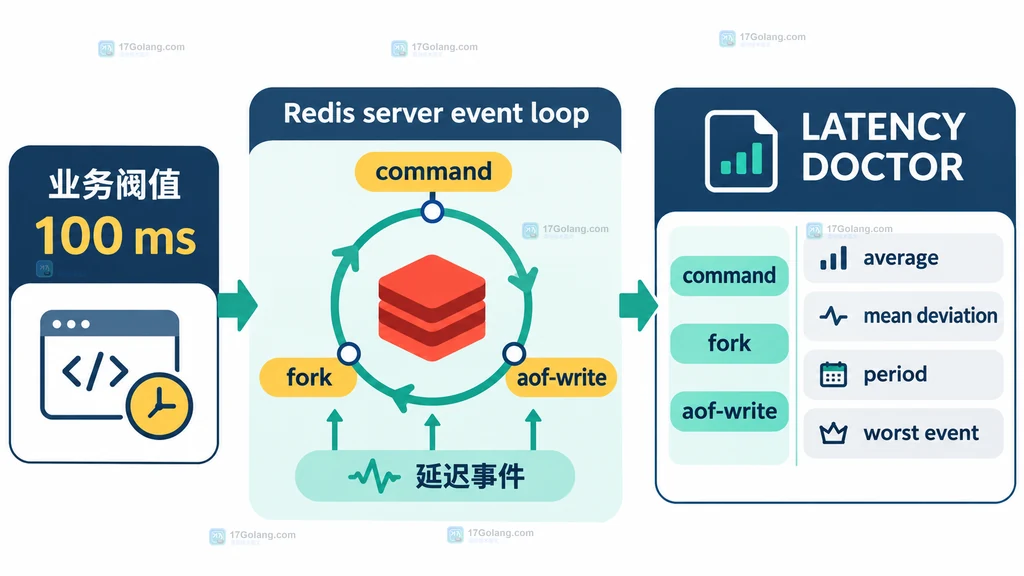
先把延迟阈值设成业务能接受的毫秒数,再运行LATENCY DOCTOR。看到command、fork、aof-write或expire-cycle时,不要直接改配置,要把事件名和统计形态对应到 Slow Log、持久化、磁盘或过期淘汰证据。
先把“基线”设成可解释的阈值
延迟监控默认并不是把所有微小抖动都记下来。Redis 官方文档建议先用 latency-monitor-threshold 设置毫秒阈值,只有超过阈值的事件才会作为延迟尖峰采样。阈值应来自业务目标:如果接口要求 Redis 服务端阻塞不超过 100 毫秒,可以先设置成 100,而不是照搬一个看起来很小的数字。
# 只记录阻塞 Redis 主处理路径达到 100 毫秒的事件
CONFIG SET latency-monitor-threshold 100

# 读取一份人类可读的事件分析报告
LATENCY DOCTOR
这一步的关键不是“阈值越低越好”,而是让报告中的样本与业务故障有可比性。阈值太低,正常调度抖动会淹没真正的问题;阈值太高,又可能看不到用户已经感知的尖峰。
先读事件名,再读后面的统计行
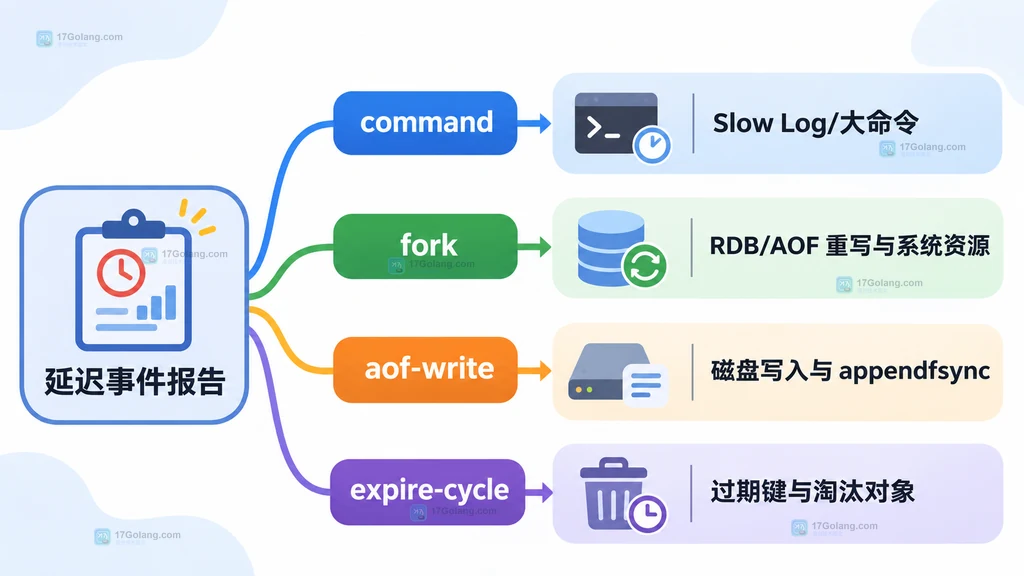
报告中的第一层线索是事件名。典型输出会出现类似 command 的命令执行阻塞、fork 的后台派生进程开销、aof-write 的 AOF 写入,以及与过期或淘汰相关的事件。事件名不是最终结论,但它决定下一步查哪一类证据。
# 示例输出是静态读法,不代表某个实例的真实结果
LATENCY DOCTOR
# 例如:command: 5 latency spikes (average 300ms, mean deviation 120ms, period 73.40 sec)
# 先记下事件名、次数、平均值、偏差、周期和最坏值
# 再回到同一时间窗口查 Slow Log、持久化日志或系统监控
我通常先把报告复制到值班记录里,再单独列出事件名。这样做的好处是不会被后面的自然语言建议带着走:建议告诉你可能的方向,事件标签和统计值才是这次实例的实际观测结果。
用平均值、偏差和周期判断延迟形态
同一个事件名,排查优先级可能完全不同。可以先用下面这张表做粗分:
| 报告字段 | 读法 | 下一步问题 |
|---|---|---|
| 次数 | 尖峰是否反复出现 | 是持续性问题,还是偶发事件 |
| average | 典型尖峰大约多长 | 是否已超过业务超时预算 |
| mean deviation | 尖峰是否离散 | 是否混合了不同根因或负载阶段 |
| period | 是否有固定间隔 | 是否与持久化、批任务或周期性清理重合 |
| worst all time event | 历史最坏一次 | 是否需要单独回看该时刻的系统指标 |
例如,平均 300 毫秒、周期约 73 秒且最坏 500 毫秒,更像重复发生的事件,需要按周期回看;如果平均值很低但最坏值很高,则不能只用平均值宣布“已经正常”。这些数字只是解释字段的示例,真实判断要以你的报告和时间序列为准。
把事件类型分流到对应证据
command:优先检查是否有大集合操作、KEYS 或其他复杂度较高的命令,再结合 Slow Log 看具体命令。LATENCY DOCTOR 只能告诉你命令执行路径出现了尖峰,不能替你判断业务是否应该改成分页、游标或批量操作。
fork:把视线转向 RDB、AOF 重写和操作系统的进程派生成本。重点看实例内存、后台持久化时间和宿主机资源,不要仅凭一次尖峰就关闭持久化。
aof-write:继续查磁盘延迟、写入压力和 appendfsync 配置。AOF 的耐久性选择会影响延迟,调整前要把数据安全目标和恢复策略一起评估。
过期或淘汰相关事件:检查是否有大量键同时过期、对象过大,或 maxmemory 策略触发了集中处理。把大对象拆小可能降低单次阻塞,但会增加读写和管理复杂度。
# 查询最近各事件的样本,帮助确认报告是否仍在增长
LATENCY LATEST

# 查看某个事件的时间序列,event-name 替换成报告中的实际名称
LATENCY HISTORY event-name

# 只有在已经记录好旧样本边界后,才清理指定事件的历史
LATENCY RESET event-name
用 LATEST、HISTORY 和 RESET 形成复查闭环
如果修复后直接再次运行 LATENCY DOCTOR,很容易把修复前的历史尖峰和新样本混在一起。我更倾向于先记录当前报告和时间,然后用 LATENCY LATEST 看最近样本,必要时用 LATENCY HISTORY 看某个事件的变化;确认旧样本边界后,再谨慎使用 LATENCY RESET,让下一轮观察有清晰起点。
复查时至少保留三项:阈值、观察窗口、事件名。比如把阈值从 100 毫秒改成 50 毫秒后,报告里的次数增加并不自动表示系统更差,可能只是采样范围变宽了。前后对比必须保持阈值和观察窗口一致,或者明确写出变化。
哪些问题不能只靠 LATENCY DOCTOR 判断
LATENCY DOCTOR 是服务端延迟监控框架的一部分,不能替代客户端的端到端测量。客户端到 Redis 的网络、连接池排队、线程调度和应用自身序列化,都可能让用户感知到更高延迟,而服务端报告没有对应尖峰。
同样,报告出现 command 也不等于某条命令一定是唯一根因;应把报告时间与 Slow Log、CPU、内存、磁盘和持久化日志对齐。不要为了让报告“变干净”而随意提高阈值、清空历史或关闭监控。
我的排查结论
对我来说,LATENCY DOCTOR 最有价值的不是那段带建议的自然语言,而是把延迟尖峰压缩成可分流的事件类型。稳定的做法是:阈值先贴近业务目标,事件名负责选证据,统计字段负责判断形态,LATEST/HISTORY 负责看变化,RESET 只在记录好边界后使用。
如果你只记一个速查顺序,可以按“LATENCY DOCTOR 看类型 → LATENCY LATEST 看最近样本 → Slow Log/持久化/磁盘/系统指标对齐 → 修复后保持同阈值复查”执行。这样报告才是定位入口,而不是一条孤立的告警文案。
相关问题
- 为什么 LATENCY DOCTOR 没有报告?先检查延迟监控阈值是否为 0,以及当前时间窗口内是否真的出现超过阈值的事件。
- LATENCY DOCTOR 和 SLOWLOG GET 有什么区别?前者按服务端延迟事件做分析,后者聚焦被记录的慢命令,两者应结合时间窗口阅读。
- 修改 latency-monitor-threshold 后要不要重启 Redis?运行时的
CONFIG SET会立即改变监控阈值,但是否持久化到配置文件要按你的发布流程处理。
-
499 收藏
-
234 收藏
-
487 收藏
-
303 收藏
-
404 收藏
-
363 收藏
-
422 收藏
-
459 收藏
-
481 收藏
-
489 收藏
-
498 收藏
-
255 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习