
Transformers Trainer怎样保留自定义字段传入模型
来源:17golang原创
时间:2026-11-04 13:22:13 344浏览 收藏
如果你在 Hugging Face Transformers 的 Trainer 中加入了 sample_weight、group_id 之类的自定义列,却发现它们没有出现在模型输入里,先检查 remove_unused_columns。Trainer 默认会根据模型 forward() 的参数名裁剪数据集列;要保留字段,通常有两条路:关闭这一步裁剪,并让模型能接收该字段;或者直接把字段写进自定义模型的 forward() 签名。
官方地址:https://huggingface.co/docs/transformers/main_classes/trainer
排查的关键不是“数据集有没有这一列”,而是“Trainer 准备 batch 时认为模型需要哪些参数”。字段在数据集里存在,不等于它会自动传给模型。
用Transformers库的Trainer做模型微调时,默认只会把模型forward方法入参声明过的字段传入,想要自己新增的自定义字段也能顺利传到模型内部,只要调整数据处理、训练流程的对应环节适配就能实现。
不需要修改Trainer核心源码,优先通过自定义数据整理函数过滤保留需要的自定义字段,再配合覆写compute_loss或者训练步骤的逻辑,就能把自定义字段透传给模型。
先确认字段在哪一步消失
先把问题拆成三层:数据集原始列、Trainer 组装后的 batch,以及模型 forward() 实际接收的关键字参数。官方文档说明,传入普通 Dataset 时,不被 model.forward() 接受的列会被自动移除。假设数据集有 input_ids、attention_mask、labels 和 sample_weight,而模型签名只有前三个参数,那么 sample_weight 可能在进入 data collator 或模型之前就不见了。
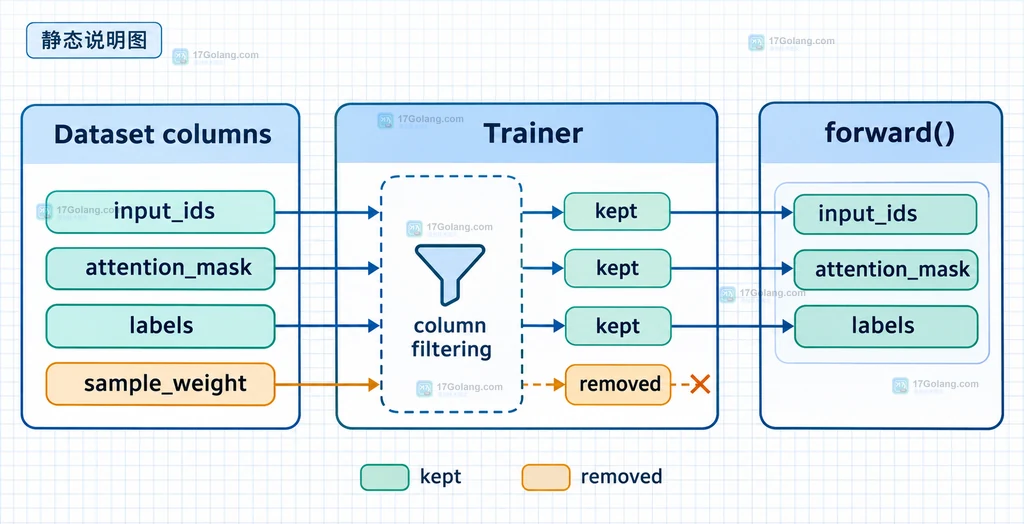
可以先用一个最小的 batch 检查列名,但不要把“打印数据集列名”当成最终结论。真正有用的对照是:模型参数列表里有没有同名参数,以及训练参数是否允许未使用列继续流转。
改法一:关闭自动列裁剪
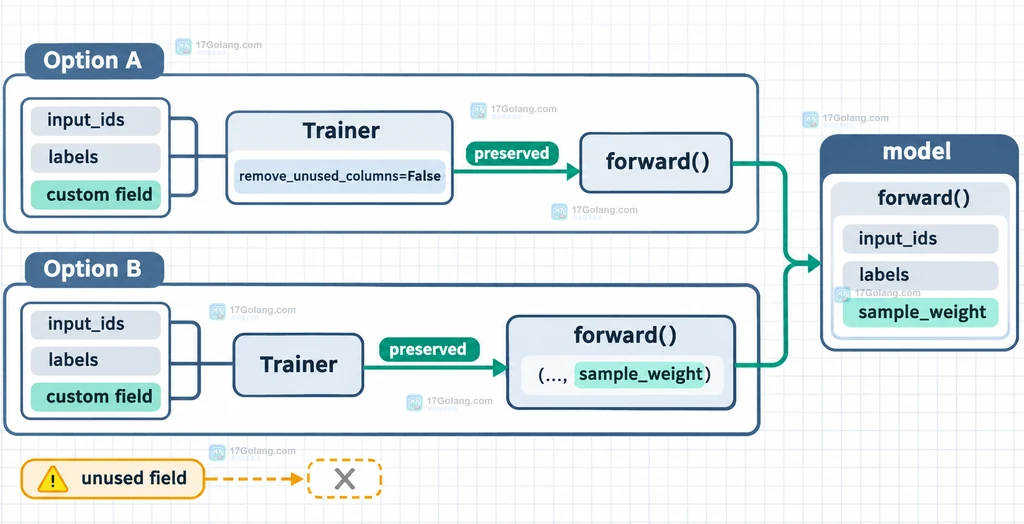
如果你希望自定义字段完整保留到 data collator 和模型调用阶段,可以在 TrainingArguments 中设置 remove_unused_columns=False。但这个选项只负责“不删除”,不会替你修改模型签名。模型仍然要能接收传入的关键字,否则下一步会变成 unexpected keyword argument。
from transformers import TrainingArguments

# 保留数据集中的自定义列,后续由模型决定如何处理
training_args = TrainingArguments(
    output_dir="./runs/weighted",
    remove_unused_columns=False,
    per_device_train_batch_size=8,
)

# 数据集中的 sample_weight 会继续留在 batch 中
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=train_dataset,
)
这条路适合 data collator 还要使用额外列,或者模型接口本来就准备接收多个扩展字段的场景。代价是所有列都会更容易流到模型调用处,字段命名、类型和清理责任要由你自己承担。
改法二:让 forward 显式接收自定义字段
如果只想让某个字段进入模型,通常更清晰的方式是把它加入自定义模型的 forward()。Trainer 会根据参数名识别它,列裁剪仍然可以保持默认行为。下面用加权分类损失示意,sample_weight 被声明为可选参数,然后在模型内部参与 loss 计算。
import torch
import torch.nn.functional as F
from transformers.modeling_outputs import SequenceClassifierOutput

class WeightedClassifier(torch.nn.Module):
    def __init__(self, base_model):
        super().__init__()
        self.base_model = base_model

    def forward(self, input_ids=None, attention_mask=None,
                labels=None, sample_weight=None):
        # 只把基础模型需要的标准字段传下去,避免额外字段继续扩散
        outputs = self.base_model(
            input_ids=input_ids,
            attention_mask=attention_mask,
        )
        if labels is None:
            # 预测阶段没有标签时,直接返回 logits
            return SequenceClassifierOutput(logits=outputs.logits)

        # 逐样本计算损失,便于应用自定义权重
        per_item_loss = F.cross_entropy(outputs.logits, labels, reduction="none")
        if sample_weight is None:
            loss = per_item_loss.mean()
        else:
            # 权重要放到同一设备,并防止权重总和为零
            weights = sample_weight.to(per_item_loss.device).float()
            loss = (per_item_loss * weights).sum() / weights.sum().clamp_min(1e-8)
        return SequenceClassifierOutput(loss=loss, logits=outputs.logits)
这里的重点是参数名完全匹配:数据集列叫 sample_weight,forward() 也叫 sample_weight。若列名是 weight,就要同步调整签名或在数据整理阶段完成一次明确的重命名,不要依赖位置顺序猜测。
按现象排查配置和签名
字段消失和字段报错是两个不同阶段的问题。字段消失通常说明 Trainer 仍在按默认规则裁剪;字段报错则常见于关闭裁剪后,模型没有对应参数。可以按下面的顺序排查:
| 现象 | 优先检查 | 处理方向 |
|---|---|---|
| batch 中没有自定义列 | remove_unused_columns 是否仍为默认值 | 关闭裁剪,或把字段写入 forward 签名 |
| 出现 unexpected keyword argument | 模型 forward 是否能接收该列名 | 增加同名可选参数,或不要关闭全量裁剪 |
| 字段到了模型但 loss 不变 | 自定义字段是否真正参与计算 | 确认权重、掩码或辅助特征在 forward 内被使用 |
| 训练阶段正常、预测阶段异常 | labels 或自定义字段是否被无条件使用 | 为无标签分支返回合法的 logits 或 ModelOutput |
实际选择上,如果扩展字段只服务一个明确模型,优先显式写进 forward();如果字段还要经过自定义 collator 或多个模型层级,才考虑关闭自动列裁剪。无论采用哪条路,都要让数据列名、collator 输出键和 forward 参数保持一致。
常见问题
只设置 remove_unused_columns=False 就一定能传入字段吗?
不一定。它只是不再提前删除列;如果模型不接受这个关键字,调用时仍会报参数错误。还需要扩展模型签名,或者在 collator 中把该字段转换为模型已经支持的输入。
可以把 sample_weight 写成 **kwargs 接收吗?
可以作为兜底,但不如显式参数直观。Trainer 是按签名判断列是否被使用的,明确写出 sample_weight=None 更容易让列裁剪保留它,也更方便读代码的人确认字段用途。
参考地址:https://huggingface.co/docs/transformers/main_classes/trainer
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
科技周边 · 人工智能 | 56分钟前 | 性能优化 · 人工智能 · 深度学习 · PyTorch CUDA SDPA scaled_dot_product_attention Flash Attention214 收藏
-
科技周边 · 人工智能 | 57分钟前 | 性能优化 · python · ONNX Runtime InferenceSession SessionOptions 图优化 Execution Provider281 收藏
-
414 收藏
-
157 收藏
-
234 收藏
-
135 收藏
-
230 收藏
-
312 收藏
-
458 收藏
-
394 收藏
-
科技周边 · 人工智能 | 2小时前 | python · 人工智能 · gemini · 结构化输出 · Pydantic JSON Schema Gemini API google-genai structured output136 收藏
-
486 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习