
ONNX Runtime怎样为推理启用图优化
来源:17golang原创
时间:2026-11-04 13:35:44 281浏览 收藏
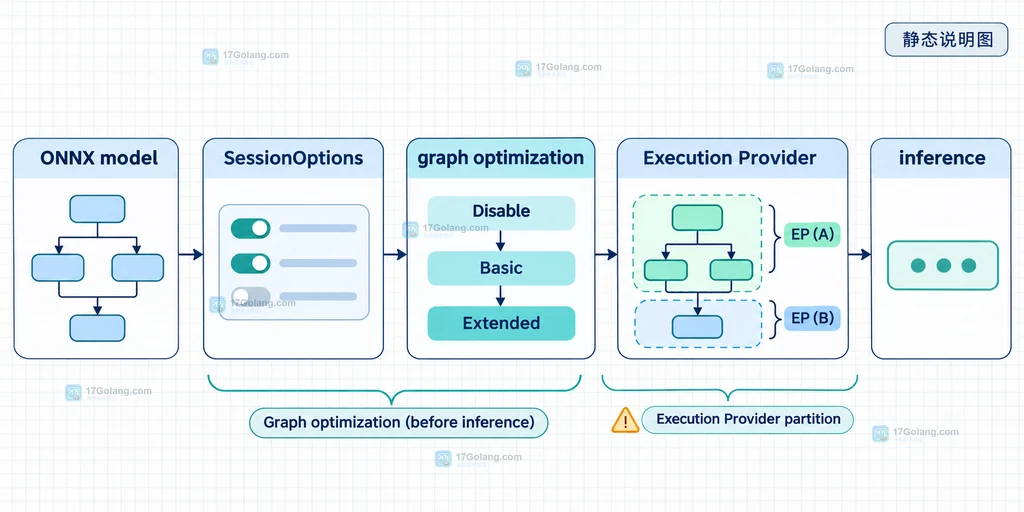
如果你只是把 ONNX 模型交给 onnxruntime.InferenceSession,运行时通常已经会做一部分图优化;但在需要明确控制初始化开销、保存优化结果或排查执行提供者差异时,最好把配置写出来。核心做法是先创建 SessionOptions,设置 graph_optimization_level,再把它传给推理会话。
官方地址:https://onnxruntime.ai/docs/performance/model-optimizations/graph-optimizations.html
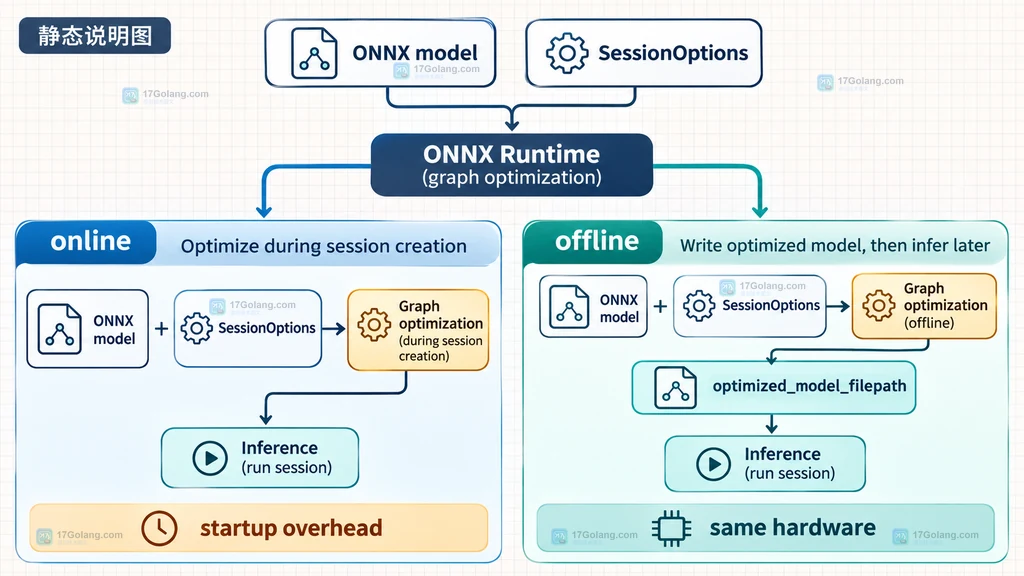
图优化等级是累积关系:Extended 会包含 Basic,All 会在前面等级基础上继续启用可用的布局优化。一次性推理可以在线优化;频繁启动的服务则可以考虑先离线保存优化模型。
先分清图优化发生的时机
ONNX Runtime 的图优化不是把模型权重重新训练一遍,而是对计算图做常量折叠、冗余节点消除和节点融合等变换。在线模式下,这些工作发生在创建 InferenceSession 的过程中,随后才进入正常推理;因此第一次启动可能多出初始化时间。
这也是我在服务部署中先区分“启动频率”和“模型是否固定”的原因:开发脚本、一次性任务用在线模式更简单;模型固定且进程会频繁重启时,离线生成优化模型更值得考虑。
用 SessionOptions 显式设置优化等级
Python API 中可以用 GraphOptimizationLevel 选择等级。下面的例子把配置集中在会话创建前,便于把同一份设置放进服务启动代码:
import onnxruntime as ort

# 创建会话配置,并显式打开全部可用的图优化
sess_options = ort.SessionOptions()
sess_options.graph_optimization_level = ort.GraphOptimizationLevel.ORT_ENABLE_ALL

# 这里的 providers 只是示例;应替换为部署环境实际可用的执行提供者
session = ort.InferenceSession(
    "model.onnx",
    sess_options=sess_options,
    providers=["CPUExecutionProvider"],
)

# 读取模型输入名,后续按真实输入构造 feed_dict
input_name = session.get_inputs()[0].name
print(input_name)
如果担心某些布局变换与目标环境不匹配,可以先从 ORT_ENABLE_BASIC 开始;需要更多融合时再使用 ORT_ENABLE_EXTENDED。ORT_ENABLE_ALL 并不等于对任何模型都必然更快,最终仍要结合目标执行提供者和实际负载测量。
在线优化和离线优化怎样选
离线模式的关键是让会话把优化后的图写到指定路径。第一次准备模型时仍然需要创建会话,让 ONNX Runtime 完成优化;之后可以加载这个优化文件,减少每次启动重复优化的成本:
import onnxruntime as ort

# 第一次准备阶段:优化原始模型,并把结果写到磁盘
prepare_options = ort.SessionOptions()
prepare_options.graph_optimization_level = ort.GraphOptimizationLevel.ORT_ENABLE_ALL
prepare_options.optimized_model_filepath = "model.optimized.onnx"

# 创建会话会触发优化和序列化;该会话只用于生成离线文件
ort.InferenceSession("model.onnx", prepare_options, providers=["CPUExecutionProvider"])

# 生产启动阶段:复用已经优化的模型,避免再次做同一轮图优化
runtime_options = ort.SessionOptions()
runtime_options.graph_optimization_level = ort.GraphOptimizationLevel.ORT_DISABLE_ALL
session = ort.InferenceSession(
    "model.optimized.onnx",
    runtime_options,
    providers=["CPUExecutionProvider"],
)
在线模式适合模型或运行环境经常变化的场景,配置少、流程直观。离线模式适合模型固定、启动次数多的服务,但要把优化文件当作特定运行环境的构建产物管理,不能随意从一台机器复制到完全不同的执行环境。
检查执行提供者与硬件边界
离线优化最容易被忽略的边界是“在哪个执行环境生成”。官方文档提示,离线模式应使用与目标推理相同的执行提供者、优化等级和硬件条件;例如针对 GPU 执行提供者生成的结果,不应直接当作纯 CPU 环境的通用文件。启用布局优化时,CPU 指令集差异也可能影响可移植性。
因此可以把下面几项写进发布清单:
- 优化文件记录原始模型版本、ONNX Runtime 版本和执行提供者。
- 生成和加载优化文件时保持优化等级与关键 SessionOptions 一致。
- 模型、输入形状或硬件改变后重新生成,不把旧文件当作永久缓存。
- 用目标业务输入分别观察初始化时间、单次延迟和输出正确性,不只看节点数量。
常见误区与速查
| 场景 | 建议 | 原因 |
|---|---|---|
| 一次性脚本 | 在线设置 Basic 或 Extended | 减少额外构建产物,流程更简单 |
| 固定模型的频繁启动服务 | 离线保存优化模型 | 避免每次创建会话重复优化 |
| 不同硬件或执行提供者 | 分别生成并管理优化文件 | 优化结果可能依赖执行环境 |
| 优化后速度没有变化 | 检查实际执行提供者和输入形状 | 图优化不是所有瓶颈的来源 |
简单记忆就是:先用 SessionOptions 把等级写清楚;启动成本敏感时再使用 optimized_model_filepath;一旦换了执行提供者或硬件,就重新生成并按真实负载比较。
相关问题
启用 ORT_ENABLE_ALL 一定比 ORT_ENABLE_BASIC 快吗?
不一定。All 包含更多优化,但收益取决于模型结构、执行提供者和输入形状,应该以目标环境的实际测量为准。
离线优化模型能跨机器直接复制吗?
不能把它当成无条件可移植文件。至少要核对执行提供者、运行时选项和硬件指令集;不确定时在目标环境重新生成。
-
科技周边 · 人工智能 | 1小时前 | 性能优化 · 人工智能 · 深度学习 · PyTorch CUDA SDPA scaled_dot_product_attention Flash Attention214 收藏
-
414 收藏
-
157 收藏
-
234 收藏
-
135 收藏
-
230 收藏
-
344 收藏
-
312 收藏
-
458 收藏
-
394 收藏
-
科技周边 · 人工智能 | 2小时前 | python · 人工智能 · gemini · 结构化输出 · Pydantic JSON Schema Gemini API google-genai structured output136 收藏
-
486 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习