
vLLM 怎样限制批处理显存上限
来源:17golang原创
时间:2026-11-07 23:24:31 265浏览 收藏
如果你的目标是“让 vLLM 每轮少处理一些请求”,不要只调 gpu_memory_utilization。这个参数划定的是单个 vLLM 实例可使用的设备显存比例;批处理规模要交给调度器参数。最小可用组合通常是 --max-num-batched-tokens 加 --max-num-seqs,在线服务再补上运行中请求和排队上限。
官方地址:https://docs.vllm.ai/en/latest/configuration/engine_args/
gpu-memory-utilization控制显存预算,不直接等于批处理条数。max-num-batched-tokens限制单轮 token 总量,max-num-seqs限制单轮序列数。- 线上还要限制 active、queued 请求,否则单轮受控但入口仍可能堆积。
先把显存上限和批处理上限分开
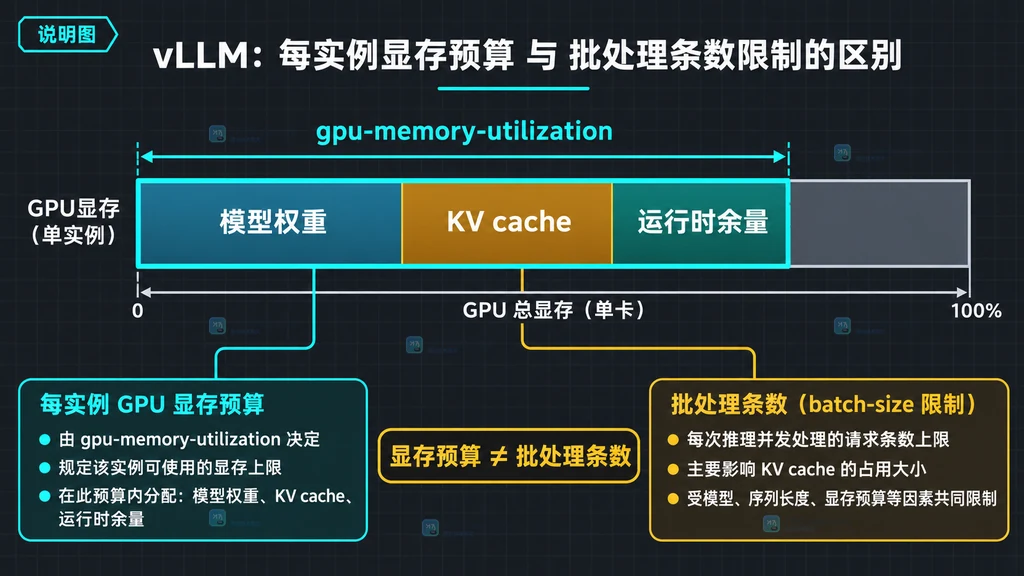
vLLM 需要在模型权重、激活、KV cache 和运行时缓冲之间分配显存。--gpu-memory-utilization 0.80 的含义是给当前实例一个约 80% 的设备显存预算,且是按实例计算;它不会告诉调度器“一次最多跑 8 条请求”。同一块 GPU 上有多个 vLLM 实例时,还必须把各实例预算与 CUDA、驱动和其他进程的余量一起算。
如果希望直接固定 KV cache 的字节数,可以使用 --kv-cache-memory-bytes。它比比例参数更细,但设置后会忽略 gpu_memory_utilization,因此不能把两者当成叠加额度。通常先用比例参数做部署基线,只有硬件规格固定、需要精确复现时再切到字节数。
用两个调度参数限制单轮批量
一个稳妥的启动基线如下,数字只是示例,应该根据模型和显卡压测调整:
# 用显存比例留出实例预算,并限制单轮 token 与序列数
vllm serve Qwen/Qwen2.5-7B-Instruct \
  --gpu-memory-utilization 0.82 \
  --max-num-batched-tokens 4096 \
  --max-num-seqs 16 \
  --max-model-len 8192
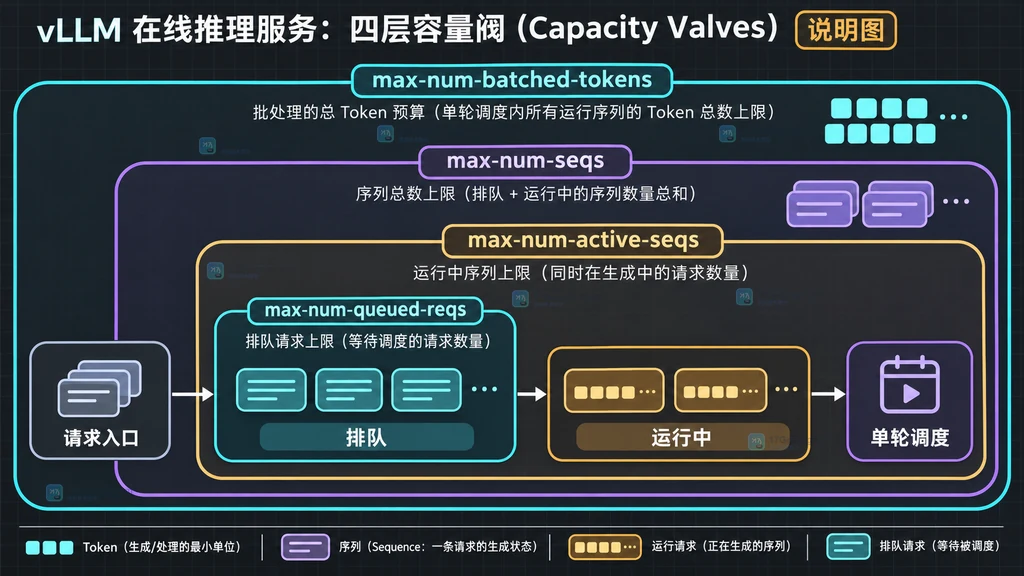
max-num-batched-tokens 是单次迭代允许处理的 token 总量,长输入会更快吃满这个额度;max-num-seqs 是单次迭代的序列数量上限。两者取更紧的那个约束:短 prompt 可能先碰到序列数,长 prompt 可能先碰到 token 数。不要把 max-num-seqs 单独调得很大来“提高并发”,这会增加每请求缓冲和模型运行器的容量压力。
在线服务还要卡住运行中和排队中的请求
单轮批处理已经受限,并不代表入口没有积压。生产服务可以这样加一层容量阀:
# 限制运行中请求和 API 进程看到的排队请求
vllm serve Qwen/Qwen2.5-7B-Instruct \
  --max-num-batched-tokens 4096 \
  --max-num-seqs 16 \
  --max-num-active-seqs 12 \
  --max-num-queued-reqs 32
max-num-active-seqs 必须不大于 max-num-seqs,它降低的是进入 RUNNING 的请求数;max-num-queued-reqs 则限制等待或运行中的请求总数,达到上限时新请求会收到 HTTP 503,客户端需要重试或切换实例。多数据并行时,队列上限按 API 进程统计,不能简单当成单卡的并发数。
发布前的参数检查清单
| 目标 | 优先参数 | 观察点 |
|---|---|---|
| 减少单轮 token 峰值 | max-num-batched-tokens | TTFT、吞吐、长 prompt 等待 |
| 减少单轮请求数 | max-num-seqs | 运行器容量与 decode 批量 |
| 固定显存预算 | gpu-memory-utilization | KV cache 容量、显存余量 |
| 防止入口堆积 | max-num-active-seqs、max-num-queued-reqs | 503 比例与队列长度 |
排查 OOM 时先降低 token 上限或上下文长度,再看是否需要降低序列数;如果 KV cache 空间不足,降低比例只会让可用 cache 更小。每次只改一组参数,记录显存峰值、P95 TTFT、吞吐和抢占日志,确认结果后再扩大批量。
常见问题
只设置 gpu-memory-utilization 能限制批处理吗?
不能。它限制实例使用的设备显存比例,批处理数量还要由 token 和序列调度参数共同限制。
max-num-batched-tokens 和 max-num-seqs 该先调哪个?
长输入服务优先关注 token 总量;请求长度较短但并发很高时优先关注序列数,生产中通常同时设置并通过压测找平衡点。
为什么批量受限后仍然会 503?
可能是排队请求超过 max-num-queued-reqs,也可能是上游重试造成瞬时拥塞。检查 API 层队列和客户端重试策略,不要只看 GPU 利用率。
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
158 收藏
-
400 收藏
-
500 收藏
-
102 收藏
-
145 收藏
-
212 收藏
-
307 收藏
-
444 收藏
-
296 收藏
-
248 收藏
-
322 收藏
-
212 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习