
AI 原生基础设施为什么需要更细的资源隔离
来源:17golang原创
时间:2026-11-07 23:55:35 444浏览 收藏
AI 原生基础设施需要更细的资源隔离,因为同一平台上可能同时运行训练、推理、数据处理和交互开发任务。它们争用的不只是GPU数量,还包括显存、CPU、内存和存储吞吐;单靠租户配额或容器数量,无法描述所有运行边界。
一个值得关注的生态进展是:NVIDIA 在2026年10月27日介绍了基于 CUDA 13.4 的显存边界执行及 GPU Fractioning Operator 与 KAI Scheduler 的协作方案。这说明资源管理正在向工作负载级约束细化,但不能由此推断任何 Kubernetes 集群已经默认具备同样能力。
Kubernetes 官方地址:https://kubernetes.io/
NVIDIA 开发者官方地址:https://developer.nvidia.com/
先把配额与运行边界分开
ResourceQuota约束namespace内的资源声明总量,是准入层的治理机制。requests帮助调度器判断资源需求,容器的CPU和内存limits则影响运行时资源使用。它们相关,却不是同一项功能。
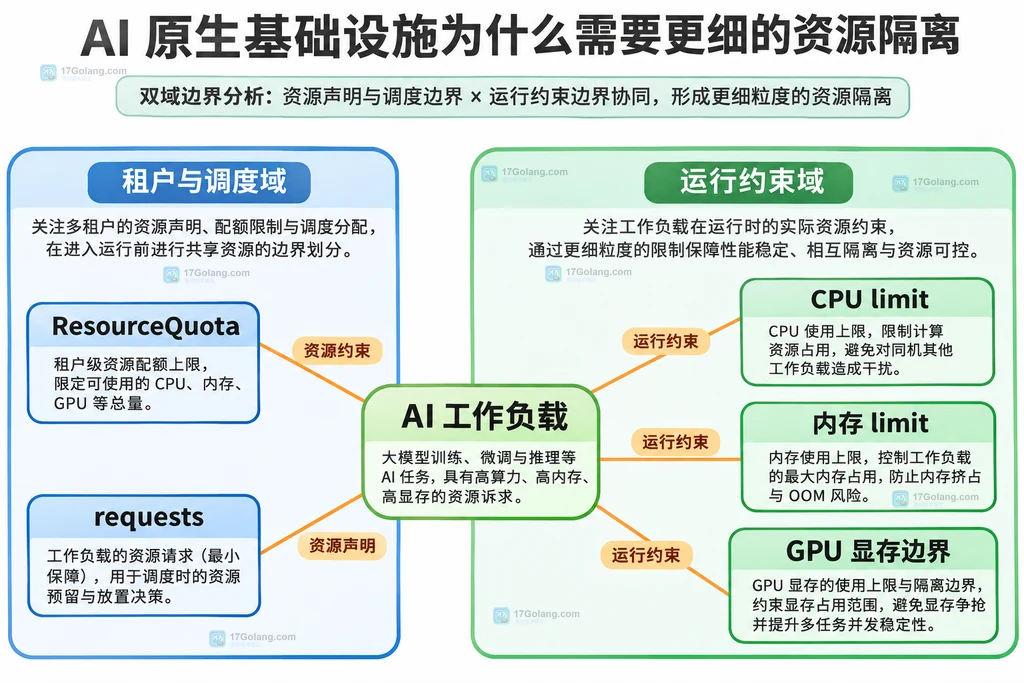
CPU limit可能表现为CPU使用被节流;内存limit由内核等机制执行,超限可能导致OOM终止。它们不应被写成“同样超一点就立即拒绝”。更不能把容器的memory字段理解为GPU显存限制,普通主机内存与设备显存属于不同资源。
因此,平台设计至少要回答:租户允许声明多少、任务需要保留多少、运行中允许增长多少,以及超出后发生什么。相关定义见 Kubernetes ResourceQuota与容器资源管理文档。
用一个小配额例子理解准入限制
下面是一份供测试namespace使用的CPU与内存配额示意。它没有申请GPU,也没有创建工作负载;数字仅用于解释字段,不是生产环境推荐值。已有测试namespace和适当权限的读者可将其纳入自己的实验,本文未执行该配置。
apiVersion: v1
kind: ResourceQuota
metadata:
  name: ai-lab-quota
  namespace: ai-isolation-lab
spec:
  hard:
    # 约束整个 namespace 的 requests 汇总
    requests.cpu: "2"
    requests.memory: 4Gi
    # 约束 limits 汇总,不等于预留一台独占节点
    limits.cpu: "4"
    limits.memory: 8Gi
设置这类CPU与内存配额后,任务的资源字段应与准入要求相符;必要时用LimitRange提供默认值。检查时不仅看hard值,还要看used以及创建Pod时的实际错误。配额耗尽导致的拒绝,和已经创建的Pod等待节点资源,不是相同状态。
# 替换为你的测试 context,只读取配额与容器默认限制
kubectl --context lab-cluster -n ai-isolation-lab describe resourcequota ai-lab-quota
kubectl --context lab-cluster -n ai-isolation-lab get limitranges
# 观察测试任务状态,不把 Pending 自动归因于配额
kubectl --context lab-cluster -n ai-isolation-lab get pods
清理实验时只删除自己创建的测试对象;共享namespace的配额可能服务其他任务,不能为了某个Pod启动失败就移除整个团队的限制。
共享 GPU 时,资源名称不能替代机制说明
将一张GPU暴露为多个可申请份额,不等于每个份额自动拥有独立显存和故障域。传统time-slicing强调时间复用;MIG则在支持的硬件与配置下划分实例。选择共享机制时,应明确硬件、软件版本及工作负载兼容条件,不能只在资源名称里写“隔离GPU”。
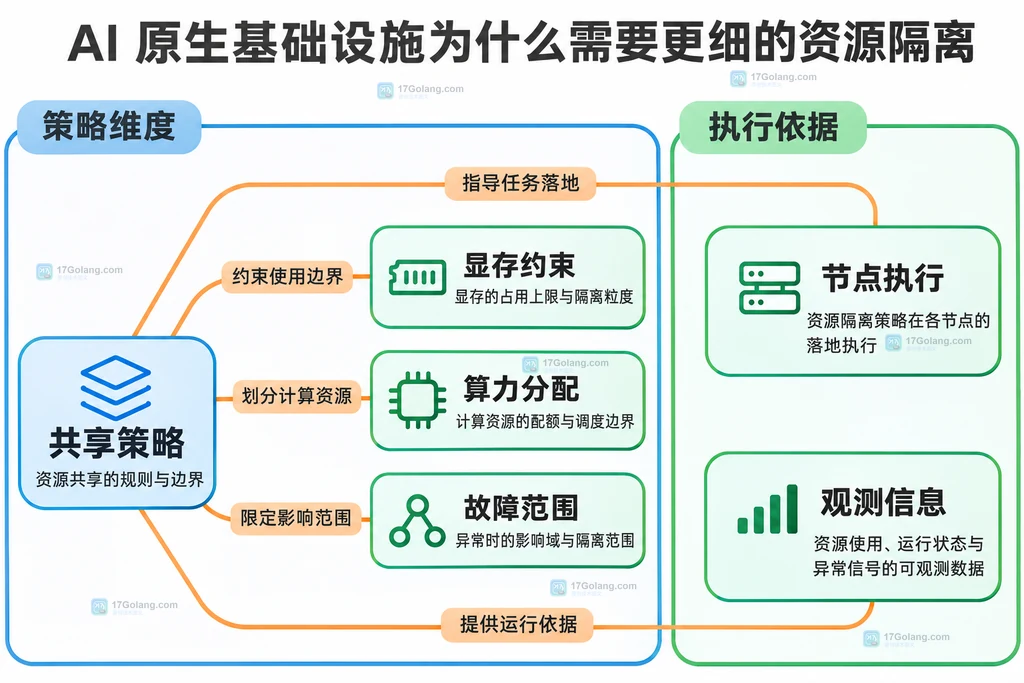
NVIDIA的上述文章介绍了另一条实现路径:调度器记录容器的显存分配及计算模式,GPU Fractioning Operator在节点侧配合CUDA执行相应限制并观察份额使用。这体现了声明、放置和执行的分工。它依赖完整的软件栈,不是给普通Pod增加一行通用memory字段就完成。
显存约束、算力分配、故障范围和安全隔离也应分开讨论。能限制显存,不代表共享GPU在所有维度都等价于独占设备;需要强隔离的负载,应根据威胁模型与硬件支持进一步选择独占节点、设备或其他措施。具体方案依据见 NVIDIA 官方GPU共享文章,MIG能力见GPU Operator文档。
再检查输入、存储与身份的相互影响
训练任务通常还要读取数据、解码样本、写检查点;推理则可能受模型加载、缓存增长和并发请求影响。因此,即使GPU份额划分合理,CPU解码或存储写入的争用仍可能拖慢另一任务。应根据实际任务测量决定是否分离数据处理、训练和在线推理资源池。
身份和数据访问同样不是CPU/GPU配额能解决的问题。namespace有助于组织资源,但数据权限、网络访问和凭据管理还需要相应控制;不要用“配额已分开”来证明不同租户无法访问彼此数据。
这里的工程建议是把资源边界和访问边界分别列清:资源问题关注谁会抢占谁的容量,访问问题关注谁能读写哪些对象。两者都需要,但验收方式不同。
把隔离要求写成可观察的结果
| 问题 | 应观察什么 | 不能据此推断什么 |
|---|---|---|
| 声明是否受控 | 配额hard/used与准入错误 | 节点一定有空闲资源 |
| 容器运行是否受限 | CPU节流、内存及终止原因 | GPU显存也被同样限制 |
| GPU共享是否符合约定 | 份额用量与节点执行组件状态 | 所有故障与安全风险都已隔离 |
| 服务是否可预测 | 延迟、吞吐、失败率与共置条件 | 任何模型都获得相同收益 |
先在受控环境做小负载对照,记录模型版本、输入形状、并发和共置任务,再比较边界是否按预期生效。不必用危险的大规模内存耗尽实验作为第一步;先确认配置真正由节点组件执行,再扩展负载。
更细的隔离一定更省钱吗?不一定。共享可以提高利用率,也会增加管理与观测成本;应按工作负载比较。
GPU申请份额能直接换算吞吐比例吗?不能。计算模式、内存、模型和共置条件都会影响性能,不能把资源比例当性能承诺。
需要所有任务都使用同一种隔离方式吗?不需要。在线服务、离线训练及开发试验的目标不同,应分别定义可接受的争用和故障影响。
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
377 收藏
-
123 收藏
-
279 收藏
-
196 收藏
-
426 收藏
-
336 收藏
-
332 收藏
-
179 收藏
-
228 收藏
-
170 收藏
-
469 收藏
-
372 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习