
Transformers 怎样取得特殊 token 的位置掩码
来源:17golang原创
时间:2026-11-10 13:15:07 367浏览 收藏
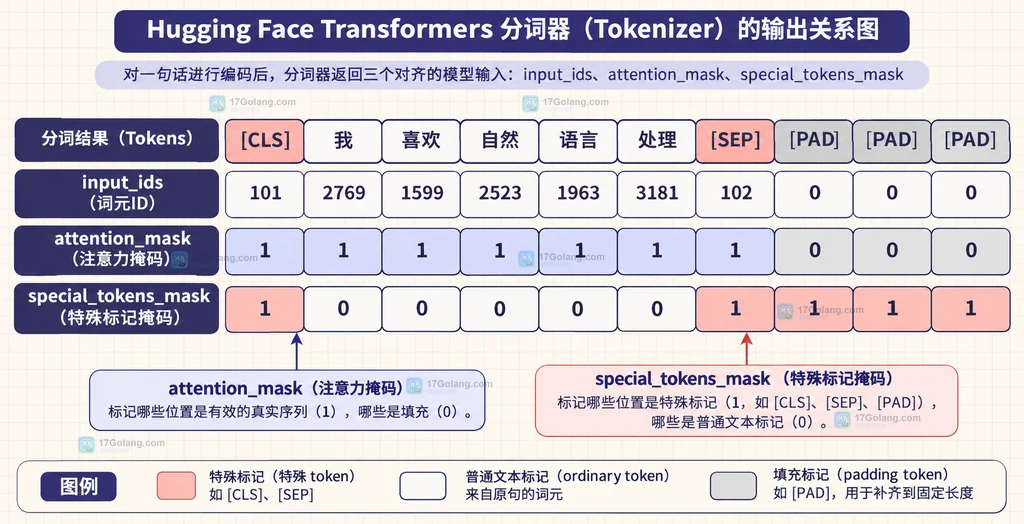
需要在 Transformers 的编码结果中找出 [CLS]、[SEP]、[PAD] 这些特殊 token 时,直接在 tokenizer 调用里加上 return_special_tokens_mask=True。返回的 special_tokens_mask 与 input_ids 等长,值为 1 的位置就是特殊 token,值为 0 的位置才是普通序列 token。它和 attention_mask 不是一回事:后者主要回答“这个位置是否参与注意力”,前者回答“这个位置是不是特殊 token”。
先用 tokenizer 返回的掩码做定位,不要用 attention_mask 猜特殊 token。批量 padding 时,[PAD]往往同时表现为attention_mask=0和special_tokens_mask=1,但两列表达的语义仍然不同。
先分清三种 mask 的职责
以 BERT 类 tokenizer 为例,一次编码通常至少会看到三组字段:
| 字段 | 它描述什么 | 常见用途 |
|---|---|---|
input_ids | 模型真正接收的 token ID 序列 | 送入模型或保存批次 |
attention_mask | 位置是否是有效输入 | 忽略 padding,控制注意力范围 |
special_tokens_mask | 位置是否为 tokenizer 加入或识别的特殊 token | 过滤特殊 token、对齐文本、构造标签 |
代码中的关键参数很短,但要保留中文注释,方便把字段的目的和清理边界一起看懂:
from transformers import AutoTokenizer

# 使用与模型匹配的 tokenizer;实际项目可替换为已审核的本地模型目录
tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")

# 返回特殊 token 掩码;padding 只为展示对齐效果
encoded = tokenizer(
    "A small example",
    padding="max_length",
    max_length=8,
    truncation=True,
    return_special_tokens_mask=True,
    return_tensors="pt",
)

# 这三列按同一位置对齐,便于后续过滤或生成标签
print(encoded["input_ids"])
print(encoded["attention_mask"])
print(encoded["special_tokens_mask"])
对一个具体 tokenizer,掩码的长度应与 input_ids 一致。不要把某个模型的 [CLS]、[SEP] 位置硬编码到所有模型上,因为不同架构可能使用 [BOS]、[EOS] 或其他模板。
正常编码时怎样取得位置掩码
最稳妥的方式是让 tokenizer 在添加模型所需特殊 token 的同时返回掩码:
# 返回原始 token 字符串,便于人工检查掩码是否对齐
tokens = tokenizer.convert_ids_to_tokens(encoded["input_ids"][0])
mask = encoded["special_tokens_mask"][0].tolist()

# 只保留普通序列 token;不要用 attention_mask 替代这里的判断
content_tokens = [token for token, is_special in zip(tokens, mask) if is_special == 0]
print(content_tokens)
return_special_tokens_mask 的默认值是关闭的,所以忘记显式传入时,编码结果里可能没有这一个字段。已经使用 BatchEncoding 的项目也应把它当作可选输出处理,而不是假定每个模型都默认返回。
如果目标是把模型输出对齐回原句,还要区分“特殊 token”与“子词 token”。例如一个英文单词可能被拆成多个 token,它们的 special_tokens_mask 都是 0;这个掩码并不负责恢复词边界,词边界应使用 fast tokenizer 的 offset 或 word mapping。
句对、padding 与已格式化 ID 的边界
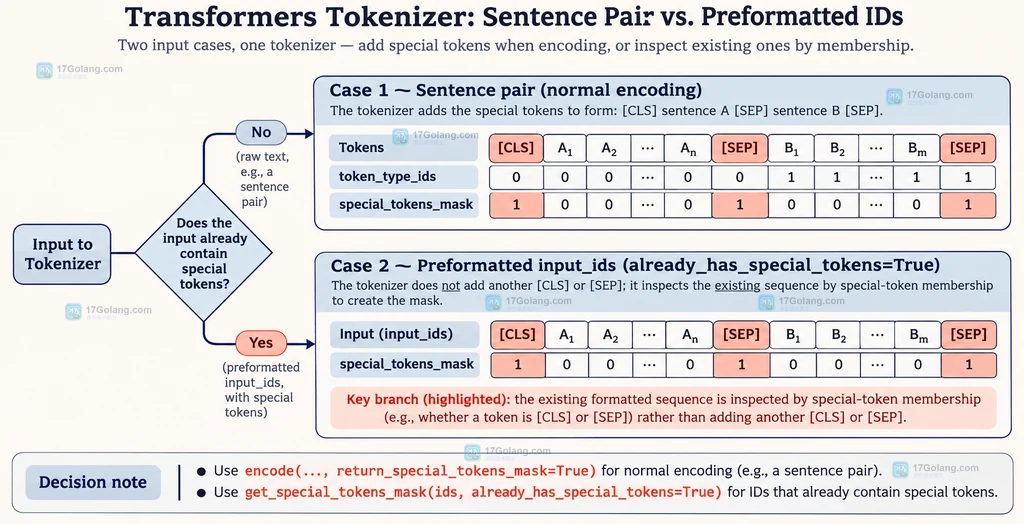
句对会让特殊 token 的布局依赖模型模板。常见结构是 [CLS] A [SEP] B [SEP],但不要自行假定每个 tokenizer 都如此。直接把两段文本传给 tokenizer,才能让对应的模板和掩码同步生成:
# 让 tokenizer 自己决定句对模板,避免手动拼错分隔 token
pair = tokenizer(
    "first sentence",
    "second sentence",
    truncation=True,
    padding=True,
    return_special_tokens_mask=True,
)

# sequence_ids 还能区分句对来源;None 通常对应特殊 token 或 padding
sequence_ids = pair.sequence_ids(0)
special_mask = pair["special_tokens_mask"]
print(sequence_ids)
print(special_mask)
批量 padding 时尤其容易混淆:attention_mask=0 表示该位置是 padding、模型不应关注;special_tokens_mask=1 表示该位置属于特殊 token。两者通常在 padding 处同时为 1 和 0,但用途不同。若任务只是屏蔽 padding,用 attention mask;若任务要去掉 [CLS]、[SEP]、[PAD] 等特殊 token,用 special token mask。
如果手里已经有包含特殊 token 的完整 ID 列表,不要再次调用会自动添加模板的编码路径。可以直接让 tokenizer 根据现有 ID 判断:
# ids 已经包含模型模板中的特殊 token,因此声明它已格式化
formatted_ids = pair["input_ids"]
existing_mask = tokenizer.get_special_tokens_mask(
    formatted_ids,
    already_has_special_tokens=True,
)

# 结果与 formatted_ids 对齐;这里不会再追加一层 [CLS] 或 [SEP]
print(existing_mask)
按任务选择过滤还是保留
拿到掩码后,先明确下游对象。做文本分类时,通常保留完整 input_ids,让模型按自己的模板工作;做 token 分类或把预测对齐回原文时,可以用 special_tokens_mask == 0 排除模板 token,并同步处理 padding。若还要排除 padding,建议组合两个条件,而不是只看一列。
# 只选择既不是特殊 token、又不是 padding 的位置
special = encoded["special_tokens_mask"][0].bool()
valid = encoded["attention_mask"][0].bool()
content_positions = (~special) & valid

# content_positions 与 input_ids 同长度,可安全用于索引或构造标签
content_ids = encoded["input_ids"][0][content_positions]
print(content_ids)
最后检查三件事:掩码和 input_ids 是否等长;句对是否由 tokenizer 生成而不是手工套模板;手动拼接 ID 时是否真的传了 already_has_special_tokens=True。这三个边界处理好,特殊 token 的定位就不会被 padding、子词拆分或模型模板差异带偏。
常见问题
为什么结果里没有 special_tokens_mask?
调用 tokenizer 时显式加入 return_special_tokens_mask=True。它不是默认输出字段,已有代码可用 result.get("special_tokens_mask") 做兼容处理。
special_tokens_mask 能代替 attention_mask 吗?
不能。前者标识特殊 token,后者表示位置是否有效、是否参与注意力;padding 场景下二者可能同时出现,但语义和下游用法不同。
参考资料
Hugging Face Transformers Tokenizer 文档:https://huggingface.co/docs/transformers/en/main_classes/tokenizer
Hugging Face Transformers Tokenization Utilities:https://huggingface.co/docs/transformers/en/internal/tokenization_utils
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
501 收藏
-
403 收藏
-
241 收藏
-
123 收藏
-
215 收藏
-
366 收藏
-
科技周边 · 人工智能 | 6小时前 | 人工智能 · Hugging Face Datasets DatasetDict train_test_split stratify_by_column 机器学习数据集410 收藏
-
268 收藏
-
240 收藏
-
354 收藏
-
158 收藏
-
106 收藏
-
113 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习