
Go types.Struct 怎样把字段类型与原始标签一起导出
来源:17golang原创
时间:2026-11-10 14:31:02 460浏览 收藏
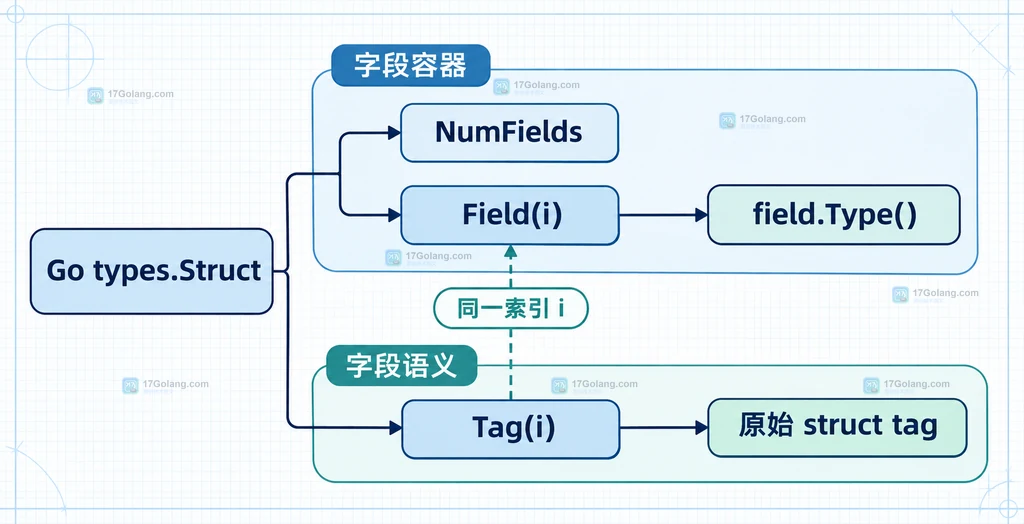
如果手里已经有完成类型检查的 *types.Struct,导出字段信息不需要重新解析 struct tag:用同一个索引 i 调用 Field(i)、Field(i).Type() 和 Tag(i) 即可。前者给字段对象,中者给字段类型,后者返回源码中的原始标签字符串;三者天然保持同一字段的对应关系。
官方文档:https://pkg.go.dev/go/types#Struct
实用做法是先完成类型检查,再从包作用域拿到类型对象,沿着 TypeName → Named → Underlying → Struct 这条路径取字段。导出时不要用字段名重新查找,因为空白字段、重复嵌入路径或字段顺序都应该保留。
先看清 types.Struct 保存的三类信息
types.Struct 本身的字段是按声明顺序排列的。NumFields() 返回字段数量,包含空白字段和嵌入字段;Field(i) 返回第 i 个 *types.Var,再调用 Type() 才能得到它的 types.Type。标签则由同一个索引传给 Tag(i)。
例如源码中的 AccountID string `json:"account_id" db:"account_id"`,导出的标签值是 json:"account_id" db:"account_id" 这一整段原始字符串,而不是已经拆开的 map。需要读取某个键时,可以在导出阶段再交给 reflect.StructTag 解析;如果目标是代码生成或文档展示,保留原文通常更稳妥。
从已检查的包中定位 *types.Struct
不要把 go/types 的类型对象和 go/ast 的语法节点混用。AST 适合保留源码形状,types.Config.Check 之后的包作用域才适合回答“这个字段最终是什么类型”。下面的示例用内存字符串构造一个最小包,并沿着命名类型找到底层结构体。
package main

import (
    "fmt"
    "go/ast"
    "go/importer"
    "go/parser"
    "go/token"
    "go/types"
)

func main() {
    src := `package demo
type User struct {
    ID int ` + "`json:\"id\"`" + `
    Name string
    _ byte
    Profile
}
type Profile struct { Email string ` + "`json:\"email\"`" + ` }
`

    fset := token.NewFileSet()
    file, err := parser.ParseFile(fset, "sample.go", src, parser.ParseComments)
    if err != nil {
        panic(err)
    }

    // 类型检查负责把 User 解析成可查询的命名类型。
    conf := types.Config{Importer: importer.Default()}
    pkg, err := conf.Check("demo", fset, []*ast.File{file}, nil)
    if err != nil {
        panic(err)
    }

    obj := pkg.Scope().Lookup("User")
    typeName, ok := obj.(*types.TypeName)
    if !ok {
        panic("User 不是类型名")
    }
    named, ok := typeName.Type().(*types.Named)
    if !ok {
        panic("User 不是命名类型")
    }
    st, ok := named.Underlying().(*types.Struct)
    if !ok {
        panic("User 的底层类型不是 struct")
    }

    // 同一索引同时取字段、字段类型和原始标签,避免错位。
    for i := 0; i
这里的 TypeName 是包作用域中名为 User 的对象,Named 代表命名类型,Underlying() 才把查询带到底层 Struct。如果分析的是别名、匿名结构体或类型参数,定位路径会不同,不能强行断言成 *types.Named。
按字段索引导出类型和标签
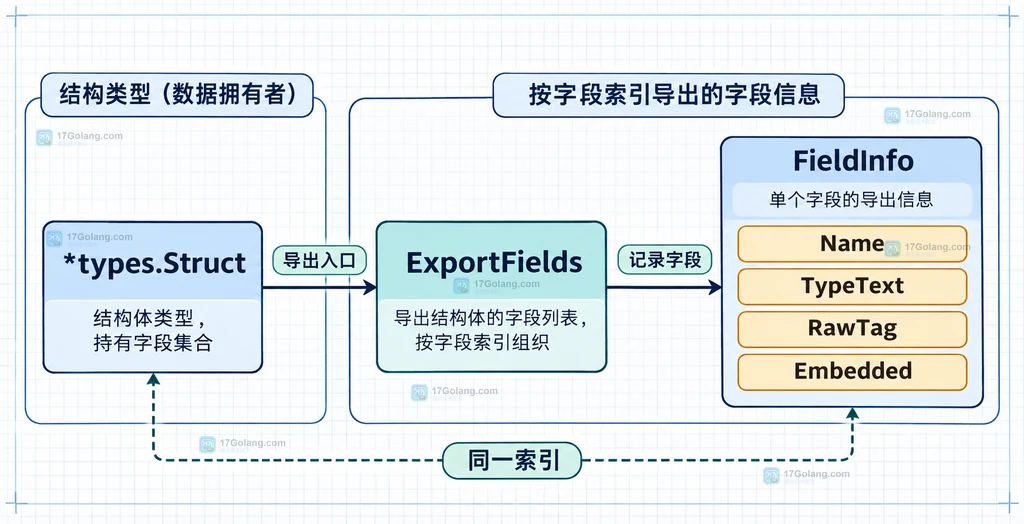
定位到结构体后,导出逻辑可以保持很小:字段名来自 field.Name(),类型文本来自 field.Type().String(),原始标签来自 st.Tag(i)。没有标签时返回空字符串;空白字段的名字也是 _,不要因为它不能被普通代码引用就直接丢弃。
type FieldInfo struct {
    Name     string
    TypeText string
    RawTag   string
    Embedded bool
}

func ExportFields(st *types.Struct) []FieldInfo {
    result := make([]FieldInfo, 0, st.NumFields())
    for i := 0; i
如果需要兼容没有 Fields() 的旧 Go 版本,优先使用第一种 NumFields()+Field(i) 写法。Fields() 是顺序迭代器,但它只给出字段对象,不会额外给标签,所以仍然要维护索引。
几个容易错位的边界
空标签不等于没有字段。Tag(i) 返回空字符串只说明该索引没有保存标签,字段仍应出现在结果中。嵌入字段不要按普通嵌套结构展开。先保存 Embedded() 和字段类型,让调用者决定是否继续展开,避免把提升字段误写成当前结构体的直接声明。
如果要手工重建一个 types.Struct,字段和标签也按索引对应:
fields := []*types.Var{
    types.NewField(token.NoPos, nil, "ID", types.Typ[types.Int], false),
}
tags := []string{`json:"id"`}
// tags[i] 对应 fields[i];没有任何标签时 tags 可以为 nil。
st := types.NewStruct(fields, tags)
官方约定是 tags 可以短到覆盖最大标签索引;因此不要为了“补齐长度”随意添加与字段错位的字符串。导出再重建时,最安全的做法是保持字段切片顺序不变,并在每个位置写回原始标签。
导出前的最小确认
| 要确认的内容 | 对应 API | 注意点 |
|---|---|---|
| 字段总数 | NumFields() | 包含空白字段和嵌入字段 |
| 字段名称与类型 | Field(i)、field.Type() | 类型文本不等于源码中的完整格式化片段 |
| 原始标签 | Tag(i) | 按相同索引读取,空字符串表示没有标签 |
| 嵌入关系 | field.Embedded() | 是否展开应交给上层策略 |
归纳一下:types.Struct 的字段导出核心不是反射,而是稳定的索引映射。先通过类型检查得到正确的结构体,再用同一个 i 读取 Field(i)、Type() 和 Tag(i),就能同时保留类型信息与原始标签。
相关问题
为什么不用 reflect.Type?反射适合运行时值或已编译类型;源码分析工具通常需要先经过 go/types,这样能结合包作用域和类型检查结果。
Tag(i) 会返回解析后的 json 名称吗?不会,它返回原始标签字符串。需要单独读取某个键时,再使用 reflect.StructTag 做键级解析。
可以只用字段名找标签吗?不建议。按索引遍历能保留声明顺序,也不会在空白字段、嵌入字段或同名路径场景中丢失结构信息。
-
377 收藏
-
125 收藏
-
201 收藏
-
183 收藏
-
440 收藏
-
Golang · Go教程 | 23分钟前 | 返回值 · Go教程 · 类型系统 · Go 多返回值 go/types types.Tuple types.NewTuple types.NewVar271 收藏
-
Golang · Go教程 | 24分钟前 | 返回值 · 源码分析 · Go教程 · Go 多返回值 go/types token.FileSet types.Tuple types.Var 声明位置137 收藏
-
240 收藏
-
192 收藏
-
451 收藏
-
253 收藏
-
101 收藏
-
417 收藏
-
318 收藏
-
445 收藏
-
418 收藏
-
204 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习