
我第一次用 go/types 做包初始化分析时,最容易产生的误会就是:既然 Go 包初始化最后一定会执行 init 函数,为什么 types.Info.InitOrder 里找不到它?
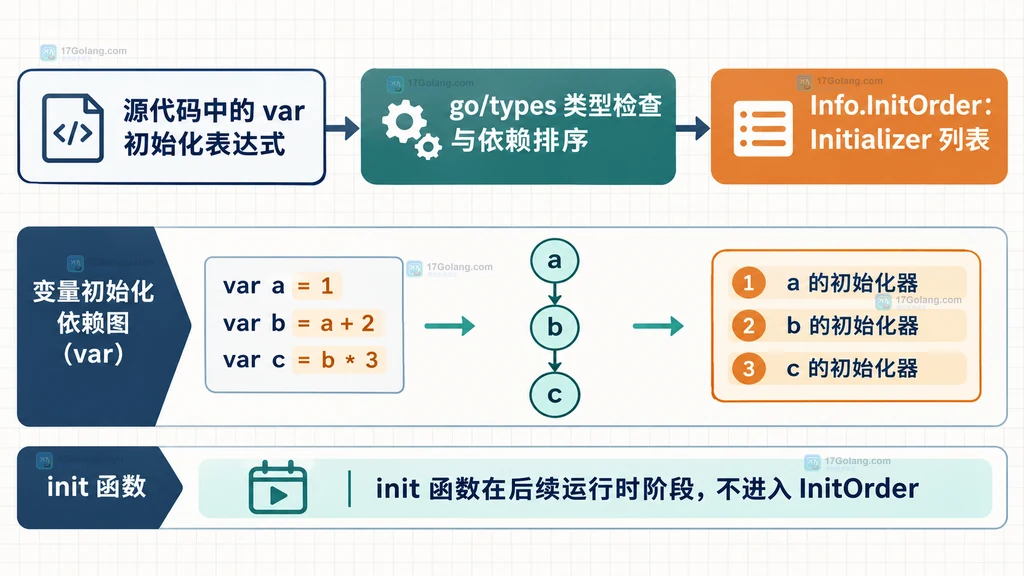
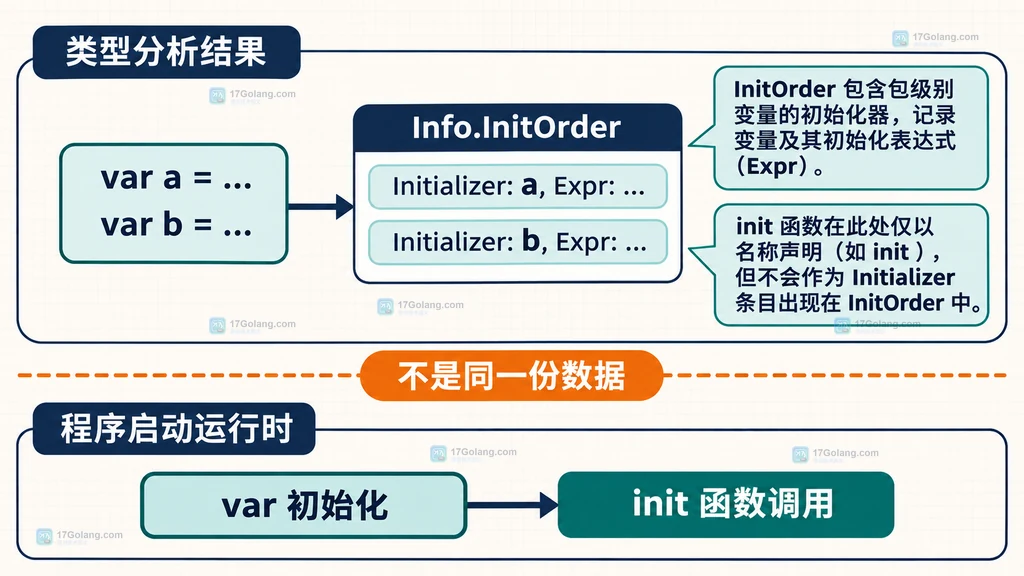
答案是两条链被放进了不同层次:InitOrder 是类型检查阶段产出的“包级变量初始化表达式顺序”,而 init 函数调用属于程序启动时的运行时行为。它们有关联,但不是同一种记录。
官方地址:https://pkg.go.dev/go/types
如果目标是分析变量依赖,用Info.InitOrder;如果还要知道init函数本身,就需要结合 AST 声明信息,或者使用运行时追踪。不要期待一个Initializer条目代表一次init调用。
InitOrder 记录的是什么
Info.InitOrder 的类型是 []*types.Initializer。每个 Initializer 主要包含两部分:左侧被初始化的一个或多个包级变量,以及右侧的初始化表达式。例如 var b = a + 1 会形成一个描述变量 b 和表达式 a + 1 的条目。
这个列表不是简单的文件扫描结果。官方定义是:存在初始化依赖的变量按拓扑顺序排列,没有依赖关系的变量保持源代码顺序;没有初始化表达式的变量不进入列表。因此它回答的是“变量表达式以什么顺序分析和执行”,不是“包里有哪些可调用的初始化函数”。
为什么 init 函数不会变成 Initializer
Go 规范把包初始化描述成两个连续阶段:先给包级变量赋初值,再按源代码顺序调用包中的 init 函数。go/types 的 Initializer 只对应第一阶段中的变量初始化表达式,第二阶段的函数调用不是变量声明,也没有一个能直接放进 Initializer.Lhs 的变量对象。
另外,规范明确规定包块中的 init 标识符只能用来声明 init 函数,本身不会成为普通声明对象,也不能从程序其他位置引用。类型检查器因此不会像记录普通变量那样,把它放入 Defs 或 InitOrder,这正是“看不到 init”最常见的根因。
怎样读取真正的 InitOrder
使用时要在 types.Config.Check 中传入 Info。文档说明,只有传入的非空信息容器才会被填充;因此想拿到初始化顺序,关键不是打开 Types 或 Defs,而是直接读取检查完成后的 info.InitOrder。
package main

import (
    "fmt"
    "go/ast"
    "go/parser"
    "go/token"
    "go/types"
)

func main() {
    const src = `package demo

var base = 10
var total = base + 2

func init() {}
`

    // FileSet 负责维护 AST 位置,后续可以把表达式位置映射回源码。
    fset := token.NewFileSet()
    file, err := parser.ParseFile(fset, "demo.go", src, 0)
    if err != nil {
        panic(err)
    }

    info := &types.Info{}
    conf := types.Config{}
    // Check 只负责类型检查和填充分析结果,不会执行 init 函数。
    _, err = conf.Check("demo", fset, []*ast.File{file}, info)
    if err != nil {
        fmt.Println("type check error:", err)
    }

    for _, item := range info.InitOrder {
        // Initializer.String 展示变量与右侧初始化表达式的关系。
        fmt.Println(item.String())
    }
}
这个示例的重点是输出会围绕 base 和 total 这样的变量初始化条目展开,而不会凭空多出一个表示 func init() 的条目。Check 做的是静态检查,调用它不会启动被分析的包。
列表为空时先区分三种情况
我在工具里遇到空列表时,后来固定按下面三层排查,而不是马上认定解析失败:
| 现象 | 更可能的含义 | 处理方式 |
|---|---|---|
只有 var x int | 变量没有初始化表达式 | 它按定义不会出现在 InitOrder |
有 var x = ... 但结果空 | 没有真正完成类型检查,或 Info 没有被 Check 填充 | 确认传入同一个 Info,并检查返回错误 |
| 结果存在但不完整 | 包存在类型错误,检查器返回了不完整的结果 | 把错误和不完整状态一起传递给调用方 |
官方文档特别提醒:如果包有类型错误,收集到的信息可能不完整。因此静态分析工具可以展示已有条目,但不要把它包装成“完整的运行顺序”。
想看到 init 函数,应该补哪一层
如果需求是列出包中声明了多少个 init 函数,可以遍历 AST 的 FuncDecl,按名称判断 Decl.Name.Name == "init"。这只能回答“源码中声明了什么”,不能证明函数已经被执行。
for _, decl := range file.Decls {
    fn, ok := decl.(*ast.FuncDecl)
    if !ok || fn.Name.Name != "init" {
        continue
    }
    // AST 只能确认源码声明位置,不能替代运行时调用记录。
    pos := fset.Position(fn.Pos())
    fmt.Println("init declaration:", pos.Filename, pos.Line)
}
如果要回答“启动时实际调用了哪个 init”,就已经超出 go/types 静态结果的边界,需要运行程序并设计日志、测试钩子或专门的运行时观测方案。两种数据可以在报告层合并,但应明确标注来源。
我现在会怎样设计这类分析报告
对我来说,最稳妥的数据模型是把一份报告拆成两张表:第一张是“静态初始化表达式表”,来源是 Info.InitOrder,记录变量、表达式、位置和依赖;第二张是“源码声明表”,来源是 AST,记录 init 函数的位置和文件。若项目还需要实际启动行为,再另加运行时事件表。
这样做的好处是读者能看出每条结论的来源:看到 base -> total 是静态依赖排序,看到 init declaration 是源码声明,看到“已执行”则必须来自运行时数据。三者混在一张列表里,短期看起来方便,长期很容易误导排障。
常见追问
没有 init 函数的包,InitOrder 还能有内容吗?
可以。只要存在带初始化表达式的包级变量,InitOrder 就可能有条目;它与是否声明 init 函数是两个独立条件。
init 函数能通过 Info.ObjectOf 找到吗?
不要按普通函数对象来设计这个假设。init 标识符有特殊语言规则,实际工具应从 AST 识别声明,再按需要连接运行时信息。
InitOrder 的顺序就是跨包的完整启动顺序吗?
不是。它描述当前被检查包的包级变量初始化顺序;完整程序还要先按导入依赖初始化各个包,并且每个包之后还有自己的 init 函数阶段。
小结
Info.InitOrder 没有 init 函数调用,不是漏采集,而是数据模型刻意分层:它保存变量初始化表达式及其依赖顺序,init 函数属于之后的运行时阶段。理解这个边界后,静态检查用 Info.InitOrder,源码声明用 AST,实际执行用运行时观测,工具的结果就不会把“能推导的顺序”和“真的发生过的调用”混为一谈。




