
Go 里用 compress/zlib.NewReaderDict 解压预置字典数据时,如果返回 zlib.ErrDictionary,优先检查“解压端拿到的字典字节是否和压缩端完全相同”,不要先把问题归咎于压缩流损坏。zlib 流会在头部声明自己是否依赖预置字典,并携带一个由字典内容计算出的 DICTID;Go 会用这个标识判断传入的字典是否匹配。
官方地址:https://pkg.go.dev/compress/zlib#NewReaderDict
本文只讨论预置字典、FDICT、DICTID、ErrDictionary 和读取器复用。最短排查路径是:先确认压缩流确实要求字典,再确认字典来源、字节顺序和版本,最后检查是否在 Reset 时传入了另一份字典。
先看 zlib 流有没有要求预置字典
NewReaderDict 是带字典参数的读取器构造函数。官方文档给出的关键语义有两条:如果压缩数据没有引用预置字典,传入的字典会被忽略;如果压缩数据引用了另一份字典,则返回 zlib.ErrDictionary。因此“传入了字典”不等于“这条流一定需要这份字典”。
从格式角度看,zlib 头部的 FDICT 标志表示后面存在字典标识,DICTID 用来标识压缩端使用的预置字典。消费端不应该只比较字典长度,也不应该把字典名称当成匹配证据;真正相关的是参与校验的字节内容。
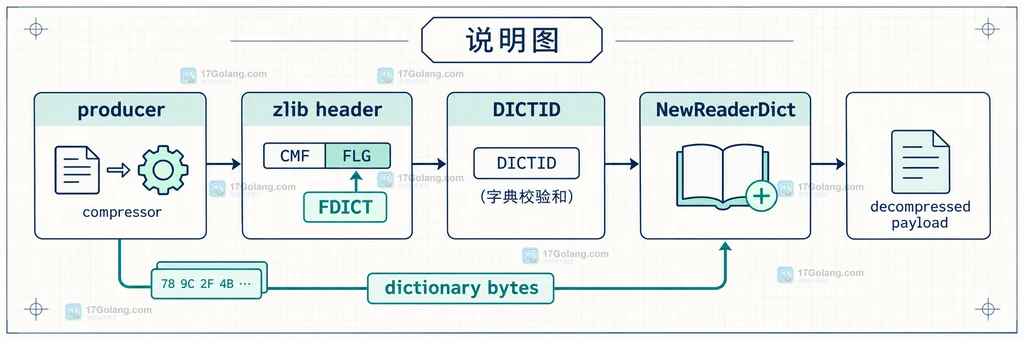
这也解释了一个常见误判:普通 zlib.NewWriter 产生的流不需要预置字典,用 NewReaderDict 读取时通常不会因为“多传了一个字典”而报错。只有流头声明依赖字典,并且传入字典的校验结果不匹配时,才会走字典错误路径。
压缩端和解压端必须共享同一份字典
压缩端一般通过 NewWriterLevelDict 选择字典,解压端再通过 NewReaderDict 提供它。最容易出问题的不是 API 调用形式,而是两端的字典来源不一致:一端从配置文件读取了新版本,另一端仍使用旧内置常量;或者两端都叫“v1”,但文件中混入了不同编码、换行符或字节排序。
package main

import (
    "bytes"
    "compress/zlib"
    "fmt"
    "io"
)

func main() {
    // 生产端和消费端必须使用完全相同的字节序列。
    dict := []byte("user_id=;event_name=;created_at=;")
    payload := []byte("user_id=42;event_name=login;created_at=2026-11-11")

    var compressed bytes.Buffer
    writer, err := zlib.NewWriterLevelDict(&compressed, zlib.DefaultCompression, dict)
    if err != nil {
        panic(err)
    }
    if _, err = writer.Write(payload); err != nil {
        panic(err)
    }
    // Close 会写出尚未刷新的压缩尾部,否则流可能不完整。
    if err = writer.Close(); err != nil {
        panic(err)
    }

    reader, err := zlib.NewReaderDict(bytes.NewReader(compressed.Bytes()), dict)
    if err != nil {
        panic(err)
    }
    defer reader.Close()

    decoded, err := io.ReadAll(reader)
    if err != nil {
        panic(err)
    }
    fmt.Println(string(decoded))
}
示例中的 dict 只是解释 API 配对关系。工程代码中应把它当成协议依赖管理,而不是普通的临时优化参数:字典内容要有明确来源、版本和发布策略,压缩端与解压端要能追踪同一版本。
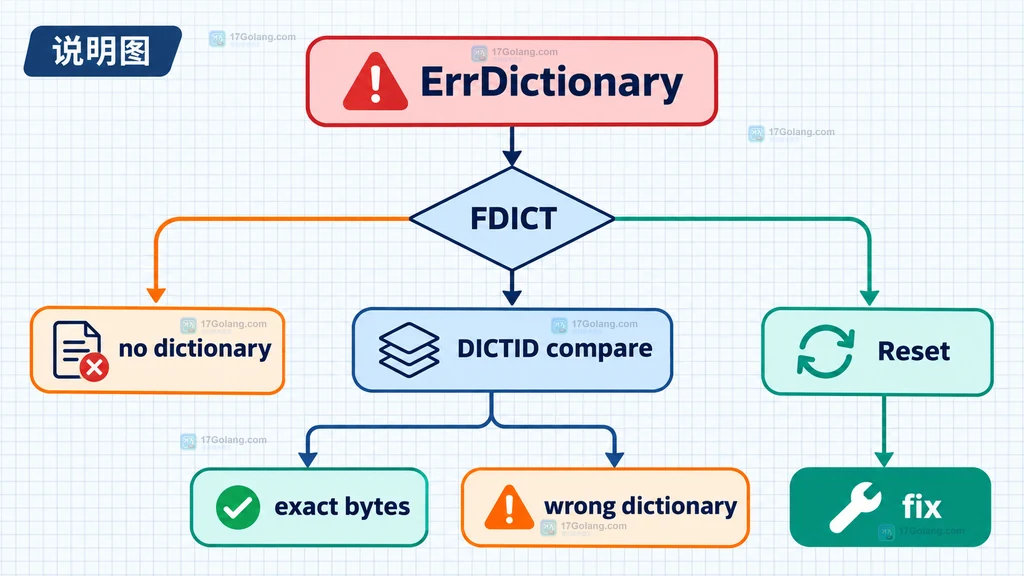
用 ErrDictionary 区分“没字典”和“错字典”
排障时要把构造读取器这一步的错误单独记录。NewReaderDict 可能返回头部错误,也可能返回字典错误;如果把所有错误都包装成“解压失败”,后面就无法判断应当补发字典,还是重新获取压缩数据。
package main

import (
    "bytes"
    "compress/zlib"
    "errors"
    "fmt"
)

func openZlib(data, dict []byte) error {
    // 构造阶段先分出字典错误,避免把配置问题误报为数据损坏。
    reader, err := zlib.NewReaderDict(bytes.NewReader(data), dict)
    if err != nil {
        if errors.Is(err, zlib.ErrDictionary) {
            return fmt.Errorf("预置字典不匹配:请检查字典版本和原始字节: %w", err)
        }
        return fmt.Errorf("zlib 头部无法解析: %w", err)
    }
    // 读取器用完必须关闭;底层 bytes.Reader 不需要额外关闭。
    defer reader.Close()
    return nil
}
errors.Is 比直接比较错误字符串稳定。日志中至少保留数据来源、字典版本、字典长度和摘要;不要把完整字典内容写进日志,因为预置字典有时包含业务词表。
按四个线索定位 DICTID 不匹配
确认错误类型后,按下面的顺序排查,通常比反复重试解压更快。
- 确认数据是否来自使用字典的生产端。如果上游可能在普通 zlib 和字典 zlib 两种模式间切换,先记录协议模式或读取流头的结果,不要假定所有数据都需要字典。
- 核对字典的原始字节。检查 UTF-8 与其他编码、换行符、末尾换行、BOM、压缩包解包顺序以及是否经过字符串规范化。长度相同也不代表内容相同。
- 核对版本发布顺序。生产端升级词表后,消费端如果先升级或后升级,都可能出现短暂不兼容。让数据携带字典版本,或者在服务配置中固定可回溯的字典集合。
- 检查读取器是否被复用。返回的读取器实现
zlib.Resetter;复用时需要把新的底层输入和正确的字典一起传给Reset,不能沿用上一次任务的隐式状态。
一个实用的诊断记录可以是“流模式=FDICT、dict_version=2026-11、dict_len=32、dict_digest=…、reader_mode=NewReaderDict”。摘要只用于比对和定位,不能代替真正的字典字节。
复用 Resetter 时不要忘记传字典
如果服务批量读取许多 zlib 数据,可以复用读取器,但每次切换输入都要显式提供对应字典。尤其是同一个进程同时支持多个字典版本时,复用对象会让“上一次成功”掩盖“本次参数错误”。
// reader 是之前由 zlib.NewReaderDict 创建的可复用读取器。
resetter, ok := reader.(zlib.Resetter)
if !ok {
    return fmt.Errorf("当前读取器不支持 Reset")
}

// 切换数据时同时切换字典;不能只替换底层输入。
if err := resetter.Reset(nextSource, nextDict); err != nil {
    if errors.Is(err, zlib.ErrDictionary) {
        return fmt.Errorf("复用读取器时字典不匹配: %w", err)
    }
    return fmt.Errorf("复用读取器初始化失败: %w", err)
}
另外,压缩端使用 NewWriterLevelDict 时,官方文档要求在 Writer 关闭前不要修改字典内容。如果字典来自可复用缓冲区,不能在写入完成前把它交给下一次任务覆盖,否则同一个压缩流的结果会变得难以解释。
什么时候不该使用 NewReaderDict
如果上下游无法稳定协商字典版本,或者数据会被多个不受控的实现消费,预置字典带来的压缩收益可能不值得它增加的部署耦合。此时可以让生产端使用普通 zlib.NewWriter,消费端使用 zlib.NewReader,把兼容性优先级放在压缩率之前。
不要用“捕获 ErrDictionary 后依次尝试很多未知字典”的方式替代协议设计。它会增加延迟和资源消耗,也让错误边界变得模糊。更好的方案是让流元数据携带字典版本,再从受控字典仓库取出精确版本;取不到时明确返回可重试或不可重试的业务错误。
小结
| 现象 | 优先判断 | 处理方向 |
|---|---|---|
| 传入字典但没有 ErrDictionary | 流可能没有声明预置字典 | NewReaderDict 会忽略多余字典,按普通读取流程继续 |
| NewReaderDict 返回 ErrDictionary | DICTID 与传入字典不匹配 | 核对字典原始字节、版本和来源 |
| Reset 后偶发字典错误 | 复用时传入了错误字典或旧任务参数 | 每次 Reset 显式绑定输入和对应字典 |
| 读取过程中返回 ErrChecksum | 字典匹配后仍需检查压缩流完整性 | 区分输入截断、传输损坏与协议问题 |
一句话记忆:ErrDictionary 主要回答的是“这条 zlib 流要求的字典和你提供的字典不是同一份”,定位时应回到压缩端、DICTID、字典原始字节和版本传递链路。
相关问题
- 为什么给普通 zlib 数据传入字典不会报错?因为没有 FDICT 时,
NewReaderDict会忽略该字典。 - 字典长度一样为什么仍然不匹配?DICTID 依赖字典内容,长度相同不能证明字节相同。
- 字典错误一定说明压缩数据损坏吗?不一定,优先检查消费端字典版本和原始字节。
- 能否通过 Reset 更换字典?可以,但必须把对应的新输入和新字典一起传给实现了
zlib.Resetter的读取器。




