
Go 里遇到 net.IP.To4() 返回 nil,先别急着认定输入是坏地址。它的真正语义是:只有 IPv4(包括 IPv4-mapped IPv6)能被转换成 4 字节表示,纯 IPv6 和长度不合法的字节序列都会返回 nil。我排查这类问题时,会先把“输入是不是合法 IP”和“它是不是 IPv4”拆成两步,这比直接看 len(ip) 稳定得多。
官方地址:https://pkg.go.dev/net#IP.To4
本文只讨论 net.IP.To4 的返回边界、net.ParseIP 的表示差异,以及它在地址族匹配和 IPNet.Contains 中的使用。最短判断式是:ip4 := ip.To4(); ip4 != nil 表示“这个值可按 IPv4 处理”,而不是“底层切片原本一定只有 4 个字节”。
To4 的返回边界先记住这一条
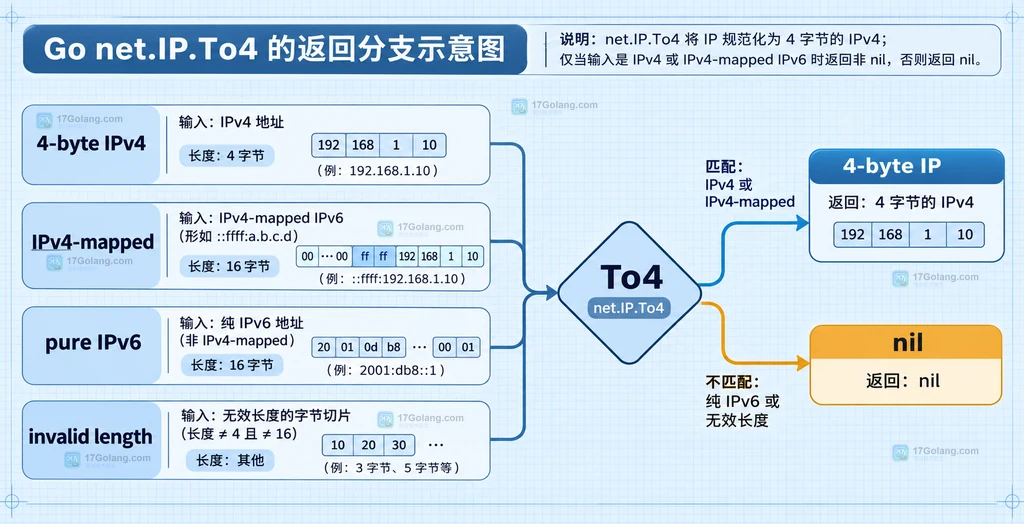
官方文档把 To4 定义为“把 IPv4 地址转换成 4 字节表示”。实现上,长度为 4 的 net.IP 会直接返回;长度为 16 且前 10 个字节为零、接着两个字节为 0xff 的 IPv4-mapped IPv6,会返回最后 4 个字节;其它情况返回 nil。
所以,nil 只说明“不能按 IPv4 转成四字节”,并没有单独告诉你是纯 IPv6 还是输入长度错误。需要区分这两个情况时,要把解析阶段和地址族判断阶段分开。
用三组输入看清为什么会返回 nil
下面的示例故意使用三类常见值:直接构造的 4 字节 IPv4、net.ParseIP 得到的 IPv4-mapped IPv6,以及纯 IPv6。最后再放一个长度错误的切片,用来说明 To4 不负责验证任意字节序列。
package main

import (
    "fmt"
    "net"
)

func show(label string, ip net.IP) {
    // To4 非 nil 就代表当前值可以按 IPv4 的四字节表示使用。
    ip4 := ip.To4()
    if ip4 == nil {
        fmt.Printf("%-18s original=%v  To4=nil\n", label, ip)
        return
    }
    fmt.Printf("%-18s original=%v  To4=%v  len=%d\n", label, ip, ip4, len(ip4))
}

func main() {
    // 4 字节原生 IPv4,To4 原样返回这 4 个字节。
    show("native IPv4", net.IPv4(192, 0, 2, 10).To4())

    // ParseIP 的 IPv4 结果通常以 16 字节 mapped 形式保存,但仍可转成 IPv4。
    show("parsed IPv4", net.ParseIP("192.0.2.10"))

    // 纯 IPv6 不是 IPv4,To4 会返回 nil。
    show("pure IPv6", net.ParseIP("2001:db8::10"))

    // 任意 5 字节切片不是合法的 IPv4 或 IPv6 表示。
    show("invalid bytes", net.IP{192, 0, 2, 10, 1})
}
这里最容易忽略的是第二组。net.ParseIP("192.0.2.10") 返回的值在内部可以是 16 字节的 IPv4-mapped 形式,因此把 len(ip) == 4 当成 IPv4 判断会漏掉它。使用 To4 正好把这两种表示归一到同一个 4 字节结果。
不要只用 len(ip) 判断地址族
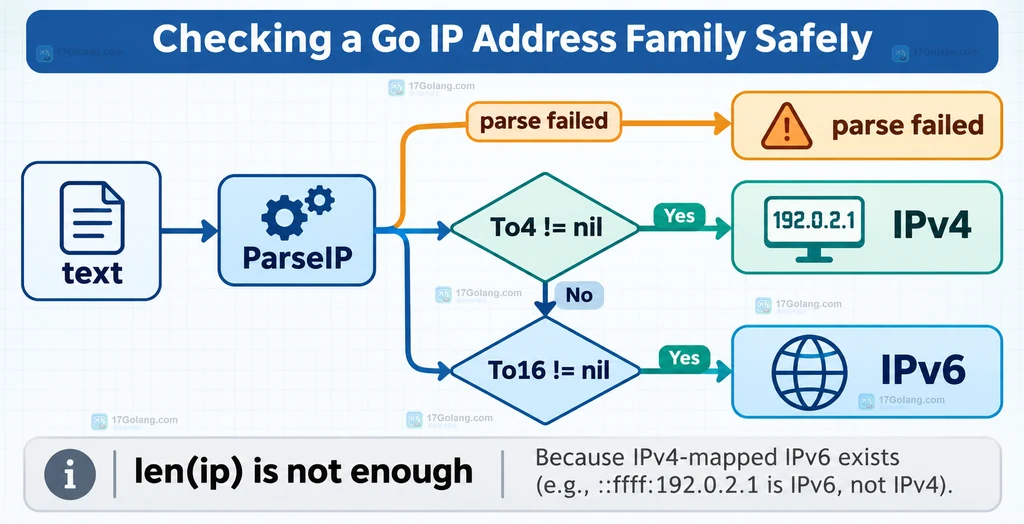
如果输入来自文本,推荐先调用 net.ParseIP 判断是否解析成功,再调用 To4 判断是否属于 IPv4。这样可以把“文本不是 IP”“文本是纯 IPv6”“文本是 IPv4”三个结果明确分开。
package main

import (
    "errors"
    "fmt"
    "net"
)

var errInvalidIP = errors.New("invalid IP text")

func classify(text string) (string, error) {
    // ParseIP 负责判断文本是否是合法的 IP,不负责选择 IPv4 或 IPv6。
    ip := net.ParseIP(text)
    if ip == nil {
        return "invalid", fmt.Errorf("%w: %q", errInvalidIP, text)
    }

    // To4 统一处理 4 字节 IPv4 和 IPv4-mapped IPv6。
    if ip4 := ip.To4(); ip4 != nil {
        return fmt.Sprintf("IPv4 (%s)", ip4), nil
    }

    // 能通过 ParseIP 但 To4 为 nil,此处就是可识别的纯 IPv6。
    if ip16 := ip.To16(); ip16 != nil {
        return fmt.Sprintf("IPv6 (%s)", ip16), nil
    }
    return "invalid representation", nil
}
To16 在这里是第二层确认:只要已经通过 ParseIP,To4 为 nil 时通常就可以按纯 IPv6 处理。若函数接收的不是文本而是外部字节切片,则仍然应先定义输入协议,不能仅凭 To4 的 nil 结果推断所有错误原因。
在地址匹配中先归一,再比较
工程里常见的需求不是打印地址,而是判断两个地址是否同属 IPv4、或者把一个地址交给 IPv4 网段判断。比较前先取 To4 可以避免 4 字节 IPv4 与 mapped 形式被当成不同长度的数据。
package main

import (
    "fmt"
    "net"
)

func sameFamily(a, b net.IP) bool {
    // 两边都能 To4,说明都按 IPv4 处理;一边能转而另一边不能则不属于同族。
    a4, b4 := a.To4(), b.To4()
    if a4 != nil || b4 != nil {
        return a4 != nil && b4 != nil
    }

    // 都不是 IPv4 时,再确认两边都是有效的 16 字节 IPv6 表示。
    return a.To16() != nil && b.To16() != nil
}

func main() {
    // ParseIP 的 IPv4 和显式 4 字节 IPv4 归一后属于同一地址族。
    a := net.ParseIP("192.0.2.10")
    b := net.IPv4(192, 0, 2, 11)
    fmt.Println(sameFamily(a, b)) // true
}
标准库的 IPNet.Contains 也会先把待判断地址转换成 IPv4 形式,再与网络号和掩码长度匹配。因此遇到“同一个 IPv4 地址在某种写法下匹配、另一种写法下不匹配”的问题,优先检查 IPNet 和输入地址是否落在同一个地址族,而不是先改掩码。
监听地址里 nil 不是“监听失败”的同义词
To4 只回答地址表示问题,不能回答端口是否可用、网卡是否存在或目标是否可达。例如监听配置使用 0.0.0.0 或 :: 时,它们都表达“未指定地址”,但对应的监听族仍由网络参数和具体 API 决定。Go 文档也说明,TCP 监听中如果地址为空或是字面量未指定地址,默认可能监听本机可用地址;如果只需要 IPv4,应显式使用 tcp4。
因此排查顺序可以固定为:先确认文本能否通过 ParseIP,再用 To4 判断地址族,最后检查 net.Listen 使用的是 tcp、tcp4 还是 tcp6。不要把 To4() == nil 直接翻译成“网络不可用”。
常见问题
为什么 ParseIP 得到的 IPv4 长度看起来不是 4? 因为它可以使用 16 字节的 IPv4-mapped 表示。用 To4 获取稳定的 4 字节结果。
纯 IPv6 是否应该用 To4 判断? 可以用它判断“不是 IPv4”,但要确认 IPv6 时继续检查 To16,不要把所有 nil 都归类为解析失败。
To4 会检查任意字节切片是不是合法文本吗? 不会。它只按 net.IP 的字节布局判断,文本校验应交给 net.ParseIP,协议输入还需要自己的长度和来源约束。
判断两个 IP 是否相等时也要手动 To4 吗? 不一定。net.IP.Equal 已经把 IPv4 与对应的 IPv4-mapped IPv6 视为相等;只有需要明确地址族、输出 4 字节值或选择 tcp4/tcp6 时,才直接使用 To4。
一句话总结:To4() != nil 是 Go 中判断“可按 IPv4 使用”的可靠入口;To4() == nil 只代表不能转成 IPv4,真正的解析失败、纯 IPv6 和非法字节输入,应该在更早的输入边界分别识别。




