
提示词缓存怎样拆分稳定前缀和动态输入
来源:17golang原创
时间:2026-11-16 20:37:21 419浏览 收藏
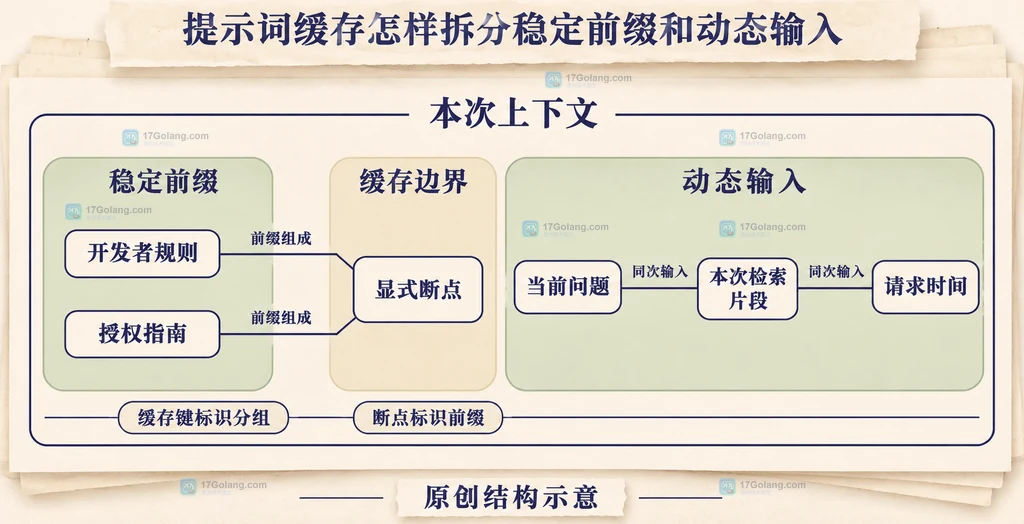
拆分提示词缓存时,把可跨请求复用的规则、示例和授权参考材料放在稳定前缀,把当前问题、检索结果、时间及订单状态放在后面的动态输入。缓存键用来区分相关请求的分组,不能替代内容匹配,也不能把含义相近但实际不同的前缀强行变成命中。
官方缓存文档:https://developers.openai.com/api/docs/guides/prompt-caching
我会先判断“哪一段确实会反复使用”,再决定缓存参数。下面用一个客服指南的假设场景说明设计方法,不声称已有线上收益,也不把它写成新产品发布消息。具体参数以 OpenAI Responses API 为例,不代表所有模型供应商使用相同机制。
先把复用材料和当次事实分开
假设一份指南供多个独立咨询使用。写作口吻、回答结构和同版本的操作说明通常能复用;客户刚刚问的问题、当次检索返回的段落、实时物流状态不能视为同一份共享材料。把请求 ID 或当前时间插在指南开头,会让本来相同的内容失去稳定的起点。
我的拆分方式是先给每段内容标注来源和变化频率:版本化规则属于稳定区,当前事实属于动态区。如果存在只对某个客户有效的特殊条款,应单独判断权限与更新周期,不能因为“很长”就塞进公共前缀。
| 内容 | 建议位置 | 变化时如何处理 |
|---|---|---|
| 回答规则和固定术语 | 稳定前缀 | 按实际版本更新 |
| 同版本授权指南 | 稳定前缀 | 修改正文并更新版本标记 |
| 当前问题和请求时间 | 动态输入 | 每次如实提供 |
| 本次检索片段与业务状态 | 动态输入 | 按本次查询结果更新 |
| 仅个人可见的记录 | 经过鉴权的专属输入 | 遵循权限与数据保留要求 |
“放在后面”不会让一条消息自动获得更高或更低的指令权限。需要开发者级别约束的动态规则,仍应使用合适的 developer 消息;用户问题仍属于 user 消息。稳定性与角色权限是两个维度,不能为了前缀复用改变内容的信任等级。
缓存键标识分组,断点标识前缀
前缀内容一致只是必要设计条件,具体能否复用还取决于所用模型的缓存边界和有效缓存条目。当前官方文档对 GPT-5.6 及以后模型提供显式断点机制;仅把固定开发者消息放前面、后接每次不同的用户消息,不应直接断言第二次就会命中共享的短前缀。
对支持该机制的模型,可以在稳定内容块末尾设置 prompt_cache_breakpoint,并在请求中使用 prompt_cache_options.mode="explicit"。同一位置的断点需要在相关请求中保持一致。这种显式模式把要复用的内容边界说清楚;它不会自动删除后面的动态内容,模型仍会接收并处理它们。
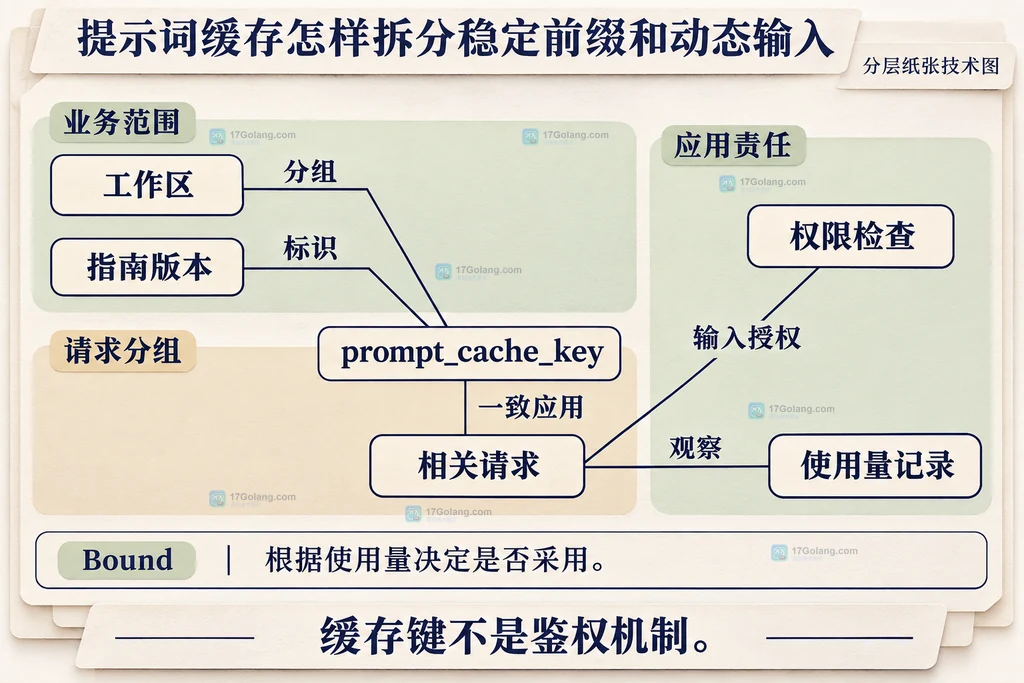
prompt_cache_key 则回答“这些请求按哪个分组管理”。在 GPT-5.6 及以后模型,它可用于分开客户或工作区的缓存核算,不是优化缓存所必需;更早模型中,稳定键还用于帮助相关请求的缓存路由。不能把不同代际的参数作用混成一条无条件规则。
例如 support:workspace-demo:guide-v3 是应用自定义分组标识,表示演示工作区和指南版本,不是产品规定格式。选择这个边界后,同一组请求应一致使用该键;每次都换随机 UUID 会把相关请求拆散。也不要把邮箱、密钥或完整用户问题直接拼进键名。
用独立请求保留同一份稳定内容
下面的原创 Python 示例把已经准备好的 shared-guide-v3.txt 作为共享材料,只改变末尾的问题。它要求 Responses 模型与 SDK 支持显式断点字段;把 OPENAI_MODEL 设为自己账户中有权限且兼容的型号,密钥由 OPENAI_API_KEY 提供。
import os
from pathlib import Path
from openai import OpenAI

# 该文件只含本工作流可共享、已获授权的规则和参考材料。
# 内容应有实际用途;不要为凑缓存长度填充重复句子。
stable = Path("shared-guide-v3.txt").read_text(encoding="utf-8")
if not stable.strip():
    raise ValueError("共享材料不能为空")

def make_request(question):
    return {
        # 选择支持显式断点的 Responses 模型,并使用支持这些字段的 SDK。
        "model": os.environ["OPENAI_MODEL"],
        "prompt_cache_key": "support:workspace-demo:guide-v3",
        "prompt_cache_options": {"mode": "explicit"},
        "input": [
            {
                "role": "developer",
                "content": [{
                    "type": "input_text",
                    "text": stable,
                    "prompt_cache_breakpoint": {"mode": "explicit"},
                }],
            },
            # 当次问题位于稳定块之后;同一个 key 不会把不同问题变成同一输入。
            {"role": "user", "content": question},
        ],
    }

# 这两个请求互相独立,不利用 previous_response_id 串成对话。
# 每次请求会消耗配额;示例没有预设或伪造缓存命中结果。
with OpenAI(timeout=30.0, max_retries=0) as client:
    for question in [
        "请依据共享指南解释尺寸不合适时怎样申请换货。",
        "请依据共享指南解释换货申请需要哪些材料。",
    ]:
        response = client.responses.create(**make_request(question))
        if response.status != "completed":
            raise RuntimeError("响应未完整完成,不把它当作成功结果")
        usage = response.usage
        details = usage.input_tokens_details if usage else None
        print({
            "input_tokens": usage.input_tokens if usage else None,
            "cached_tokens": details.cached_tokens if details else None,
        })
        print(response.output_text)
文件内容可以由你自己的规则、术语解释和业务示例组成。代码不自动生成指南,也不保证很短的文件满足缓存的最小可用前缀要求。最小长度、保留策略和计费方式存在模型差异,不能只按中文字数推算,更不应靠重复无用文字凑长度。
如果参数不被当前 SDK 或模型接受,应按对应模型文档调整接入;不要删掉断点后继续宣称同样的复用边界仍然存在。这个例子展示的是请求组装和使用量读取,没有执行或提供缓存命中截图。
需要检索材料时,把每次筛选后的片段放入动态输入,并保留来源信息。若某个文档版本真正反复复用,可以把它设计为另一个受控共享层,但必须考虑版本与权限。不能为延长共享前缀而把用户没有权限看到的历史材料一起发送。
根据使用量决定是否采用
与“把所有内容拼成一段字符串”的写法相比,分块的直接收益是能说明每段内容为何稳定、何时更新、谁能访问。至于缓存收益,要依据真实请求的使用量与耗时判断。观察 usage.input_tokens_details.cached_tokens,同时记录总输入、输出和模型配置;支持缓存写入计量的型号,还要考虑写入成本。
单次 cached_tokens 为零不能只归因于“缓存坏了”。可以先检查共享内容是否变化、断点是否一致、长度是否满足条件、模型或请求配置是否改变,以及缓存是否还可用。为了得到一个漂亮数字反复发送同一问题,也不能代表真实业务的复用率。
如果每次材料都不同、前缀很短或请求很少,我会先保留清楚的内容结构,不急于延长缓存寿命。若指南长、版本稳定并且重复请求足够多,再比较写入与读取的实际代价。本文不承诺固定节省比例,也不提供未实测的性能数字。
多轮对话中,追加新消息通常比反复重写早期历史更有利于保留公共部分;但摘要、截断和模板变更都有自己的必要性。需要压缩上下文时,应优先保证问题所需信息完整,再接受新的缓存边界。缓存不是模型的长期记忆,也不是旧答案的结果缓存。
同一个缓存键能复用不同版本的指南吗?
同键不替代内容匹配。指南变了就应发送新内容,应用还可以更新分组版本以便观察;不能只改键名而继续把旧规则当作新规则。
把请求时间放进共享前缀有什么影响?
时间随请求变化,会破坏该位置之后的稳定性。确实需要时间时,把它作为当次事实放在共享部分之后,并保持适当消息角色。
缓存键能代替租户鉴权吗?
不能。应用应先决定客户有权读取哪些材料,再构造输入。缓存键可用于分组或核算,但不会自动替你完成业务权限判断。
官方参考:https://developers.openai.com/api/docs/guides/prompt-caching。采用前应按具体模型确认断点、长度和保留参数,避免沿用其他模型的配置。
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
164 收藏
-
416 收藏
-
267 收藏
-
185 收藏
-
328 收藏
-
156 收藏
-
科技周边 · 人工智能 | 27分钟前 | 人工智能 · openai · 多轮对话 Responses API conversation state OpenAI API previous_response_id121 收藏
-
470 收藏
-
417 收藏
-
493 收藏
-
414 收藏
-
122 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习