
视觉模型输入多张图片时怎样控制顺序和细节级别
来源:17golang原创
时间:2026-11-16 20:39:03 386浏览 收藏
多张图片交给视觉模型时,真正容易失控的不是“能不能上传”,而是模型收到的图片角色和细节预算不够明确。比较稳的做法是:先给每张图定义角色,再把角色按固定顺序放入同一个内容数组;对每张图单独设置 detail;最后按模型文档估算尺寸、patch 和输入 token,而不是把所有图片都直接开到最高细节。
官方地址:https://platform.openai.com/docs/guides/images-vision
我在实际拼装多图请求时,会把“总览图”“局部图”“参考图”当成请求协议的一部分。顺序不是模型替你猜的业务语义,调用方应当让数组位置、文本说明和图片角色三者保持一致。下面用一个小型的商品图片对比请求说明这套做法。
先把图片顺序写成语义契约
官方视觉输入文档支持在同一个内容数组里放入多张图片,同时提醒图片会计入输入 token。对工程代码来说,最重要的不是把图片数量塞进去,而是固定每个位置的含义。例如第 1 张永远是整体视图,第 2 张永远是标签局部,第 3 张永远是包装背面。这样提示词中的“第二张图”才有稳定含义。
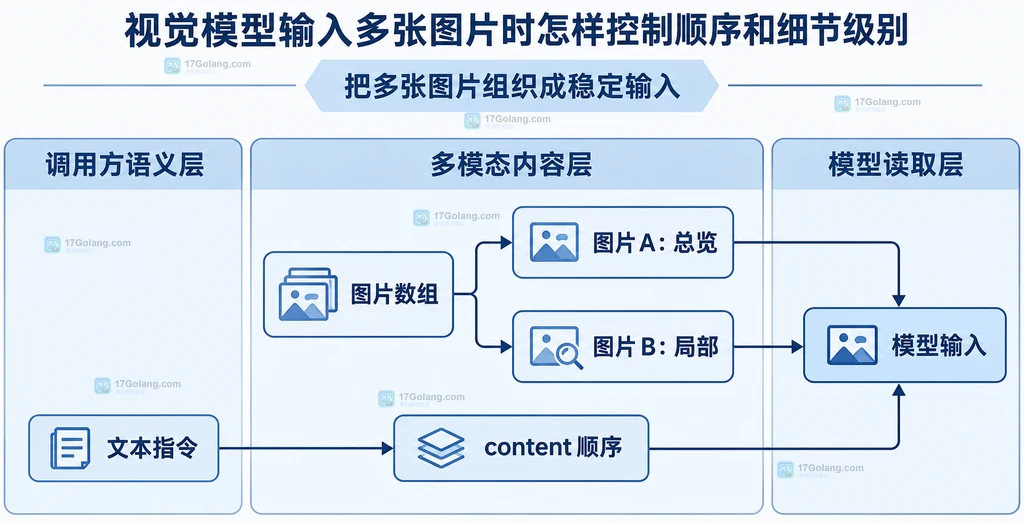
建议在业务对象里保存图片角色,而不是在循环中临时拼字符串。下面的 Python 示例使用 Responses API 风格的 input 数组;示例中的 URL 是占位符,实际项目应替换为自己的可访问图片地址或 Base64 数据 URL。
from openai import OpenAI

client = OpenAI()

image_roles = [
    {
        "role": "整体视图",
        "url": "https://example.com/product-overview.jpg",
        "detail": "low",
    },
    {
        "role": "标签局部",
        "url": "https://example.com/product-label.jpg",
        "detail": "high",
    },
]

content = [
    {
        "type": "input_text",
        # 先声明位置契约,避免模型把两张图的角色混在一起。
        "text": "请比较图片1的整体外观与图片2的标签文字,只根据给出的图片回答。",
    }
]

for index, item in enumerate(image_roles, start=1):
    content.append({
        "type": "input_text",
        # 让日志、提示词和数组位置共享同一个编号。
        "text": f"图片{index}角色:{item['role']}",
    })
    content.append({
        "type": "input_image",
        "image_url": item["url"],
        # detail 属于单张图片参数,不能把局部图的需求套给所有图片。
        "detail": item["detail"],
    })

response = client.responses.create(
    model="gpt-6-astra",
    input=[{"role": "user", "content": content}],
)

print(response.output_text)
这里有一个容易忽略的点:如果你的文本说明和图片交错排列,后续新增一张图时必须同时更新角色说明和数组顺序。更稳妥的方案是先生成一份带 index、role、url 的中间对象,再由一个函数统一序列化,避免业务分支各自追加图片。
什么时候用 low、high 或 original
detail 控制图片预处理。官方文档列出了 low、high、original 和 auto,但具体支持项取决于模型;省略时通常由 auto 采用模型默认的尺寸行为。
可以按任务这样分配:
low:只需判断大致构图、颜色、是否存在某个物体时优先考虑。它不保证在所有模型上都比high少用 token,所以仍要结合目标模型说明。high:需要较清楚的常规视觉理解,但不要求精确原图坐标时使用。original:图像密集、空间敏感或需要 OCR、小目标识别、坐标定位时使用,前提是目标模型支持。auto:不想在业务层绑定模型细节时使用,让模型采用文档定义的默认尺寸行为。
不要因为请求里有一张小标签图,就把总览图也切成 original。细节档位应和图片承担的任务匹配:总览图负责建立上下文,局部图负责读取细节。多个 input_image 可以拥有不同的 detail,这通常比统一拉高更可控。
用尺寸、patch 和输入 token 做预算
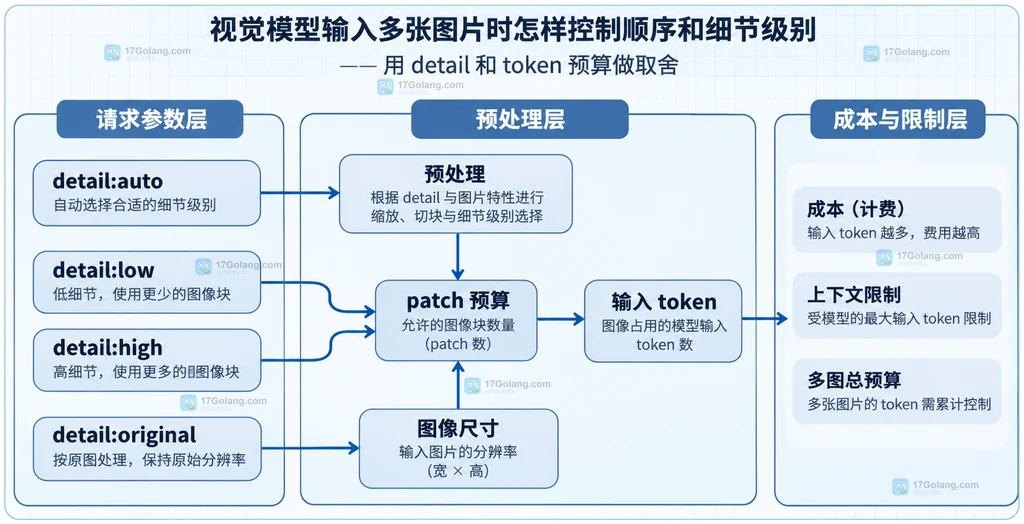
多图请求的预算至少要看三层:每张图片的预处理尺寸、模型对应的 patch 或 tile 规则、以及所有图片和文本共同占用的上下文空间。官方文档明确说明图片会计入输入 token,也会计入 TPM;单张图片的估算不能代替整个请求的限制判断。
对于采用 32×32 patch 的模型,可以把估算理解成下面的关系:
from math import ceil


def estimate_patch_tokens(width, height, multiplier=1.2):
    # patch 覆盖图片边缘时也要向上取整,不能用整数除法截断。
    patches = ceil(width / 32) * ceil(height / 32)
    # multiplier 由目标模型文档给出;这里只做输入图片的粗略预算。
    return ceil(patches * multiplier)


images = [
    {"role": "整体视图", "width": 1024, "height": 768},
    {"role": "标签局部", "width": 1600, "height": 1200},
]

total = 0
for image in images:
    tokens = estimate_patch_tokens(image["width"], image["height"])
    # 逐图记录角色和预算,便于发现是哪一张图拉高了总量。
    print(image["role"], tokens)
    total += tokens

print("estimated_image_tokens:", total)
这段代码只表达 patch 计算关系,不代替目标模型的实际规则。官方文档要求先按选定 detail 的像素上限处理,再计算 patch;如果模型有 patch budget,还要按预算比例缩小后重新计算。因此工程上应把模型、detail、原始宽高和估算结果一起记下来,而不要把一个固定数字写死成所有模型通用的 token 单价。
把多图请求封装成可重复的小项目
如果同一类图片请求会反复出现,可以把“角色定义—参数选择—数组序列化”收成一个构造器。这样图片顺序由数据决定,detail 也能按角色集中管理。
def build_vision_input(question, images):
    # 先把问题放在数组开头,明确后续图片都服务于同一个任务。
    content = [{"type": "input_text", "text": question}]
    for position, image in enumerate(images, start=1):
        content.append({
            "type": "input_text",
            # 位置标签让模型知道图片角色,也方便排查顺序错位。
            "text": f"图片{position}:{image['role']}",
        })
        content.append({
            "type": "input_image",
            "image_url": image["url"],
            # 没有显式 detail 时才让服务使用模型默认值。
            "detail": image.get("detail", "auto"),
        })
    return [{"role": "user", "content": content}]


request_input = build_vision_input(
    "只比较图片1与图片2的外观差异,不要猜测图片外的信息。",
    [
        {"role": "正面总览", "url": "https://example.com/front.jpg", "detail": "low"},
        {"role": "接口局部", "url": "https://example.com/port.jpg", "detail": "high"},
    ],
)

# 调用前仍要由配置层选择模型,避免把模型名散落在业务代码里。
response = client.responses.create(model="gpt-6-astra", input=request_input)
print(response.output_text)
在生产代码里还应保留请求的角色表和估算信息。这样当回答出现“把图片1和图片2说反了”时,可以先查序列化后的数组,而不是直接怀疑模型。
五个边界值得在接入前处理
- 模型不支持某个 detail。不要把
original当成通用参数;按目标模型支持列表降级到high或auto。 - 图片很大但任务很粗。先缩小总览图,保留局部图的关键区域,通常比所有图片都使用最高细节更省预算。
- 总 payload 超限。官方文档给出了请求总大小和图片数量上限,但模型自身、上下文和速率限制仍可能更严格;超限时拆分请求并在应用层合并结果。
- 图片顺序来自无序数据结构。不要直接遍历无序集合生成 content;先按固定优先级排序,并把最终位置记录进日志。
- 把估算当成账单。patch 或 tile 规则是预算工具,实际可用上下文和服务计量仍以目标模型的当前文档与响应为准。
最后用一张表确认设计
| 设计问题 | 推荐做法 | 避免什么 |
|---|---|---|
| 图片如何排序 | 用角色表固定位置,并在文本中标注图片编号 | 在多个分支里随手 append |
| 细节如何选择 | 总览偏低、局部按任务提高,坐标/OCR 任务再考虑 original | 所有图片统一最高档 |
| 预算如何估算 | 按模型、detail、尺寸和 patch/tile 规则逐图估算 | 把一个固定 token 数套给所有模型 |
| 异常如何排查 | 记录角色、顺序、detail、尺寸和估算结果 | 只记录最终问题文本 |
如果只记住一件事:多图输入先解决“每张图是谁”,再解决“每张图看多细”。顺序是业务语义,detail 是资源取舍,patch/token 是预算边界;把三者放进同一个可记录、可重放的构造函数里,调试和扩展都会轻很多。
相关问题
多张图片一定要放在同一个请求里吗?
不一定。如果图片总量或上下文压力过高,可以先分组分析,再把结构化摘要交给第二次请求。代价是跨请求的细节可能丢失,所以要明确哪些信息必须保留。
low 一定比 high 少 token 吗?
不应一概而论。官方文档特别提醒,具体 token 使用依赖模型和预处理规则;应结合目标模型的 sizing table 或成本计算器判断。
为什么不直接把图片都缩到同一个尺寸?
统一尺寸会让总览图和局部图承担相同的预处理成本,但两者的信息价值不同。更合理的是按角色保留关键区域,再根据任务选择 detail。
-
284 收藏
-
387 收藏
-
328 收藏
-
426 收藏
-
147 收藏
-
164 收藏
-
416 收藏
-
267 收藏
-
185 收藏
-
328 收藏
-
156 收藏
-
科技周边 · 人工智能 | 27分钟前 | 人工智能 · openai · 多轮对话 Responses API conversation state OpenAI API previous_response_id121 收藏
-
470 收藏
-
417 收藏
-
493 收藏
-
414 收藏
-
122 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习