
PyTorch torch.func.vmap 怎样把单样本函数批量化
来源:17golang原创
时间:2026-11-18 00:00:31 230浏览 收藏
把“只处理一个样本”的 PyTorch 函数改成批量调用,核心不是在函数外层机械套一层 for,而是用 torch.func.vmap 把样本维度交给函数变换处理。先写好单样本函数,再用 vmap 返回一个接收批量张量的新函数;输入的映射维度由 in_dims 指定,结果的批量维度由 out_dims 指定。
官方地址:https://pytorch.org/
下面以“单个向量点积”作为最小例子,逐步处理多输入、非批量参数、输出维度、显存压力和随机函数限制。文中的图是静态说明图,不是本机运行截图或性能测试结果。
先把单样本函数的形状写清楚
假设函数一次只接收两个形状为 [D] 的向量,并返回一个标量。它的职责很小,这正适合交给 vmap 做批量提升:
import torch

def single_dot(x, y):
    # 这里的函数只处理一个样本,两个输入都没有 batch 维度。
    return torch.dot(x, y)

features = torch.randn(3, 5)  # 3 个样本,每个样本有 5 个特征。
weights = torch.randn(3, 5)   # 与 features 一一对应的另一组向量。
这里的关键约定是:single_dot 看到的是 [D],而外部数据是 [N, D]。如果不先写清这组形状,后面即使代码能够调用,也很难判断 in_dims 是否配置正确。
用 torch.func.vmap 把函数提升为批量函数
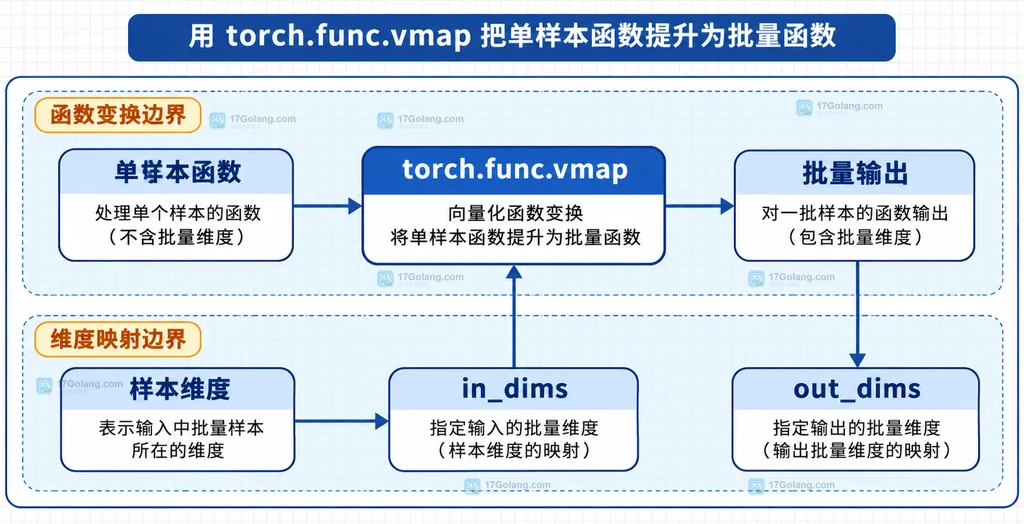
默认情况下,torch.func.vmap(single_dot) 会把每个输入的第 0 维当作映射维度。因此 [N, D] 会被逐样本视为 N 个 [D],返回的 N 个标量再组合成 [N]:
batched_dot = torch.func.vmap(single_dot)

scores = batched_dot(features, weights)
# scores 的语义形状是 [N],每个位置对应一对向量的点积。
这不是把 Python 循环原样搬进 vmap,而是告诉 PyTorch:这个函数本来就按单样本定义,现在把指定维度提升成批处理维度。官方文档也把这种写法用于构造批量点积函数。
多个输入不一定都要带 batch 维度
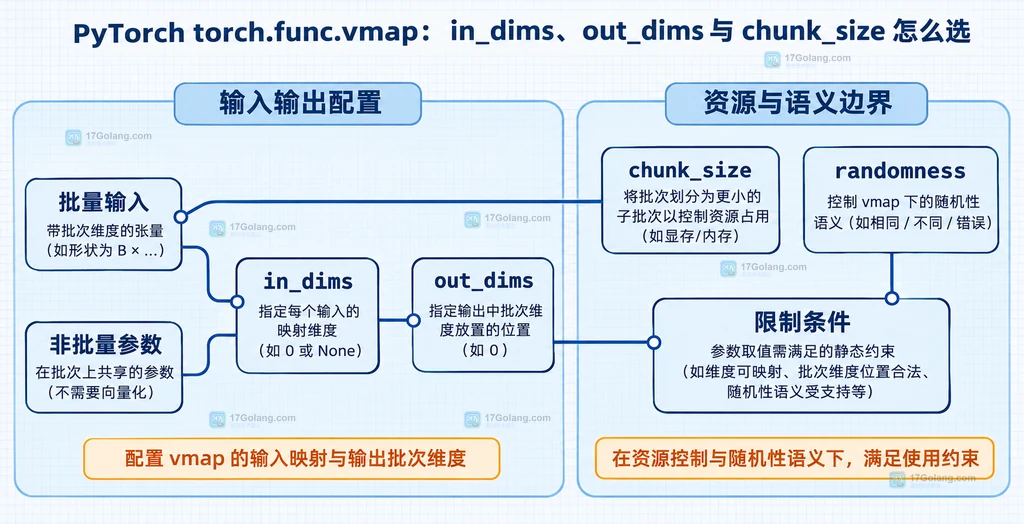
如果一个参数随样本变化,另一个参数对整个批次共享,就不要把两个参数都伪装成批量输入。用 in_dims=(0, None) 明确说明:第一个输入沿第 0 维映射,第二个输入不映射。
def scaled_score(x, weight, bias):
    # x 是单样本向量;weight 和 bias 是整个批次共享的参数。
    return torch.dot(x, weight) + bias

batched_score = torch.func.vmap(scaled_score, in_dims=(0, None, None))
shared_weight = torch.randn(5)  # 共享参数不增加 batch 维度。
shared_bias = torch.tensor(0.25)
scores = batched_score(features, shared_weight, shared_bias)
# scores 的语义形状仍是 [N]。
in_dims 的结构要和函数输入结构对应。对于元组、字典等嵌套输入,也要用相同的嵌套结构描述哪些字段带批量维度;否则容易把共享参数误当成按样本变化的参数。
in_dims 和 out_dims 怎样配合
in_dims 解决“从输入哪里取样本”,out_dims 解决“把映射维度放在输出哪里”。例如单样本函数返回长度为 D 的向量,输入的样本维度在第 0 维时,默认输出通常是 [N, D];如果需要把样本维度放到最后,可以把 out_dims 设为 1:
def expand_one(x):
    # 单样本输入 [D],逐元素变换后仍返回 [D]。
    return x.square()

batch_first = torch.func.vmap(expand_one, in_dims=0, out_dims=0)
batch_last = torch.func.vmap(expand_one, in_dims=0, out_dims=1)

result_first = batch_first(features)  # 语义形状 [N, D]。
result_last = batch_last(features)    # 语义形状 [D, N]。
这里的 out_dims 只是输出布局选择,不是额外的转置优化。后续算子如果要求 batch-first 布局,就保持默认的 0;如果已有接口把样本维度放在最后,再显式选择 1,避免在调用链中到处补 permute。
显存紧张时用 chunk_size 分块
完整向量化会一次处理所有映射样本,通常更利于减少 Python 调度,但中间结果也可能变大。chunk_size 可以把一次 vmap 分成若干批;它不是改变函数逻辑的开关,而是处理规模的折中参数。可以先保持默认值,再根据实际内存情况调整:
def feature_transform(x):
    # 只描述单样本计算,避免在函数内部手动处理 batch 维度。
    hidden = x @ torch.randn(x.shape[-1], 8)
    return torch.relu(hidden)

batched_transform = torch.func.vmap(feature_transform, chunk_size=32)
# chunk_size=32 表示分块处理映射样本,具体值要结合输入规模和显存决定。
如果把 chunk_size 设为 1,语义上接近逐样本循环;如果设为 None,则使用一次完整映射。它不会自动解决可变长度序列,也不会把任意 Python 对象变成可批处理张量。
随机操作和副作用是 vmap 的边界
不要把“能写成一个函数”误解成“任何函数都能被 vmap”。函数应尽量只依赖输入并返回 Tensor;修改外部列表、依赖 Python 随机数、按样本改变全局状态等副作用,都可能破坏向量化语义。
def noisy_one(x):
    # 这个函数包含 PyTorch 随机操作,必须显式选择随机性策略。
    return x + torch.randn_like(x)

batched_noisy = torch.func.vmap(noisy_one, randomness="different")
# randomness="different" 让不同映射样本使用不同的 PyTorch 随机状态。
默认的 randomness="error" 会让随机 PyTorch 操作直接暴露出来;same 和 different 分别表达共享或区分随机性的意图,但这个参数不管理 Python 标准库或 NumPy 的随机数。遇到不支持的算子、数据依赖的 Python 分支或明显副作用时,应优先改写成纯 Tensor 函数,不能只靠改参数硬压过去。
一张表记住参数选择
| 问题 | 先看哪个参数 | 判断方式 |
|---|---|---|
| 哪个输入维度代表样本 | in_dims | 按每个输入分别写整数或 None |
| 输出中的样本维度放哪 | out_dims | 让结果布局匹配后续算子 |
| 一次处理多少样本 | chunk_size | 显存不足时从较小分块开始 |
| 随机操作如何解释 | randomness | 明确相同、不同或直接禁止 |
常见问题
vmap 是不是只能处理一个输入?
不是。多个输入可以用元组形式的 in_dims 分别指定;共享参数用 None 表示。
vmap 会自动处理变长序列吗?
不会。变长序列仍需要 padding、打包或其他明确的数据组织方式,不能把可变长度当成普通 batch 维度直接交给 vmap。
什么时候普通 for 循环更合适?
当函数包含难以向量化的控制流、外部副作用、未覆盖的算子或批量计算会造成明显内存峰值时,保留普通循环往往更容易维护。
总结
最稳妥的路径是先把单样本函数和 Tensor 形状写清楚,再用 torch.func.vmap 提升第 0 维;多个输入用 in_dims 区分随样本变化与批次共享的参数,输出布局用 out_dims 统一,显存压力交给 chunk_size,随机操作则显式声明策略。这样 vmap 才是清晰的函数变换,而不是隐藏在代码里的批处理魔法。
-
Golang · Go教程 | 1个月前 | goroutine · Context · Go教程 · 批处理 · 批处理 Timer WithTimeout Go context WithCancelCause 父子取消链441 收藏
-
403 收藏
-
229 收藏
-
338 收藏
-
307 收藏
-
403 收藏
-
231 收藏
-
294 收藏
-
144 收藏
-
230 收藏
-
375 收藏
-
308 收藏
-
160 收藏
-
386 收藏
-
419 收藏
-
141 收藏
-
164 收藏
-

- 前端进阶之JavaScript设计模式
- 设计模式是开发人员在软件开发过程中面临一般问题时的解决方案,代表了最佳的实践。本课程的主打内容包括JS常见设计模式以及具体应用场景,打造一站式知识长龙服务,适合有JS基础的同学学习。
- 立即学习 543次学习
-

- GO语言核心编程课程
- 本课程采用真实案例,全面具体可落地,从理论到实践,一步一步将GO核心编程技术、编程思想、底层实现融会贯通,使学习者贴近时代脉搏,做IT互联网时代的弄潮儿。
- 立即学习 516次学习
-

- 简单聊聊mysql8与网络通信
- 如有问题加微信:Le-studyg;在课程中,我们将首先介绍MySQL8的新特性,包括性能优化、安全增强、新数据类型等,帮助学生快速熟悉MySQL8的最新功能。接着,我们将深入解析MySQL的网络通信机制,包括协议、连接管理、数据传输等,让
- 立即学习 500次学习
-

- JavaScript正则表达式基础与实战
- 在任何一门编程语言中,正则表达式,都是一项重要的知识,它提供了高效的字符串匹配与捕获机制,可以极大的简化程序设计。
- 立即学习 487次学习
-

- 从零制作响应式网站—Grid布局
- 本系列教程将展示从零制作一个假想的网络科技公司官网,分为导航,轮播,关于我们,成功案例,服务流程,团队介绍,数据部分,公司动态,底部信息等内容区块。网站整体采用CSSGrid布局,支持响应式,有流畅过渡和展现动画。
- 立即学习 485次学习