
PyTorch 使用 torch.compile 后,第一次调用通常不能和后续调用放在同一个平均值里:第一次可能包含图捕获、后端编译和缓存建立,后续兼容输入才更接近稳态执行。如果输入形状触发 guard failure,还会出现新的编译分支。正确做法是把首次调用单独记录,把预热后的多次调用作为稳态指标,并用日志识别重新编译。
官方地址:https://docs.pytorch.org/docs/stable/generated/torch.compile.html
先回答标题:首次编译耗时、稳态执行耗时和重新编译耗时是三个不同指标。不要用一次冷启动时间判断长期吞吐,也不要把改变输入形状后的慢调用误认为普通缓存未命中。
先拆开 torch.compile 的四段耗时
可以把一次调用链拆成四段:模型和输入准备属于 setup;第一次进入编译区域时可能发生图捕获与后端编译;同一代码对象和兼容输入再次调用时,通常会复用已经缓存的编译结果;输入不满足已有 guards 时,可能创建新的编译结果。这里的“可能”很重要,因为实际是否重新编译取决于代码路径、输入形状和 guard 条件。
| 阶段 | 应该回答的问题 | 是否放进稳态平均值 |
|---|---|---|
| setup | 模型、输入和设备准备花了多久 | 按服务启动或离线任务单独记录 |
| 首次调用 | 当前代码路径的编译准备成本是多少 | 不放进稳态平均值 |
| 缓存命中 | 兼容输入的实际执行速度是多少 | 放入稳态样本 |
| 重新编译 | 输入或 guard 变化是否制造额外编译成本 | 单独计数和分析 |
PyTorch 官方文档说明,编译结果会缓存到代码对象上;当已有结果不适用时,同一帧可能被多次编译,这类情况可用 TORCH_LOGS=guards 辅助定位。默认的 dynamic=None 会在检测到动态性后尝试生成更动态的内核,但这不等于所有形状都能无条件复用。
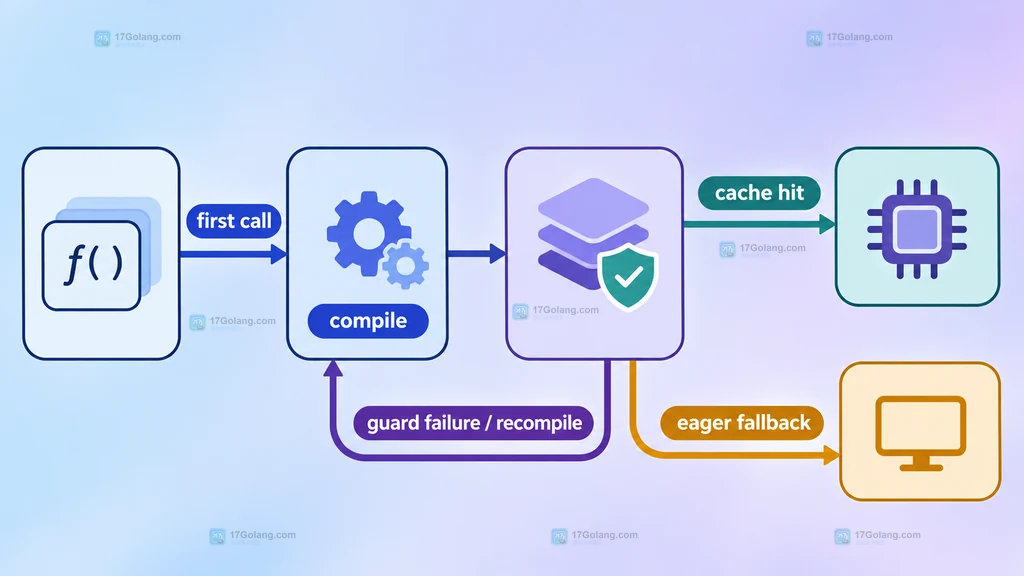
用同一输入建立首次调用和缓存命中的对照
第一组对照只改变调用次数,不改变模型、设备、dtype 和输入形状。这样可以把第一次调用的冷启动成本,与相同输入再次执行的成本分离出来。下面示例只展示测量方法,具体耗时会随设备、模型和 PyTorch 环境变化。
import time
import torch


class TinyBlock(torch.nn.Module):
    def __init__(self, width: int) -> None:
        super().__init__()
        # 用固定形状的小模块演示编译与后续调用的差异。
        self.linear = torch.nn.Linear(width, width)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        # 保持计算路径简单,便于把注意力放在计时边界上。
        return torch.relu(self.linear(x))


def sync_device(device: torch.device) -> None:
    # CUDA 调用可能异步执行,计时前后都要等待设备完成工作。
    if device.type == "cuda":
        torch.cuda.synchronize()


device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = TinyBlock(width=1024).to(device).eval()
compiled = torch.compile(model, mode="default")
sample = torch.randn(32, 1024, device=device)

with torch.inference_mode():
    sync_device(device)
    cold_start = time.perf_counter()
    compiled(sample)
    sync_device(device)
    first_call_seconds = time.perf_counter() - cold_start

    sync_device(device)
    warm_start = time.perf_counter()
    compiled(sample)
    sync_device(device)
    second_call_seconds = time.perf_counter() - warm_start

print({
    "first_call_seconds": first_call_seconds,
    "second_call_seconds": second_call_seconds,
})
这里的第二次调用只是一个对照样本,不足以代表稳定均值。它的价值在于快速确认“第一次很慢、第二次明显不同”是否存在;正式比较还要进行预热并采集多个兼容调用。
用预热和同步设计稳态基准
稳态基准至少要有三个明确边界:预热阶段负责让当前输入路径完成首次编译,测量阶段只使用同一组兼容输入,同步阶段负责避免异步设备把工作拖到计时区间之外。CPU 环境没有 CUDA 同步需求,但保留统一的同步函数可以让脚本迁移到 GPU 时不必重写计时逻辑。
def measure_steady_state(
    fn,
    sample: torch.Tensor,
    device: torch.device,
    warmup: int = 3,
    runs: int = 20,
) -> tuple[float, float]:
    with torch.inference_mode():
        # 预热阶段不纳入稳态样本,允许首次编译和缓存建立发生在这里。
        for _ in range(warmup):
            fn(sample)
        sync_device(device)

        # 只测量输入形状和调用路径已经稳定的连续样本。
        start = time.perf_counter()
        for _ in range(runs):
            fn(sample)
        sync_device(device)
        elapsed = time.perf_counter() - start

    # 同时返回总时长和每次平均值,避免只保留一个不可解释的数字。
    return elapsed, elapsed / runs


total_seconds, mean_seconds = measure_steady_state(
    compiled,
    sample,
    device,
    warmup=5,
    runs=50,
)
print({"total_seconds": total_seconds, "mean_seconds": mean_seconds})
如果要比较 eager 和 compiled 两个版本,应该让两者使用同一份模型权重、同一设备、同一输入和同一批次大小,并分别执行各自的预热。不能让 eager 版本使用冷数据、compiled 版本使用已缓存的数据,然后把结果归因给编译优化。
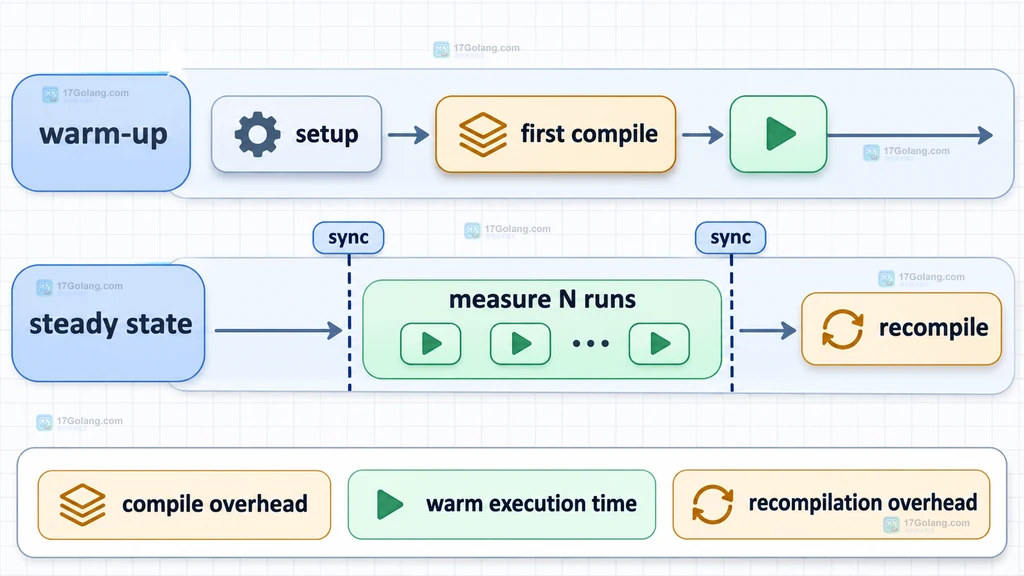
输入形状变化时,怎样识别重新编译
只看总耗时无法判断某次变慢是设备抖动、数据搬运还是重新编译。可以在单独的诊断运行中打开 guards 日志,再有意使用不同形状的输入做对照。诊断日志不应和正式稳态基准混在一起,否则日志本身也可能影响测量。
# 仅在诊断进程启动前打开 guards 日志,便于观察重新编译原因。
TORCH_LOGS=guards python benchmark_compile.py
with torch.inference_mode():
    # 相同形状用于观察已有编译结果是否能复用。
    compiled(torch.randn(32, 1024, device=device))

    # 改变 batch 维度,专门观察动态形状或 guard 条件的影响。
    compiled(torch.randn(64, 1024, device=device))

    # 再回到原形状,比较是否命中已保存的编译分支。
    compiled(torch.randn(32, 1024, device=device))
不要把“换了形状后还能运行”直接理解成“没有重新编译”。要结合 guards 日志和分阶段计时判断。如果输入形状集合很大,应把每种形状的首次成本、后续均值和重新编译次数分别记录;否则一个混合平均值无法说明服务到底是在复用缓存,还是不断生成新分支。
按使用场景选择应该报告的指标
| 场景 | 建议报告 | 不应单独下结论的指标 |
|---|---|---|
| 在线服务启动 | setup、首次编译总成本、预热是否完成 | 只看稳态平均耗时 |
| 固定形状批处理 | 预热后平均耗时、吞吐和显存影响 | 把首次调用混入平均值 |
| 动态 batch 推理 | 按形状分组的首次成本、稳态成本、重新编译次数 | 所有形状混合成一个平均值 |
| 优化回归排查 | guards 日志、编译分支数、eager 回退迹象 | 只比较两次偶然调用 |
此外,mode 会影响编译和执行策略,reduce-overhead 可能以额外内存换取较低的 Python 调度开销,不能把不同 mode 的结果直接当成同一个配置下的前后对比。基准记录至少应包含 PyTorch 版本、设备类型、输入形状、dtype、batch size、mode、预热次数和测量次数。
常见问题
第一次调用很慢,是不是 torch.compile 失效了?
不一定。第一次调用可能正承担图捕获和后端编译成本。先把它与预热后的兼容调用分开,再判断稳态是否改善。
第二次调用仍然很慢,应该怎么查?
先确认 CUDA 计时前后是否同步,再用 TORCH_LOGS=guards 查看是否发生 guard failure,同时检查第二次输入的形状、dtype 和调用路径是否真的与第一次一致。
dynamic=True 是否一定能避免重新编译?
不能这样保证。官方文档也提示,某些操作或优化仍可能强制特化;应结合实际输入形状和诊断日志判断,而不是只凭参数名推断结果。
为什么不能只测总耗时?
总耗时把 setup、首次编译、缓存命中和重新编译混在一起,无法回答是启动成本高、稳态执行慢,还是输入变化导致重复编译。按阶段记录才便于定位。
小结
区分首次编译和后续执行的核心不是换一个计时函数,而是重新划分测量边界:首次调用单独记,预热后再测稳定输入,GPU 计时加同步,输入形状变化时用 guards 日志确认是否重新编译。这样得到的指标才分别对应启动体验、长期吞吐和动态输入带来的额外成本。




