-
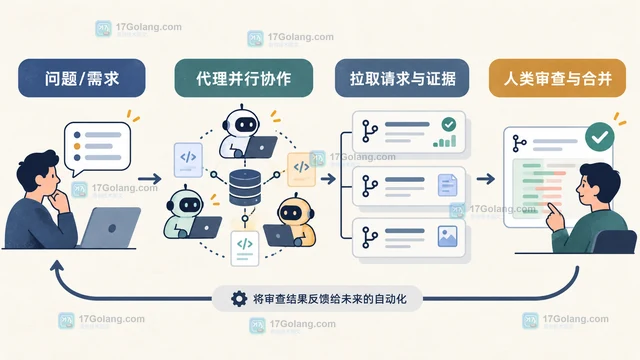
GitHub Universe 2026 把跨项目上下文、并行代理会话、连续工作和分层代码审查连接起来。本文拆解这些能力如何改变 Pull Request 的输入、证据组织与人工合并责任,并给出一套按风险渐进落地的审查流程。
-
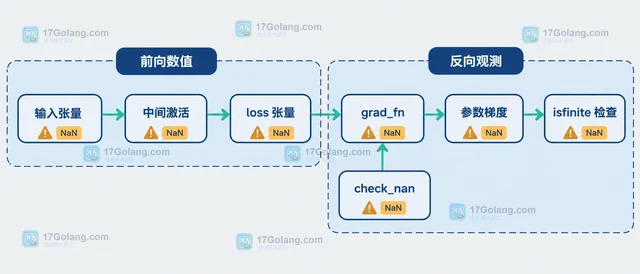
训练在 loss.backward() 阶段出现 NaN 或 Inf 梯度时,可以用 PyTorch autograd anomaly detection 保存前向 traceback,并结合 check_nan、isfinite 和梯度检查把范围收窄到具体算子与输入。
-
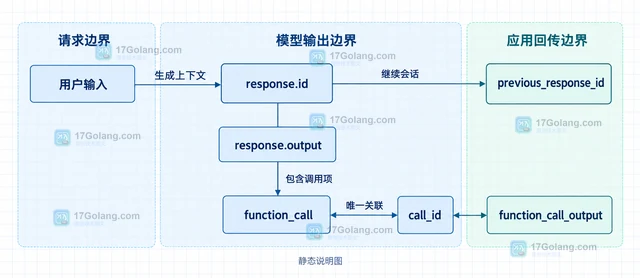
Responses API 的 tool call 不是把一段文本塞回对话,而是用 response.output、function_call、call_id 与 function_call_output 维持调用关联。本文从安全边界、回传控制和审计记录说明状态怎样串联。
-
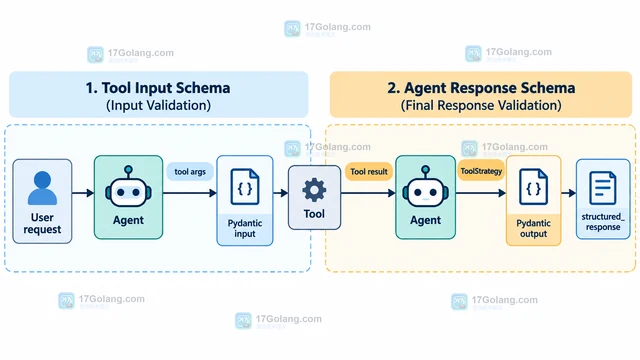
LangChain 的工具参数 schema 和 agent 最终 structured_response 不是同一个边界。本文用 Pydantic 与 ToolStrategy 固定返回结构,并说明 handle_errors、工具组合和 provider-native 输出的适用条件。
-
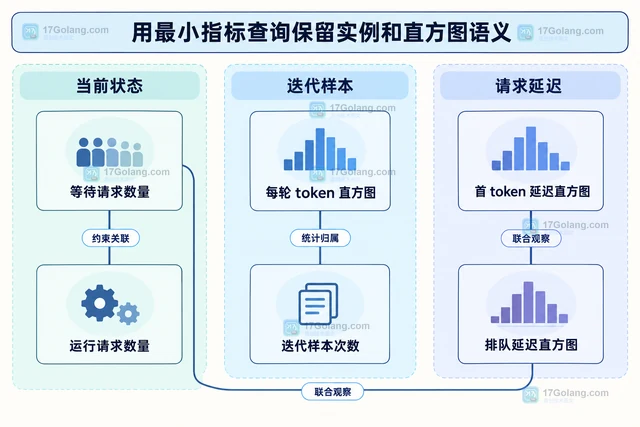
观察 vLLM continuous batching 时,将等待队列、运行请求、每轮 token、KV 缓存和延迟分开统计,说明旧指标迁移、PromQL 查询口径及调度参数的取舍。
-
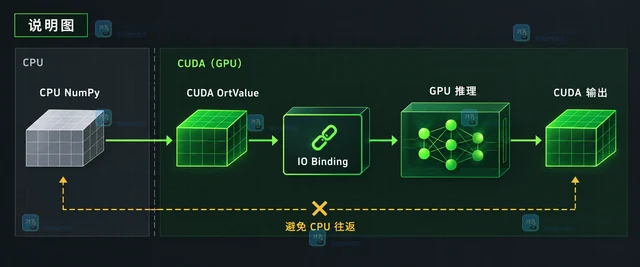
说明 ONNX Runtime Python 推理中 IO Binding 的设备驻留方式:用 CUDA OrtValue 绑定输入、在 GPU 上绑定或分配输出,并判断何时应该回传 CPU。
-
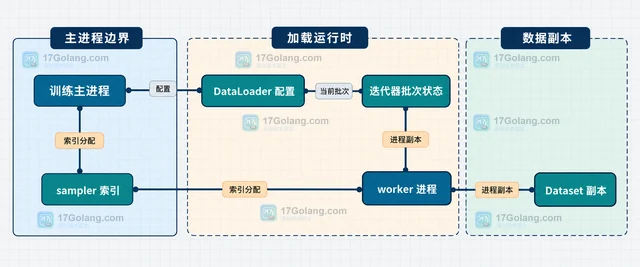
本文说明 PyTorch DataLoader 的 persistent_workers 如何影响 worker 进程、迭代器和 Dataset 副本的生命周期,给出跨 epoch 复用的最小配置,并说明内存、状态管理、IterableDataset 分片和调试边界。
-
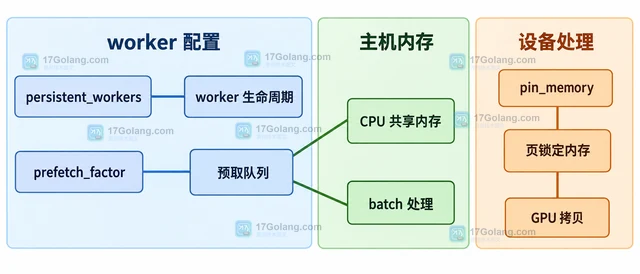
PyTorch DataLoader 的多进程预取会同时受到 num_workers、prefetch_factor 和 batch_size 影响。本文给出按共享内存预算限制预取批次的配置方法,并区分 worker 生命周期、pin_memory 与真实内存瓶颈。
-
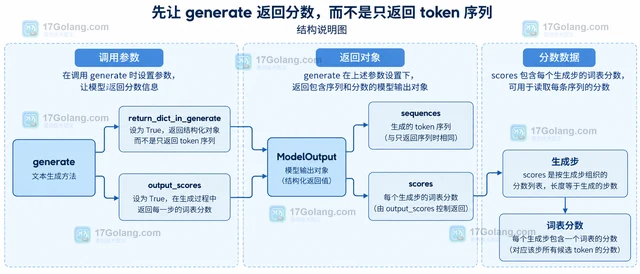
Transformers generate 默认主要返回生成序列。本文说明如何打开 return_dict_in_generate 与 output_scores,使用 compute_transition_scores 对齐每个生成 token 的分数,并区分 decoder-only、encoder-decoder 与 beam search 的边界。
-
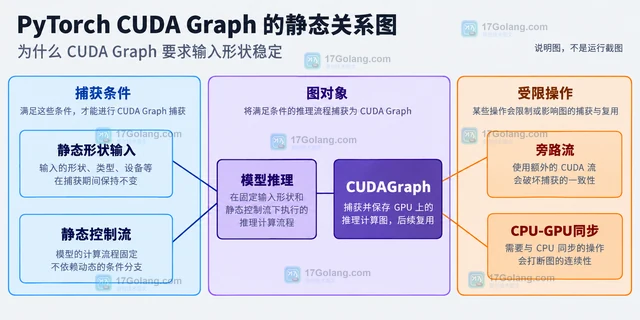
PyTorch CUDA Graph 适合重复执行、输入形状稳定且 CPU 调度开销明显的推理路径。本文用静态输入、旁路流预热、捕获和 replay 说明怎样固定形状复用流程,以及变长请求应该怎样分桶或回退。
-
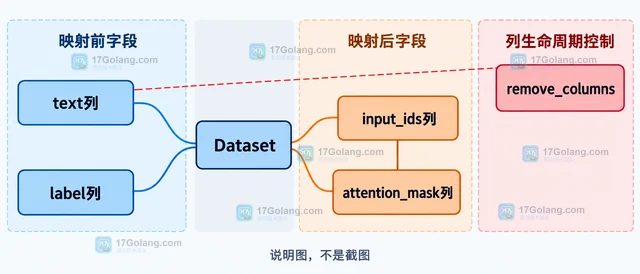
Hugging Face Datasets 的 map 在 batched=True 时按列传入一批样本。本文用一个可复用的 Python 示例说明怎样新增处理列、保留原始列,并用 remove_columns 控制最终字段。
-
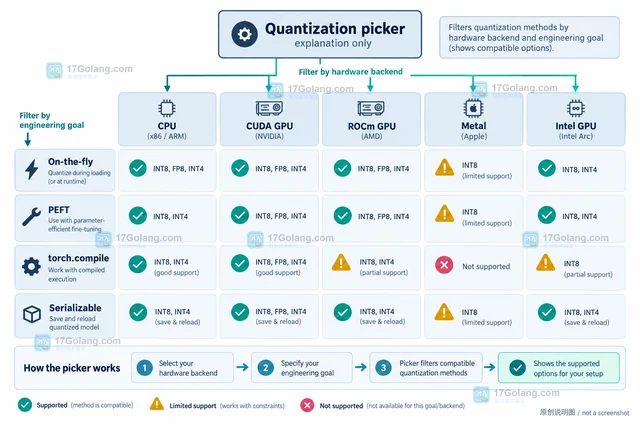
Transformers quantization picker 不是按 4-bit 或 8-bit 盲选,而是结合硬件后端、显存、KV cache、在线量化、PEFT 和编译目标筛出可行方法。本文给出一套按硬件落地的选择步骤与最小验证代码。
-
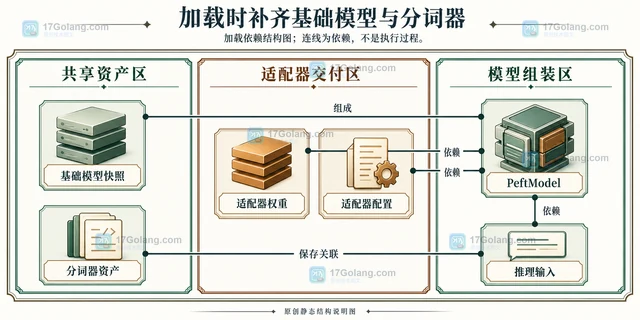
通过 PeftModel.save_pretrained 导出 LoRA 适配器,说明额外训练模块、嵌入层、基础模型依赖与训练断点的区别,并提供参数体积推算和文件统计写法。
-
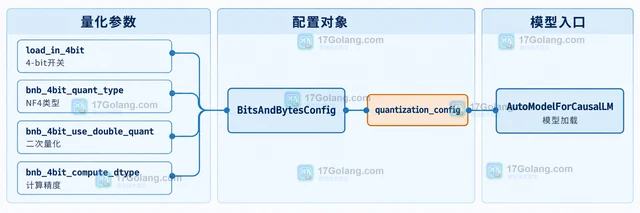
QLoRA 配置中,NF4 决定 4-bit 权重的数据类型,double quant 对量化常量再次量化,compute dtype 决定计算时使用的精度。本文用 BitsAndBytesConfig 给出一份适合 4-bit 训练的配置,并说明显存、训练和推理场景下的取舍。
-
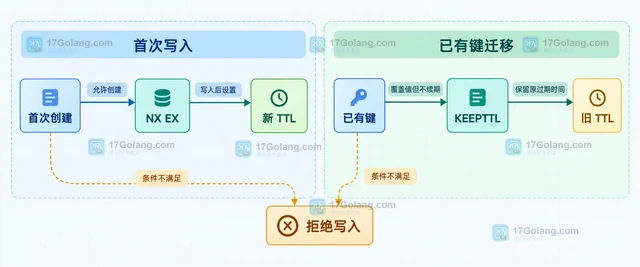
Redis SET 的 NX 决定是否允许写入,EX 负责给成功写入设置新的秒级 TTL,KEEPTTL 则保留已有 TTL。本文用三种迁移场景拆开这些参数的组合边界,避免更新缓存时误续期或误覆盖。
