-
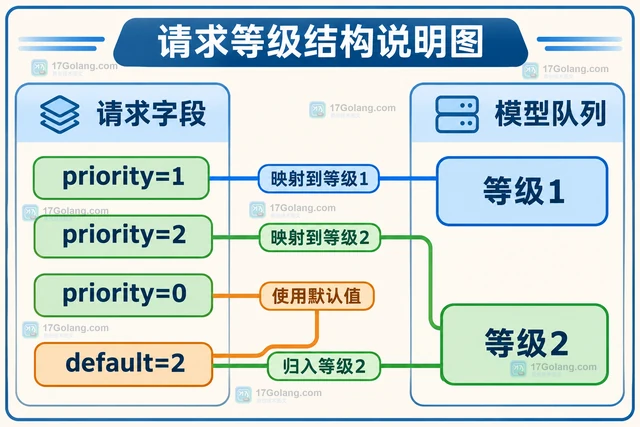
说明 Triton dynamic batcher 的优先级等级、客户端 priority 参数和各级 queue policy,并给出分组延迟、拒绝率与吞吐的对照测量方法。
-
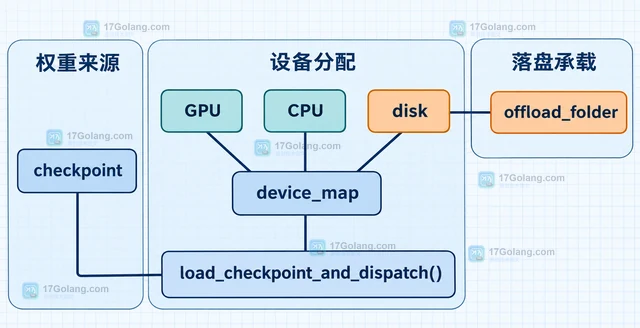
说明 Accelerate disk_offload 如何把模型权重映射到本地目录,区分已加载模型的 offload_dir 与检查点加载时的 device_map、offload_folder,并解释 execution_device、推理边界和磁盘性能影响。
-
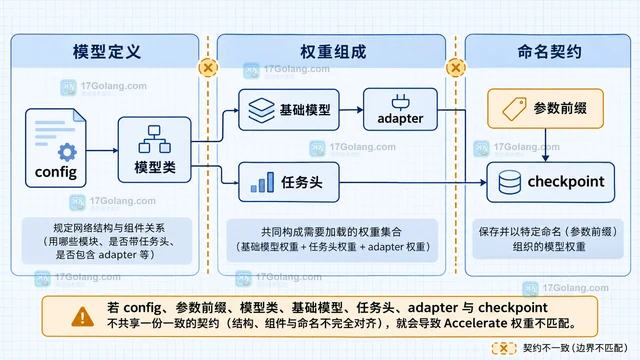
Accelerate 的 load_checkpoint_and_dispatch 遇到 missing 或 unexpected keys 时,先比较 checkpoint 与空模型的 state_dict 键集合,再排查配置、前缀、模型头和 adapter 边界,最后用 strict=True 收窄错误。
-
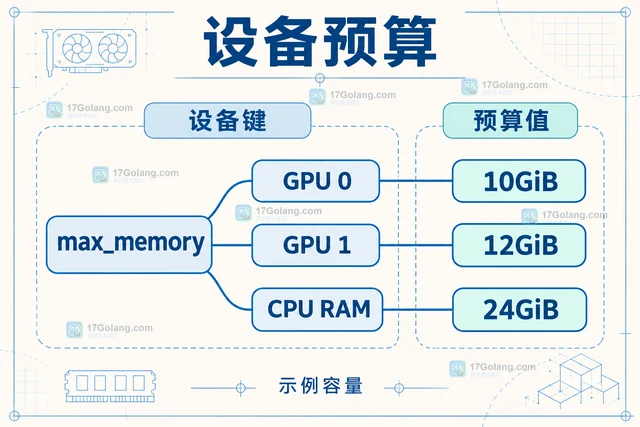
说明 Accelerate max_memory 的 GPU 编号、CPU 预算和容量单位,给出规划与加载代码,并解释权重布局与推理峰值内存的区别。
-
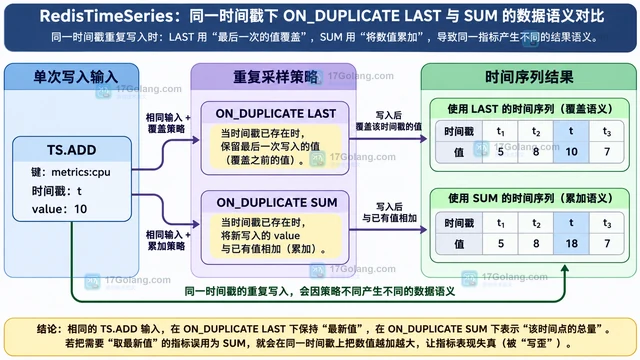
RedisTimeSeries 的 TS.ADD 遇到同一时间戳重复采样时,ON_DUPLICATE LAST 会用新值覆盖旧值,SUM 会把新旧值相加。本文从一次重复上报造成的指标异常入手,说明两种策略的语义、单次命令边界和选型方法。
-
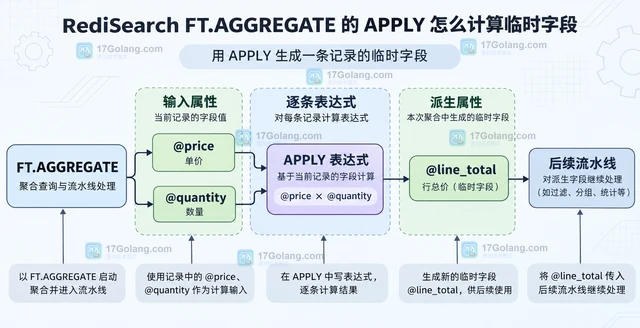
RediSearch FT.AGGREGATE 的 APPLY 会按记录计算表达式并用 AS 生成临时属性,结果还能继续交给 GROUPBY、REDUCE 和 SORTBY。本文用价格乘数量、日期分组和 LOAD 示例说明字段生命周期、管道顺序、类型与缺失值边界。
-
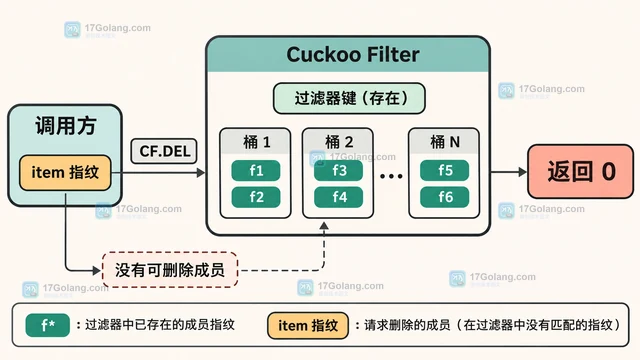
Redis Cuckoo Filter 的 CF.DEL 返回 0,通常表示过滤器中没有找到可删除的成员,而不是命令异常。本文解释删除一次、重复添加后的逐次删除、CF.EXISTS 的边界,以及 WRONGTYPE、参数错误和连接错误的区别。
-
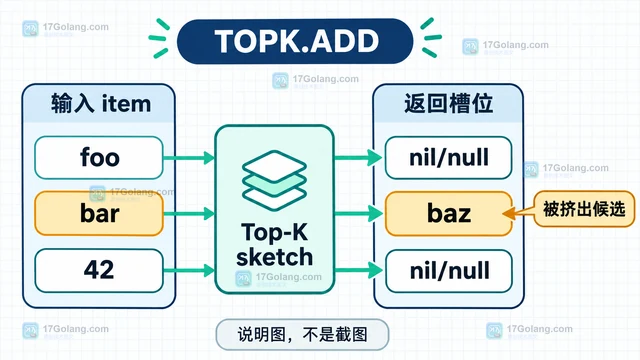
Redis TopK.ADD 的返回数组按输入 item 逐个对齐:非空槽位就是本次被 Top-K 挤出的旧候选,nil/null 表示没有候选退出。本文用单个与批量写入说明判断方法,并区分 Top-K 候选退出与 Redis 全局 key 淘汰。
-
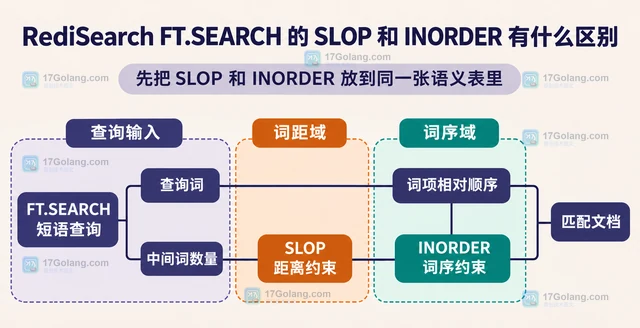
本文用同一组短语解释 RediSearch FT.SEARCH 的 SLOP 和 INORDER:SLOP 控制允许的中间词数量,INORDER 控制查询词顺序,并给出组合使用时的选择边界。
-
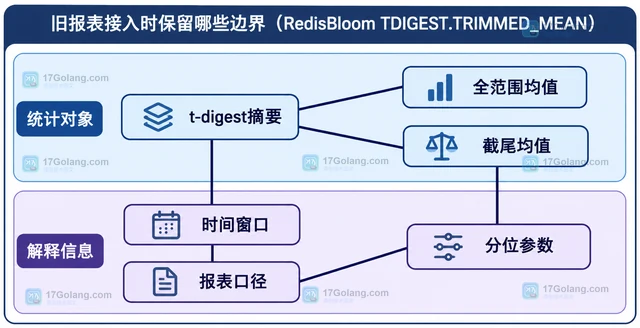
RedisBloom TDIGEST.TRIMMED_MEAN 用分位下界与上界查询截尾均值估计。本文解释0.1、0.9的含义,比较全范围和截尾口径,并说明近似性、空摘要与时间窗口边界。
-
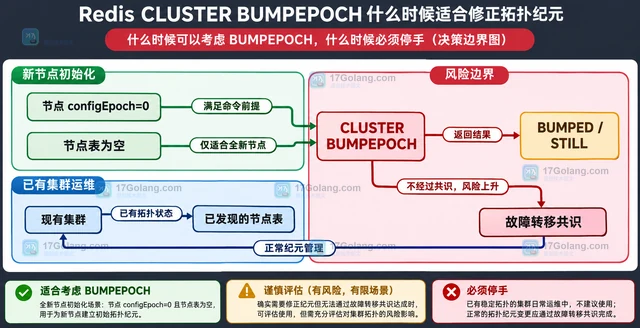
Redis CLUSTER BUMPEPOCH 只推进连接节点的配置纪元,不负责槽位迁移或故障转移。本文用 CLUSTER INFO、CLUSTER NODES 和新节点前提说明何时可考虑、何时必须停手。
-
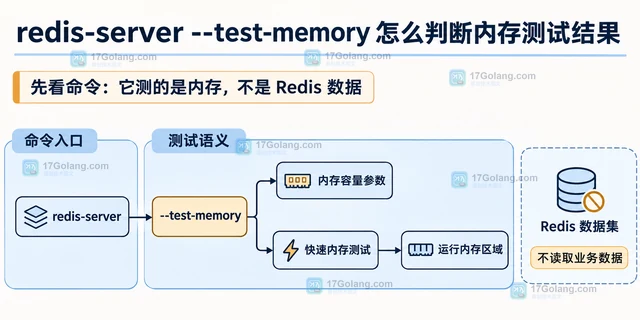
redis-server --test-memory 是 Redis 自带的快速内存检查入口。本文说明参数代表什么、PASSED 能证明什么、内存错误或异常终止如何处理,以及为什么它不能替代 MemTest86、Redis 压测和持久化检查。
-
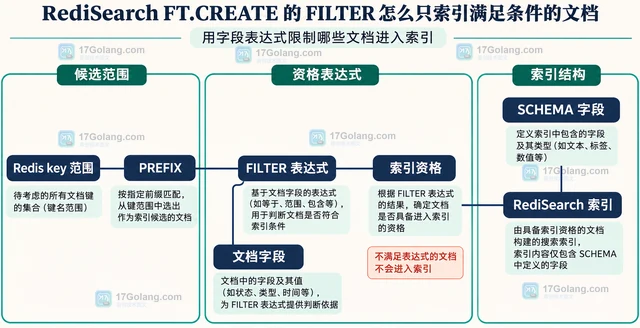
本文解释 RediSearch FT.CREATE 的 FILTER 如何在建索引时筛选文档,区分 PREFIX、字段表达式、@__key 与查询阶段过滤,并说明初始扫描和后续变更的边界。
-
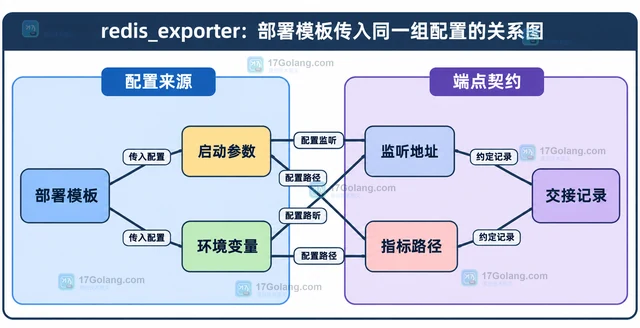
redis_exporter 通过 web.listen-address 配置 HTTP 绑定地址,通过 web.telemetry-path 配置指标路径。本文给出命令行与环境变量写法,区分 Redis 目标、网络可达性和路由错误。
-
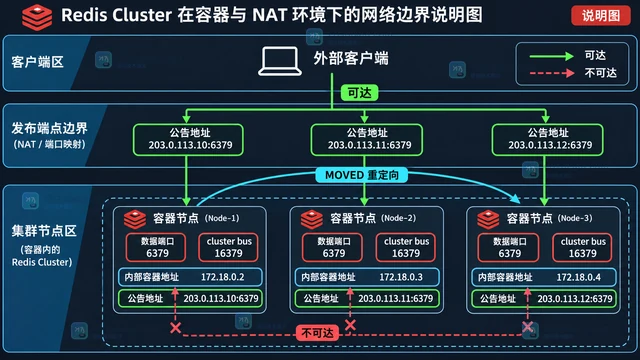
Redis Cluster 放进容器后出现 MOVED 指向容器内网地址、节点 disconnected 或客户端偶发连接失败,通常不是把 cluster-announce-ip 填成 127.0.0.1 就能解决。本文按客户端端口、cluster bus 端口和网络视角拆解填写规则,并给出 Docker 配置示例与 CLUSTER NODES 排查方法。
