-
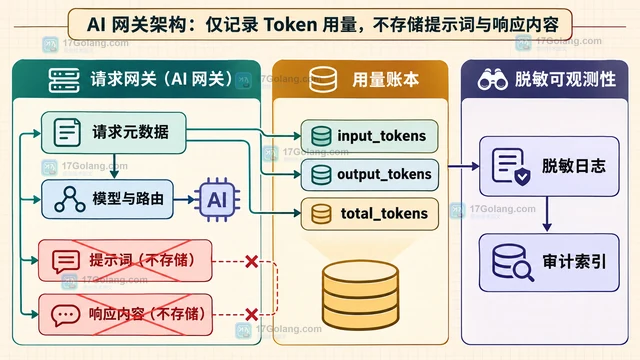
AI 网关可以在模型响应边界读取 input_tokens、output_tokens 和 total_tokens,只把请求标识、模型、延迟、状态与用量写入脱敏事件;本文说明如何拆分模型请求路径、观测路径和聚合账本,并处理流式、重试、缓存、权限与保留期边界。
-
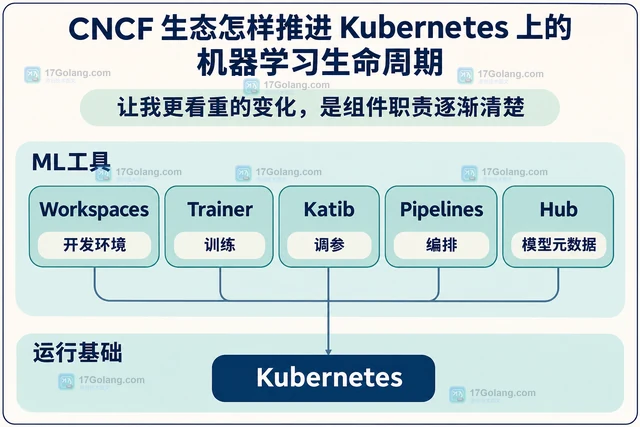
CNCF生态以Kubernetes为基础,通过Kubeflow开发、训练、编排和模型管理组件衔接机器学习任务。本文解读毕业进展、组件职责、元数据边界与分阶段采用的实际取舍。
-
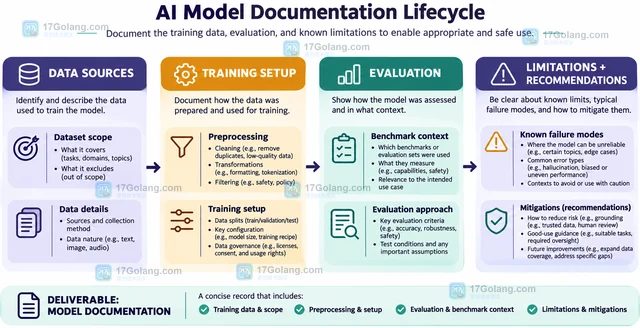
模型卡不只是模型简介,而是把用途、训练数据、训练过程、评估结果和已知限制放在同一份可维护文档中。本文以 Hugging Face Hub 的 README.md 模型卡为例,说明 YAML 元数据与正文怎样分工,以及未知信息如何如实标记。
-
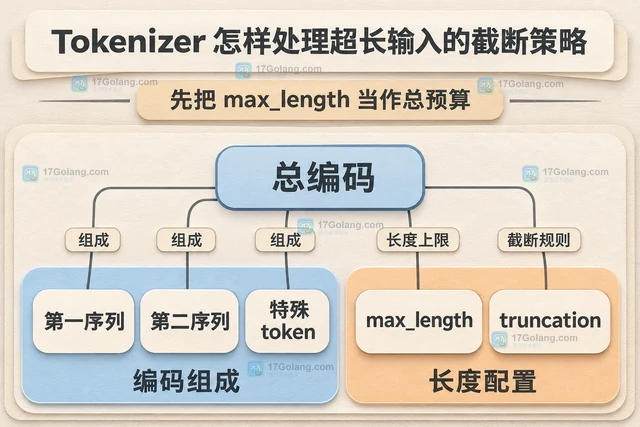
Tokenizer处理超长输入应明确token总预算、截断序列与保留方向。本文介绍Transformers的truncation策略、成对输入的only_second,以及用重叠窗口保留长材料的方法和限制。
-
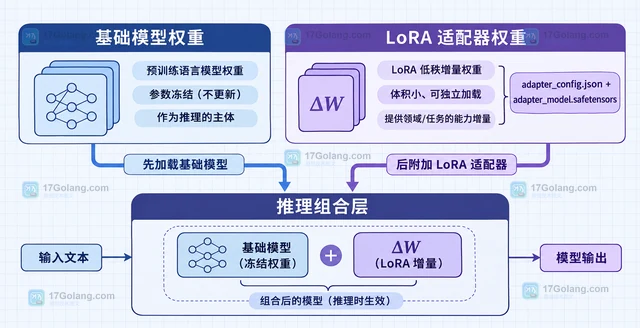
LoRA 适配器不是完整基础模型,通常应先加载兼容的基础模型,再用 PeftModel.from_pretrained 或 Transformers 的 load_adapter 挂载。本文说明多个适配器的命名与切换、unload 和 delete_adapter 的区别,以及保持分离和 merge_and_unload 合并部署的取舍。
-
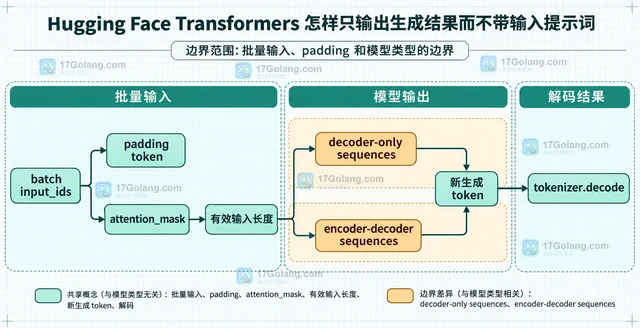
Hugging Face Transformers 的 generate 返回序列可能同时包含输入提示词和新生成 token。本文按 decoder-only、encoder-decoder、批量 padding 三种边界说明如何只解码新增内容,并解释 max_new_tokens、return_dict_in_generate 与 pipeline 输出的区别。
-
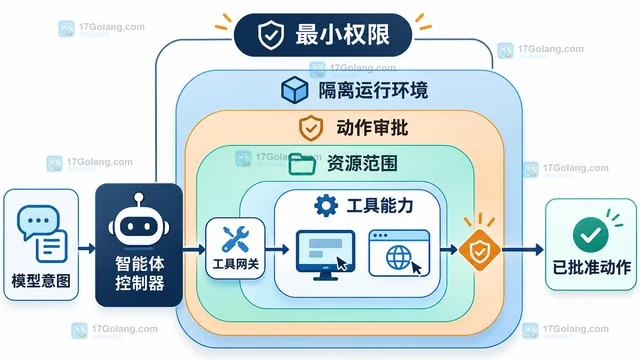
Holo4 这类计算机使用代理可以跨桌面、网页和移动端执行长流程任务,但不应该只用一个总开关管理权限。本文按工具能力、资源范围、动作审批和隔离运行环境四层拆解权限,并给出浏览器、文件系统与 Shell 的策略示例。
-
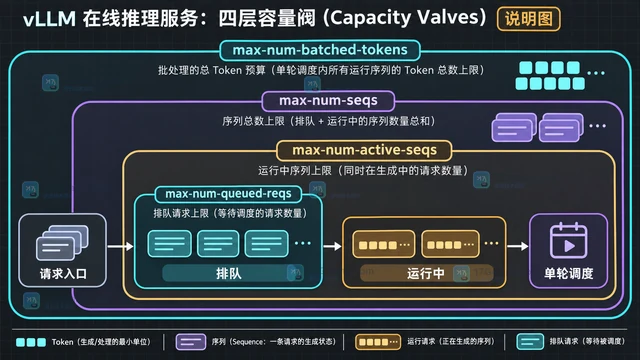
vLLM 的 gpu-memory-utilization 只划定单实例显存预算,不直接限制批处理条数。本文用 max-num-batched-tokens、max-num-seqs、max-num-active-seqs 和排队上限拆开说明显存、单轮批量与入口容量的配置边界。
-
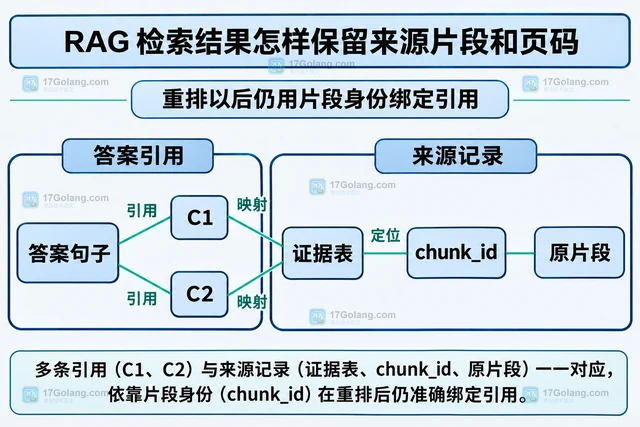
RAG应在解析和切分时保留文档版本、页位置及原文区间,并在检索重排后维持片段身份。本文给出来源字段设计、证据表绑定、旧索引迁移与页码缺失的处理方法。
-
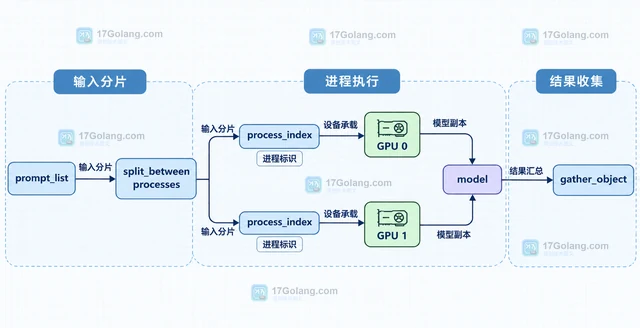
用 CUDA_VISIBLE_DEVICES 和 accelerate launch 明确可见 GPU 与进程数量,再通过 PartialState 读取每个进程的设备,给出多进程推理时的绑定、分片和排错方法。
-
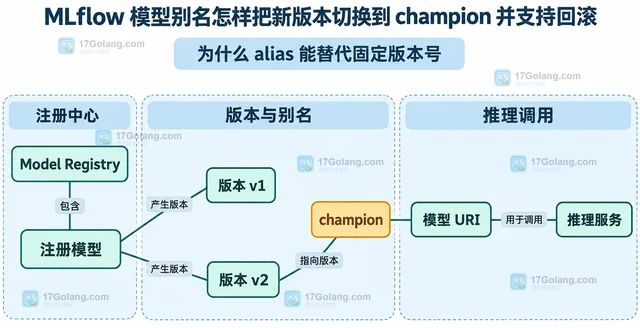
用 MLflow Model Registry 的 champion alias 解耦推理代码与模型版本:切换时指向新版本,出现问题时用同一接口回指旧版本。
-
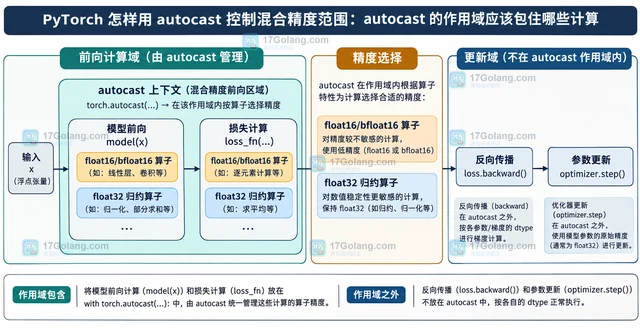
用 PyTorch 的 torch.autocast 控制混合精度范围:明确前向与损失计算的作用域,演示局部关闭 autocast 保留 float32,并说明 GradScaler、推理和常见边界。
-
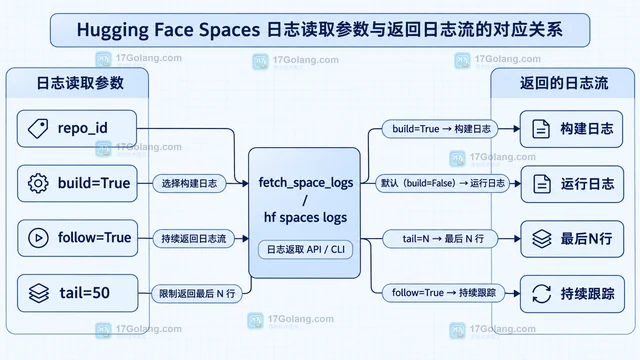
Hugging Face Spaces 排查失败时,先区分构建日志和运行日志,再用 hf spaces logs 或 fetch_space_logs 读取、截取和持续跟踪输出。
-
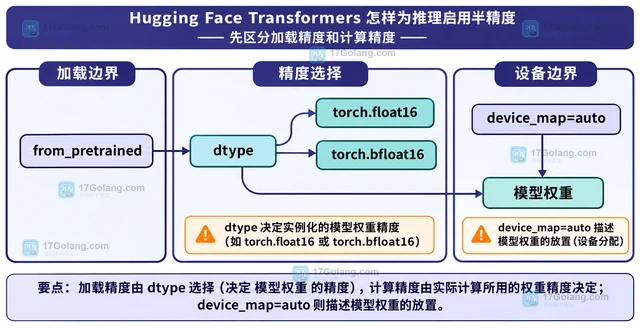
用 Transformers 做推理时,dtype 负责权重加载精度,autocast 负责前向计算精度。本文给出 float16、bfloat16 与 float32 的选择方法、代码示例和兼容性检查清单。
-
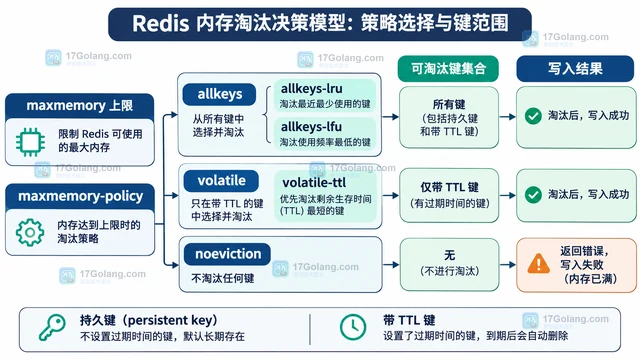
Redis 的 maxmemory-policy 决定内存达到上限后淘汰哪些键,RDB 和 AOF 则决定数据怎样落盘与恢复。本文从缓存、可恢复数据和重要写入三个场景说明两条策略链的边界与组合方式。
