-
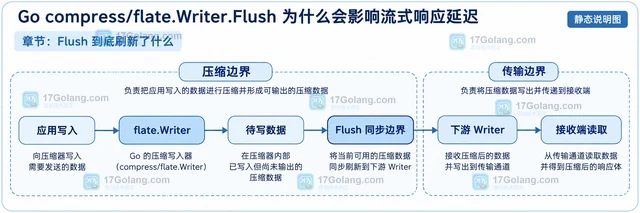
Go 的 compress/flate.Writer.Flush 会把待写压缩数据推到下游,并建立同步边界,因此能降低流式响应的等待感,也会增加写出和压缩边界开销。本文用一个小型流式写入模型说明调用时机。
-
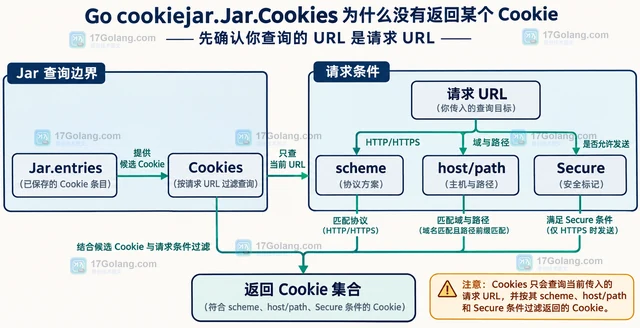
Go cookiejar.Jar.Cookies 返回的是针对某个请求 URL 过滤后的 Cookie,不是 Jar 中的全量内容。本文从 scheme、host、Domain、Path 和 Secure 条件排查为什么某个 Cookie 没有返回。
-
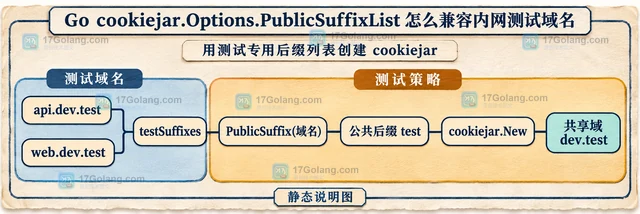
Go cookiejar 遇到 api.dev.test、web.dev.test 这类内网测试域名时,可以注入只服务于测试的 PublicSuffixList。本文解释它对 Domain Cookie 的影响、如何实现并发安全的测试替身,以及为什么不能把 nil 配置带到生产环境。
-
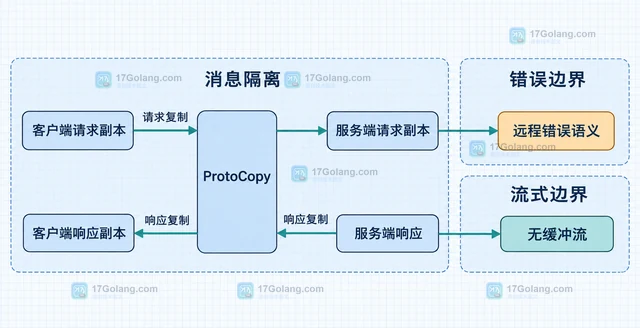
Connect Go 的 connectinprocess transport 可以把 RPC 直接分派到同进程的 connect.Server,不监听端口也能覆盖客户端、服务端拦截器、请求响应复制和错误语义。本文给出测试构造方式,并说明流式背压和仍需真实 HTTP 测试的边界。
-
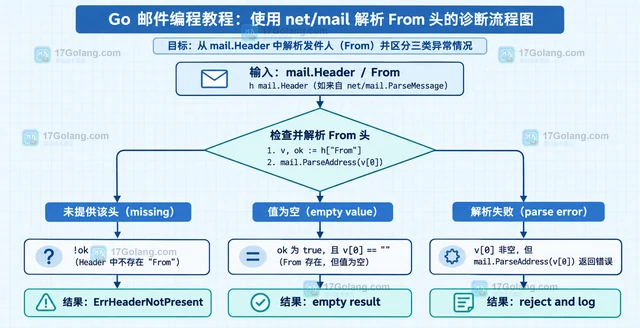
Go net/mail.Header.AddressList 返回 mail.ErrHeaderNotPresent 时,不要把缺少 From 头、空地址值和地址语法错误混成一个结果。本文给出可复用的判断分支、代码和日志清单。
-
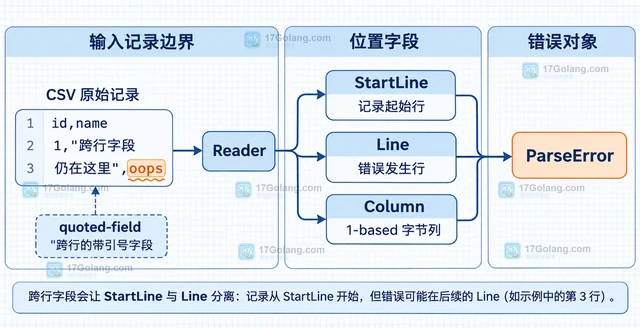
用 errors.As 读取 Go encoding/csv ParseError 的 StartLine、Line、Column 和 Err,正确处理跨行引号、字段数错误与 io.EOF。
-
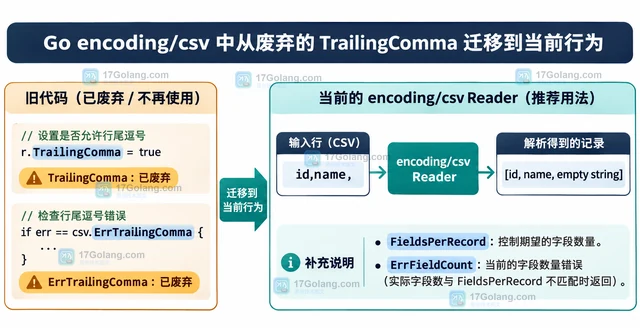
Go 当前 encoding/csv 已不再使用 TrailingComma 和 ErrTrailingComma。本文用迁移示例说明尾随分隔符如何变成空字段、FieldsPerRecord 如何约束列数,以及怎样按业务规则拒绝末尾空值。
-
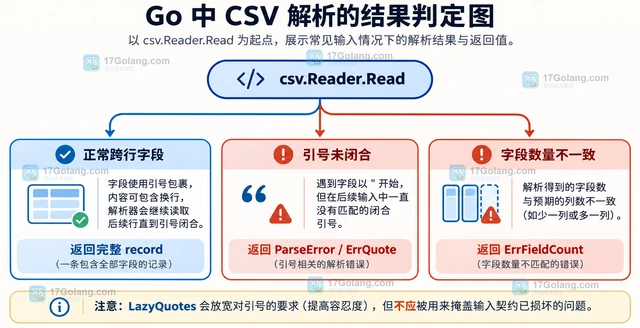
Go encoding/csv 遇到带换行的引号字段时,物理行不等于逻辑记录。本文解释按行拆分为什么会造成字段错位,并用 csv.Reader.Read、ParseError 和字段数量设置给出可执行的排查与读取方案。
-
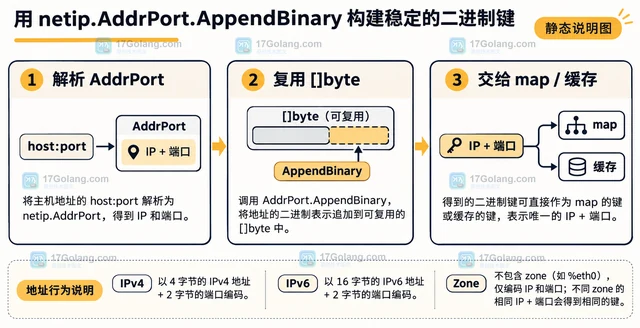
用 Go netip.AddrPort.AppendBinary 把 IP 地址和端口追加到已有字节缓冲区,说明 IPv4、IPv6、端口字节序、错误处理与 UnmarshalBinary 还原方法。
-
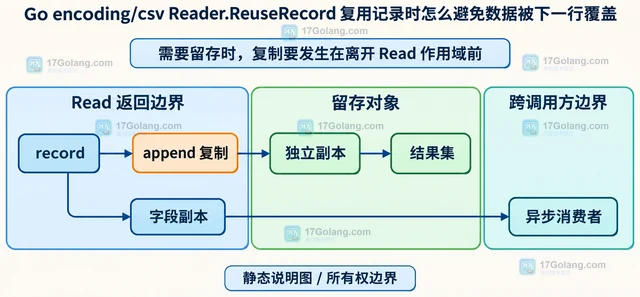
Go encoding/csv 的 Reader.ReuseRecord 可以减少逐行读取时的分配,但后续 Read 可能复用上一条 record 的底层数组。本文按生命周期说明什么时候可以直接处理,什么时候必须复制整行或字段,避免保存结果后被下一行覆盖。
-
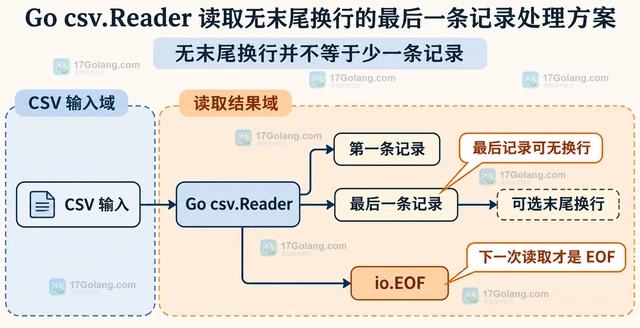
Go csv.Reader 可以读取没有末尾换行符的 CSV 最后一条记录。本文用逐条 Read 和 ReadAll 说明 record、io.EOF、InputOffset、字段数错误与解析错误的边界,避免导入时漏掉尾行。
-
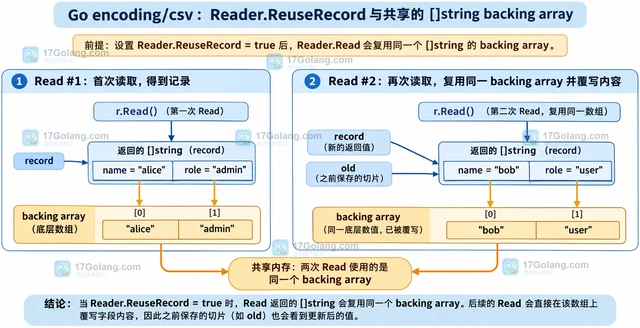
Go encoding/csv.Reader 开启 ReuseRecord 后,Read 返回的 record 可能共享上一条记录的底层数组。本文用保存字段、异步处理和复制边界三个场景说明为什么不能长期持有原切片,并给出如何用基准指标判断复用是否值得。
-
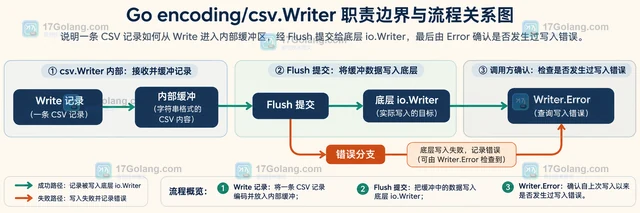
Go 的 csv.Writer 会先把记录写入内部缓冲区,Flush 才把缓冲数据交给底层 io.Writer;因此逐条导出结束后必须在 Flush 之后检查 Writer.Error,才能发现最终提交阶段才暴露的失败。本文给出 Write、Flush、Error 的稳妥顺序,并比较 WriteAll 的返回值语义。
-
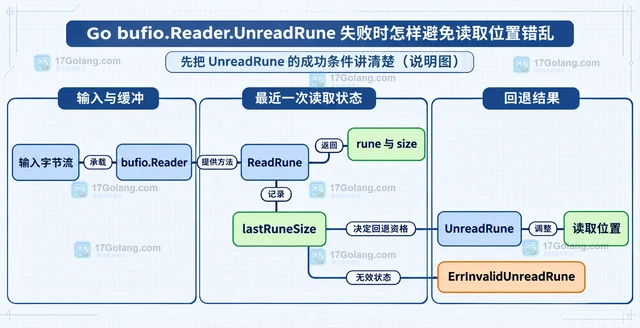
UnreadRune 不是任意读取后的撤销按钮:它要求最近一次方法调用是 ReadRune,而且一次成功回退后不能连续再次回退。本文用逐字符解析示例说明调用契约、失败原因和稳定写法。
-
Go atomic.Uint64.And 可以用反掩码原子清除一个状态位,并返回更新前的旧值。本文说明状态位设计、^flag 的原因、旧值判断、版本边界,以及 And、Or、Swap、CompareAndSwap 的选择。
