-
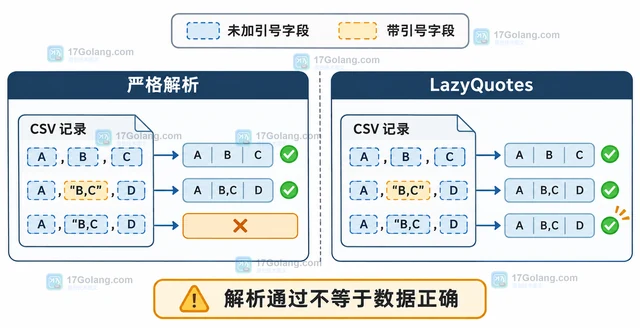
Go encoding/csv 的 LazyQuotes 可以放宽未转义引号的解析,但不能证明字段仍然正确。本文用逐条 Read、ParseError、FieldsPerRecord 和业务字段复核建立兼容导入的检查边界。
-
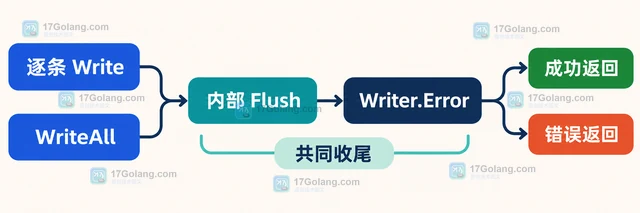
Go encoding/csv 的 Write 主要负责把记录编码到缓冲区,Flush 才尝试把缓冲数据交给底层 io.Writer;因此导出结束后还必须检查 Writer.Error,才能发现刷新阶段才暴露的写入失败。本文按 Write、Flush、Error 的顺序给出稳妥写法。
-
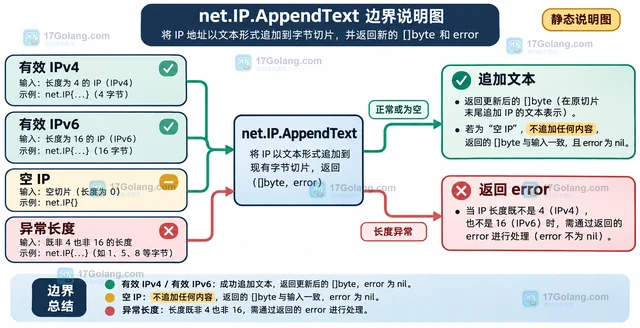
Go 1.24 为 net.IP 增加了 AppendText,它可以把地址文本直接追加到已有 []byte,适合日志、协议字段和批量编码场景。本文从 String 的中间结果、最小调用、空 IP、异常长度和容量复用五个方面说明怎么用,避免把返回切片或 error 处理错。
-
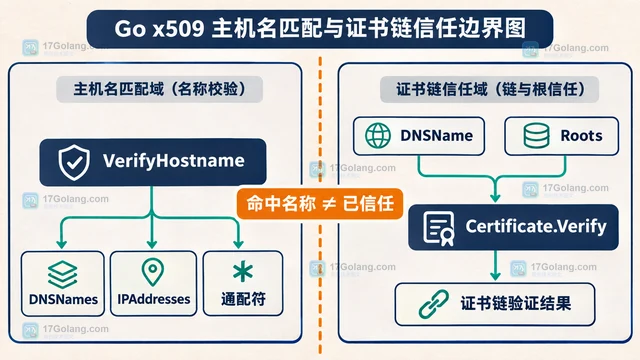
x509.Certificate.DNSNames 表示证书 Subject Alternative Name 中声明的 DNS 名称集合。读取它适合做展示和排查;真正判断主机名是否匹配,应优先使用 VerifyHostname,涉及信任链时再调用 Certificate.Verify 并传入 VerifyOptions.DNSName。
-
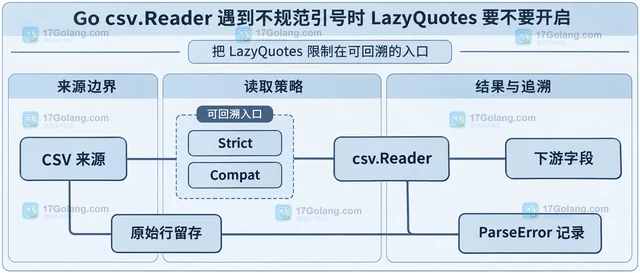
Go 的 csv.Reader 默认按 RFC 4180 解析。遇到裸引号或未成对引号时,LazyQuotes 可以放宽规则,但也会让脏数据进入下游。本文从 ParseError、错误类型、受控入口和回溯记录说明什么时候开、什么时候拒绝。
-
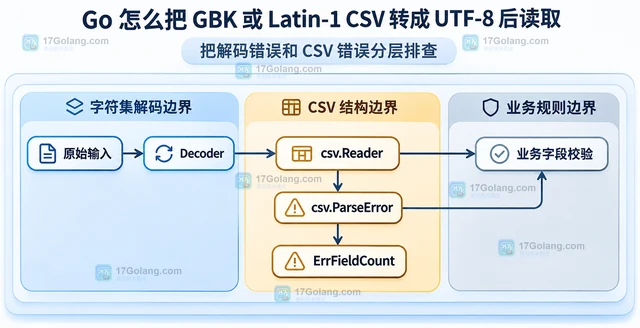
Go 的 csv.Reader 不会自动识别 GBK 或 Latin-1。本文用 x/text/encoding 把解码器接到 csv.Reader 前面,并按错误边界排查字符集、字段数和 CSV 结构问题。
-
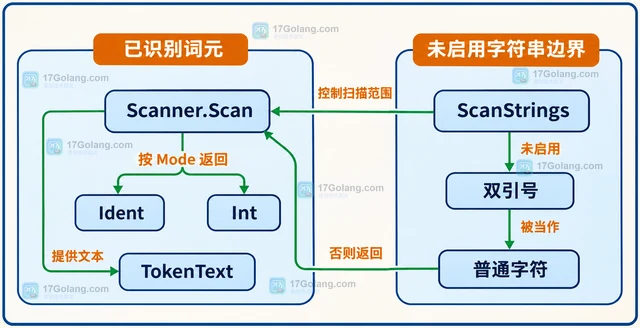
用 text/scanner 扫描源码片段时,可以把 Scanner.Mode 设为 ScanIdents、ScanInts、ScanComments 和 SkipComments 的组合。未启用的字符串或浮点数不会被静默丢弃,而会按字符或子词元返回。
-
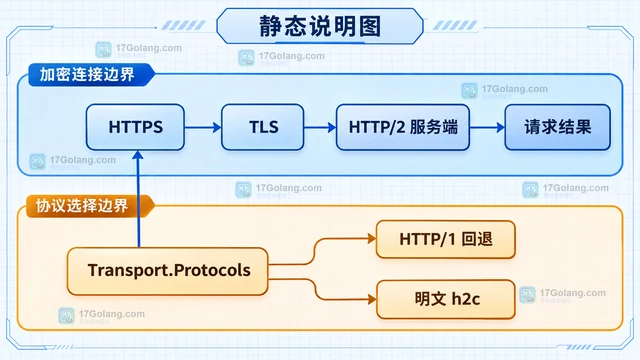
Go 1.24 起可以通过 http.Transport.Protocols 明确声明客户端支持的协议集合。本文说明怎样只启用 TLS 上的 HTTP/2、为什么 ForceAttemptHTTP2 不能代替协议集合配置,以及服务端不支持 HTTP/2、使用明文 h2c 或自定义 TLS 时分别要注意什么。
-
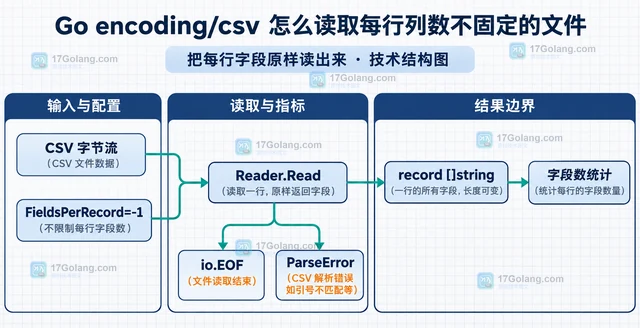
Go encoding/csv 默认会用第一条记录的字段数约束后续行。把 Reader.FieldsPerRecord 设为 -1 后,可以保留每行原始字段,再在读取循环中统计字段数并单独处理解析错误。
-
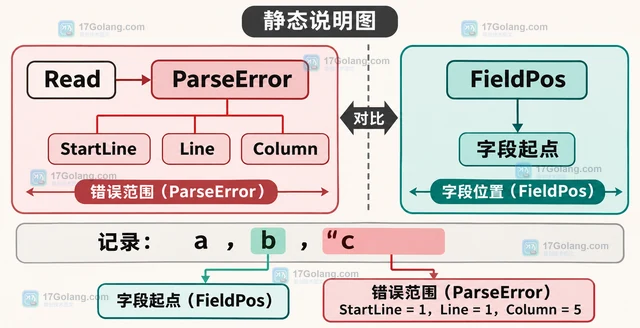
Go 的 encoding/csv 支持带引号的多行字段,报错时不能只按逻辑记录号猜位置。本文结合 Reader.Read、ParseError 和 FieldPos,说明如何拿到真实物理行号与字节列号,并处理中文字段、字段索引和日志记录边界。
-
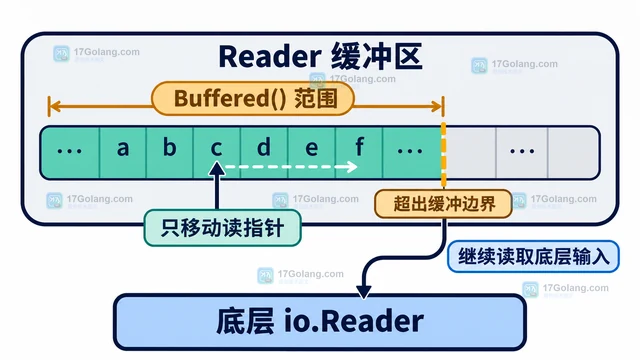
本文用 bufio.Reader.Discard 的返回值拆解完整跳过、部分跳过和 EOF 的边界,说明怎样结合 discarded 与 error 判断截断输入,并给出不会吞掉底层错误的封装方式。
-
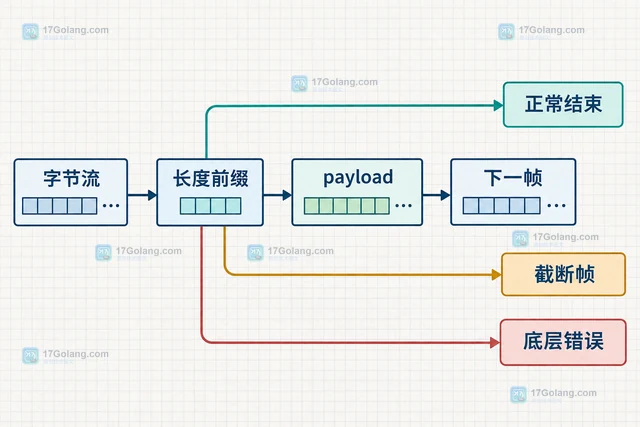
Go binary.ReadUvarint 读取变长整数时,空流返回 io.EOF,读到半截值返回 io.ErrUnexpectedEOF,超过 uint64 范围则返回溢出错误。本文用流式循环示例说明三类结果的处理边界。
-
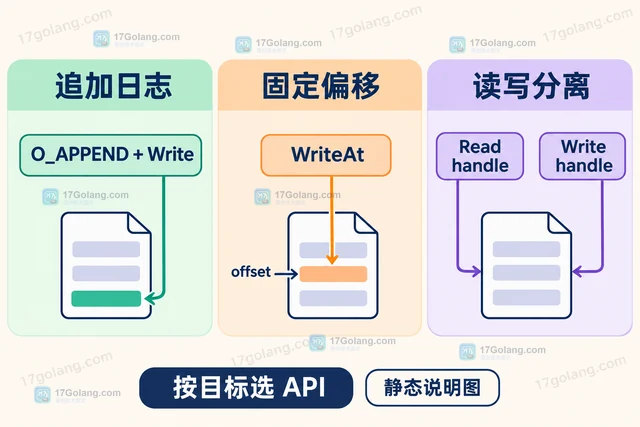
Go 的 O_APPEND 只保证写入时追加到文件末尾,不能把 Seek 返回的偏移当成最终写入位置。本文拆开解释 O_APPEND、Seek 和 Write 的职责,给出追加日志、固定偏移写入和读写分离三种安全选择。
-
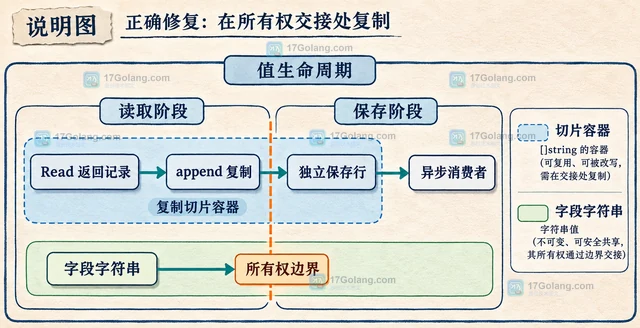
开启 Go csv.Reader.ReuseRecord 后,直接保存 Read 返回的 []string 可能让旧行随下一次读取变化。本文解释切片 backing array 与字段字符串的区别,并给出保存前复制记录的写法。
-
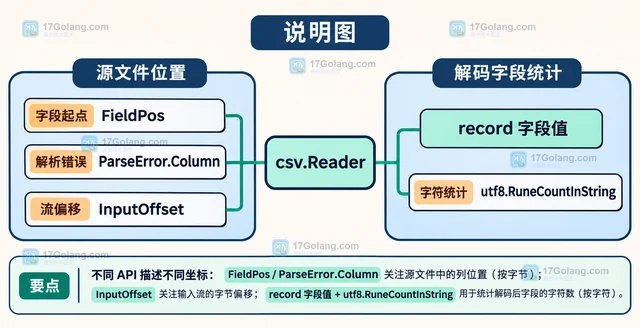
Go csv.Reader.FieldPos 返回的是最近一次 Read 记录中字段起点的 1-based 行列位置,其中列号按 UTF-8 字节而不是 Unicode 字符计数。本文对比 FieldPos、ParseError.Column、InputOffset 与 rune 统计的使用边界。
