
Go语言技术文章
-
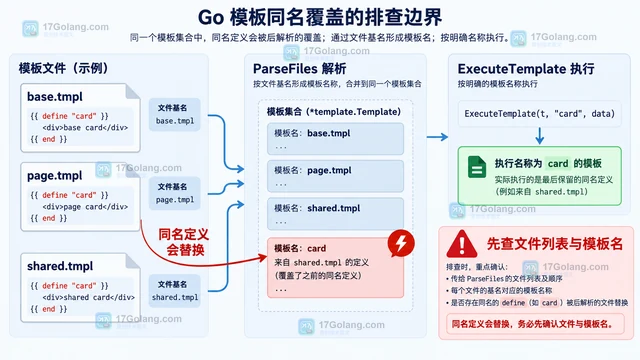 Go text/template 遇到嵌套 define 同名覆盖时,按关联模板、Parse 顺序、文件基名和 ExecuteTemplate 入口逐项定位,避免执行到错误定义。281 收藏
-
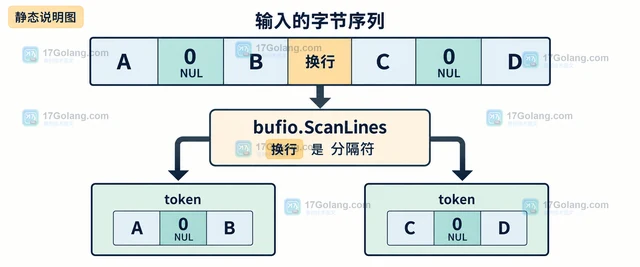 bufio.Scanner 默认按换行切分,输入中的零字节通常会作为普通字节保留。本文用小样例排查默认边界、自定义 NUL 分隔和超长 token 限制,并给出 Scanner 与 Reader 的选择建议。163 收藏
-
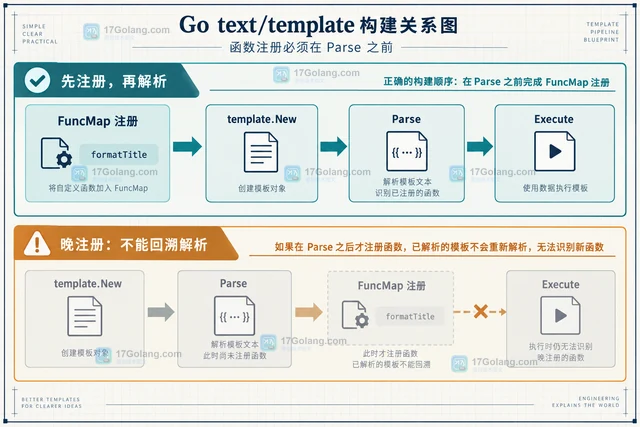 Go 的 text/template 报 function not defined 时,优先检查 FuncMap 是否在 Parse 前注册。本文用最小示例说明正确注册链、集中构造方式,以及解析后替换函数的边界。427 收藏
-
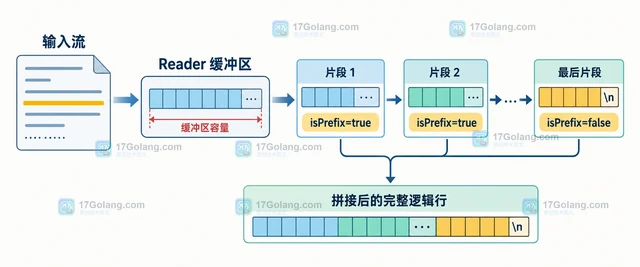 bufio.Reader.ReadLine 遇到超长文本时会通过 isPrefix 返回多个片段。本文用一个可复用的读取函数说明如何拼接软换行、处理 EOF 与错误,并解释返回切片的生命周期。412 收藏
-
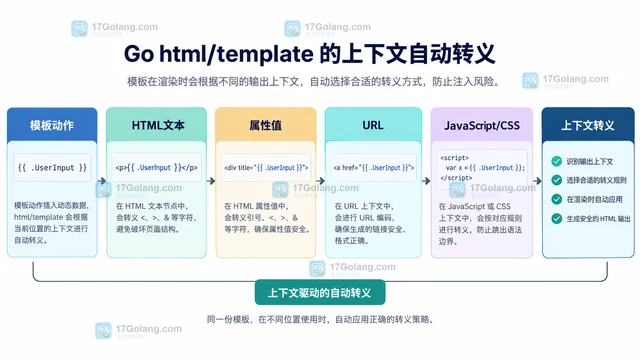 html/template 并不是简单地把所有字符串统一转义,而是根据插值所在的 HTML、属性、URL、JavaScript 或 CSS 上下文选择处理方式。本文用最小示例排查转义异常、ZgotmplZ 和安全类型误用。274 收藏
-
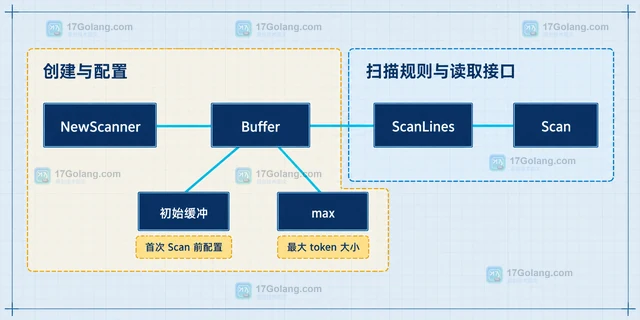 Go 使用 bufio.Scanner 读取超长行时,默认缓冲可能触发 token too long。本文说明如何在首次 Scan 前调用 Buffer 设置初始缓冲与最大 token,并梳理 Err 检查、内存边界和切换 bufio.Reader 的判断。364 收藏
-
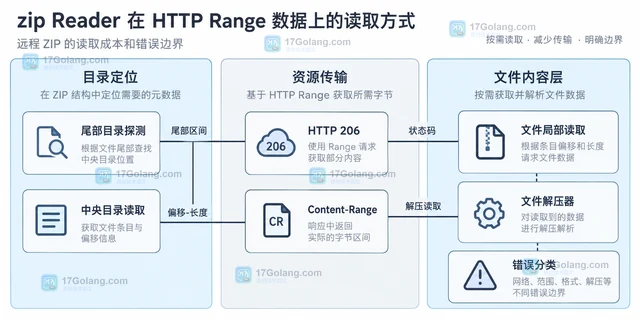 zip.NewReader 需要 io.ReaderAt 和压缩包总大小,HTTP 响应体却通常只能顺序读取。本文用 RangeReaderAt 把 HTTP Range 适配成随机读取,并说明 206、Content-Range、目录定位和错误边界。246 收藏
-
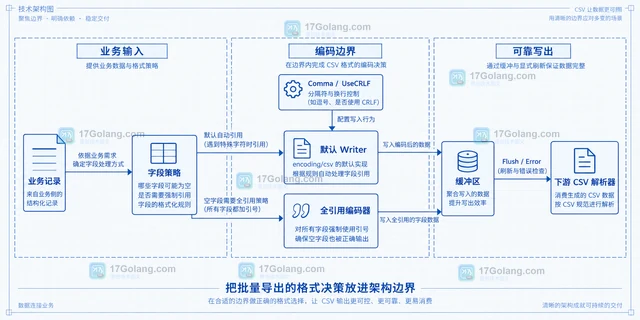 Go 的 encoding/csv Writer 会按字段内容自动决定是否加引号,但不会默认把空字符串写成双引号。本文解释 Comma、UseCRLF、Flush、Error 与全引用编码方案,解决批量导出时的格式兼容问题。112 收藏
-
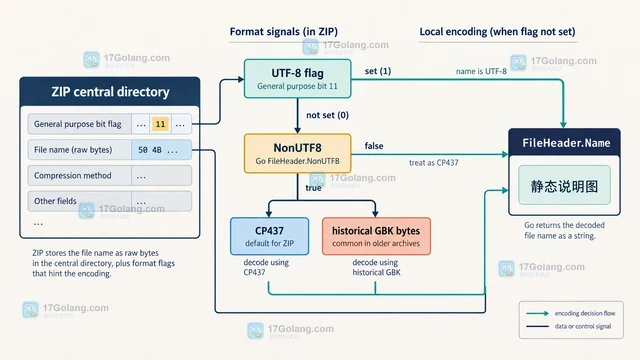 Go 使用 archive/zip 读取中文文件名异常时,先区分 UTF-8、CP437 和历史本地编码,再用显式解码与路径安全策略处理,避免把乱码或不可信路径直接落盘。476 收藏
-
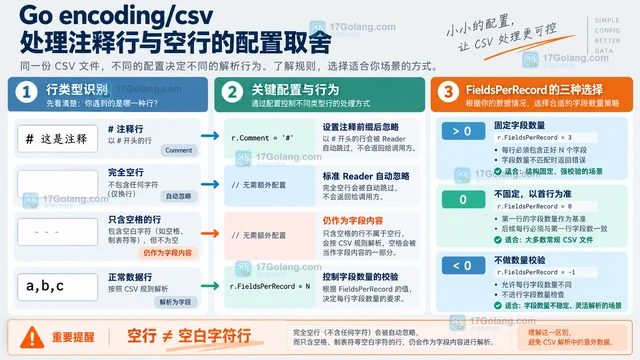 Go 的 encoding/csv 会自动忽略完全空行,但不会把只含空格的行当作空行。本文说明 Comment、TrimLeadingSpace 与 FieldsPerRecord 的取舍,并给出带错误处理的读取示例。401 收藏
-
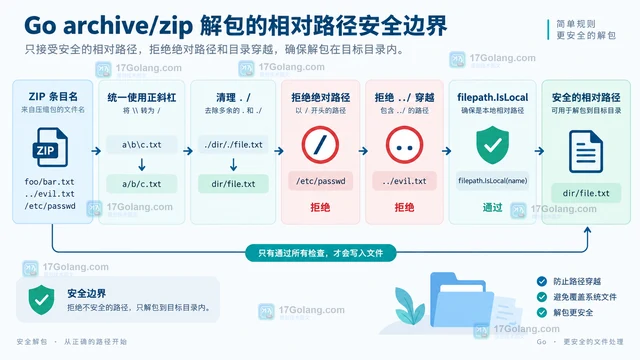 Go 使用 archive/zip 解包时,不能把 ZIP 条目名直接拼到目标目录。本文用相对路径校验、安全根目录映射和先校验后写盘的代码,处理绝对路径、../、反斜杠及 ErrInsecurePath,并说明符号链接和共享目录的额外边界。479 收藏
-
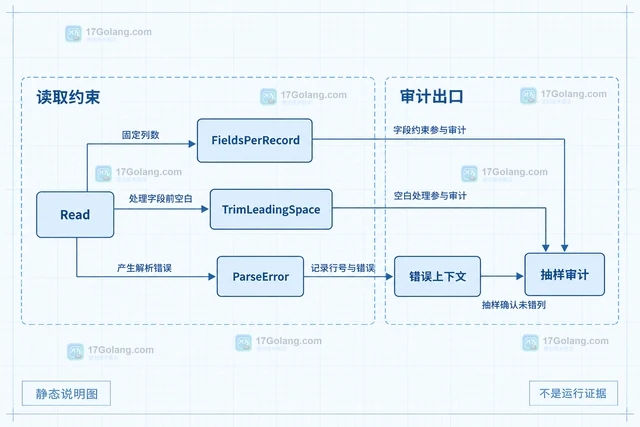 encoding/csv 遇到非标准引号时可以用 LazyQuotes 放宽读取,但应同时固定字段数、记录解析错误并保留抽样检查,避免把脏数据直接变成静默错列。425 收藏
-
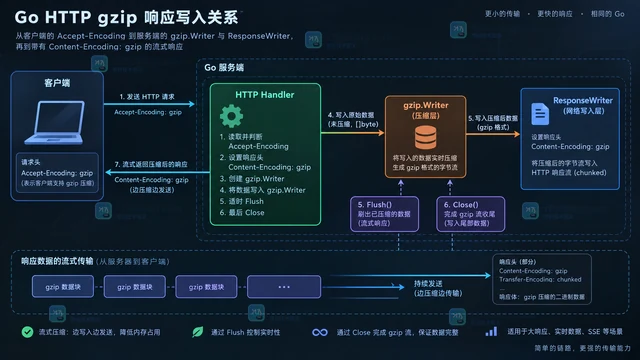 Go 的 gzip 压缩级别是在 CPU 消耗、响应体大小和端到端延迟之间做取舍。本文用 NewWriterLevel 比较级别,并给出 HTTP Handler 中的配置、Close、Flush 与 Writer 复用注意事项。136 收藏
-
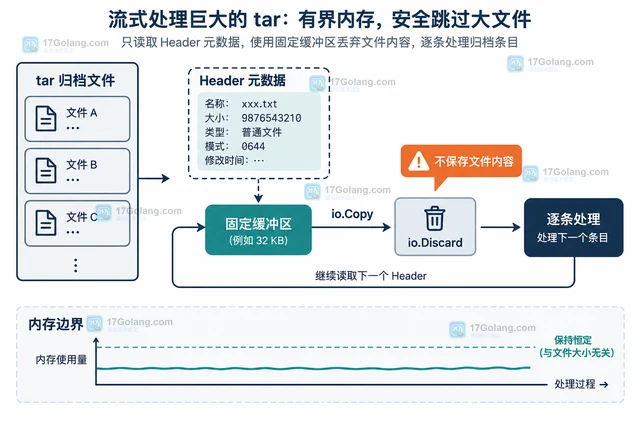 Go 的 archive/tar 适合流式读取归档。本文区分 Header 与 payload,演示只保留文件头元数据、用固定缓冲区消费内容,并说明超大条目和异常归档的内存控制边界。155 收藏
-
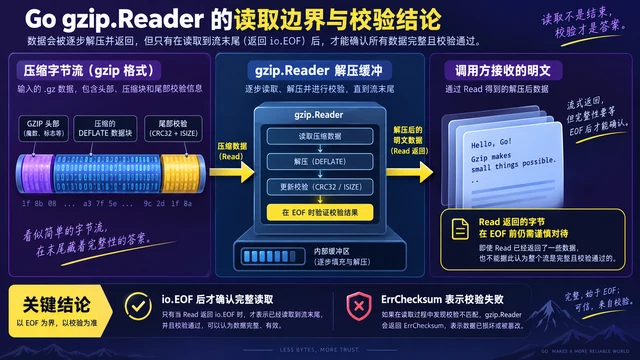 复用 gzip.Reader 时看到旧数据,通常不是 Reset 失效,而是把 Reader 内部状态、输入源位置和调用方输出缓冲混在了一起。本文用 Reset、EOF、ErrChecksum 与 Multistream 说明正确的复用边界。247 收藏