
Go语言技术文章
-
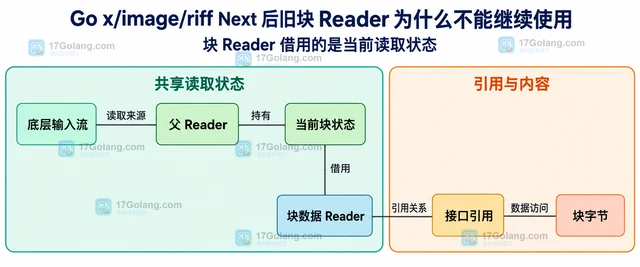 Go riff.Next 返回的块 Reader 会在下一次 Next 后失效。本文解释共享读取状态,给出带单块、总量和数量预算的数据复制函数,并说明并发与 LIST 嵌套读取的边界。490 收藏
-
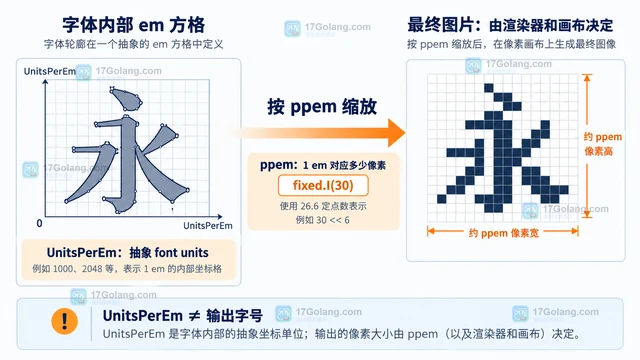 Go x/image/font/sfnt 的 UnitsPerEm 是字体内部的抽象单位数量,不是输出图片的字号。本文用 ppem、26.6 定点坐标、Metrics 与 GlyphBounds 拆开定位,让字号、字形边界和画布尺寸各自承担正确职责。242 收藏
-
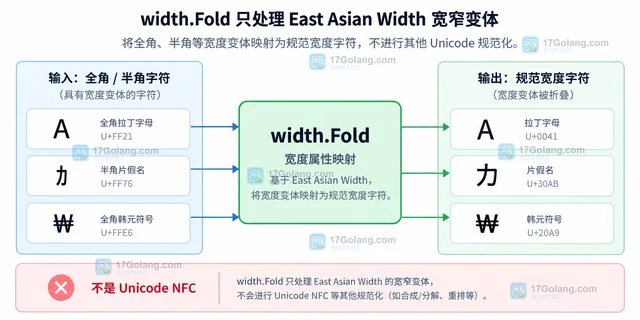 Go x/text/width 的 Fold 处理的是 East Asian Width 宽度变体,Unicode NFC 处理的是规范分解与组合。本文用全角字符、组合重音和 Go 代码说明两者的职责边界,并给出搜索键与原文存储的选择建议。181 收藏
-
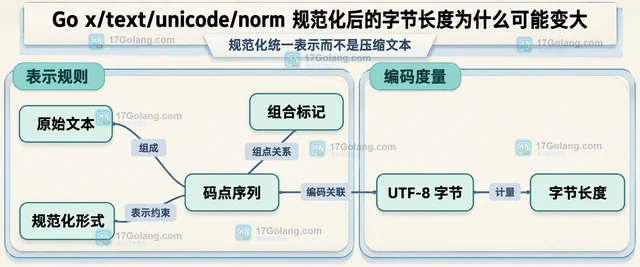 Unicode 规范化统一码点表示,不保证 UTF-8 字节数缩小。本文解释分解与组合排除导致的长度变化,给出 NFC 存储函数,并区分输入上限、结果上限和字符计量。232 收藏
-
 Go x/net/ipv4.PacketConn 将数据载荷、ControlMessage 与源地址分层返回。本文从 ReadFrom 和 WriteTo 的接口边界解释原因,并给出控制字段配置、接口选择和跨平台排查方法。420 收藏
-
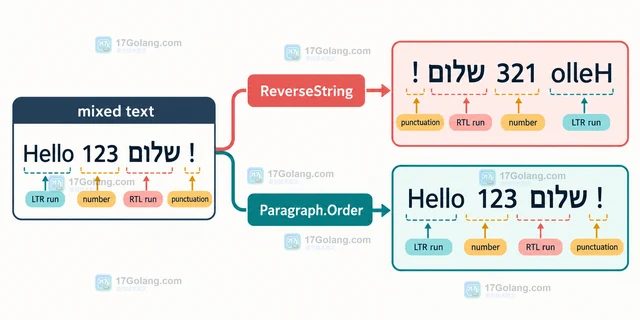
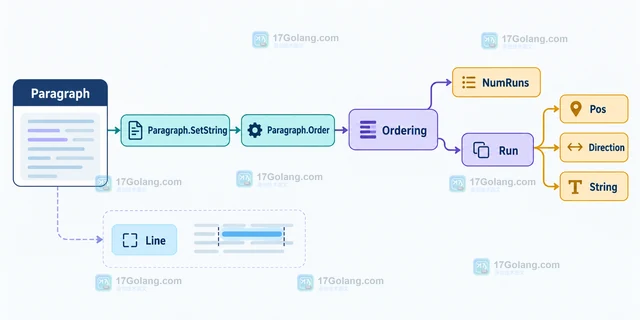 Go x/text/unicode/bidi 处理的是双向文本的段落与视觉 runs,不是把右向字符串从头到尾反过来。本文用混合文本说明 ReverseString 的边界,并给出 Paragraph.Order 与 Line 的排查写法。438 收藏
-
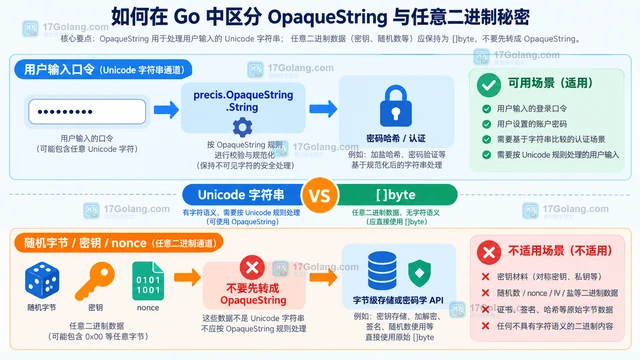 解释 Go x/text/secure/precis 的 OpaqueString 为什么面向 Unicode 口令字符串,而不是任意二进制秘密,并给出 Go 中的选型和错误处理方式。327 收藏
-
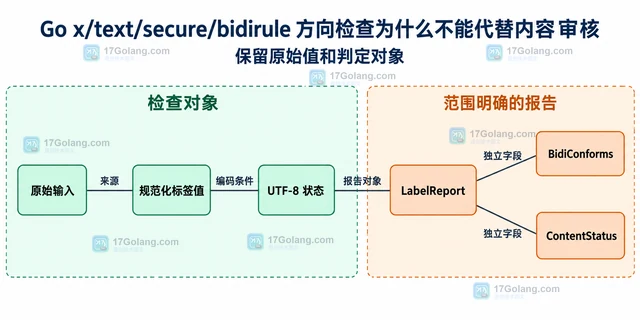 Go bidirule 检查 RFC 5893 方向规则,不判断文本语义或发布许可。本文给出独立检查报告示例,说明字段适用范围、状态设计和方向规则与内容策略的分工。390 收藏
-
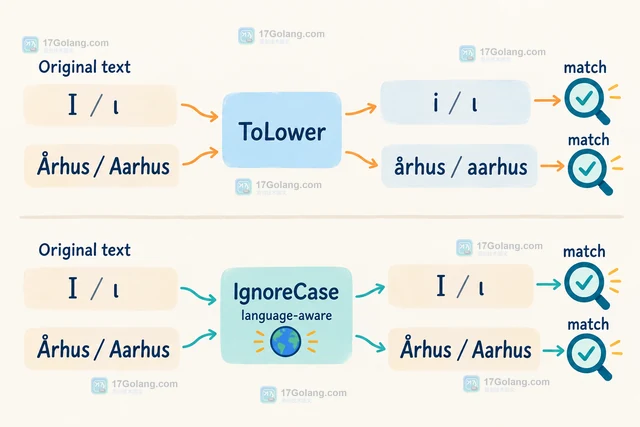 Go x/text/search 的 IgnoreCase 不是简单把两边字符串转成小写,而是保留原文并按语言规则完成大小写不敏感匹配。本文从一个小型搜索工具出发,说明它与 ToLower、Loose、Exact 的区别。439 收藏
-
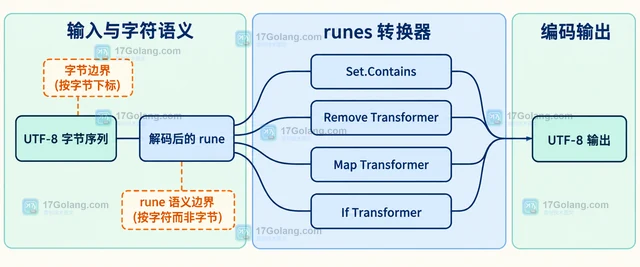 Go x/text/runes 处理的是 UTF-8 文本中的 rune,不是可以直接按字节下标切开的字符。本文从 Remove、Map、If 和 transform.String 的关系出发,说明字节索引、分块读取与非法 UTF-8 的边界。124 收藏
-
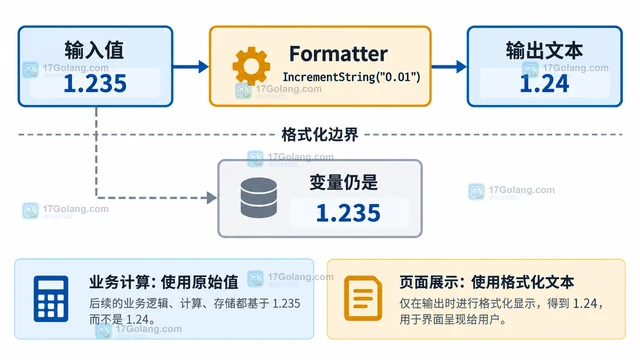 Go x/text/number 的 Scale 和 IncrementString 只改变数字的格式化结果,不会回写原始变量。本文用对照示例说明显示舍入、业务计算和输出边界应该怎样分开。365 收藏
-
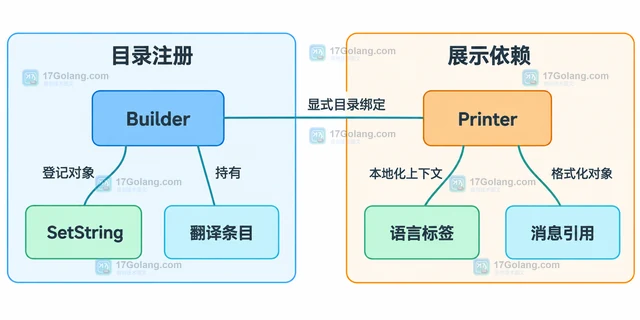 Go x/text/message 在缺少翻译时会格式化原文或备用文案。本文用独立目录示例说明 message.Key、目录绑定和语言选择,并比较原文键与稳定消息标识的维护方式。106 收藏
-
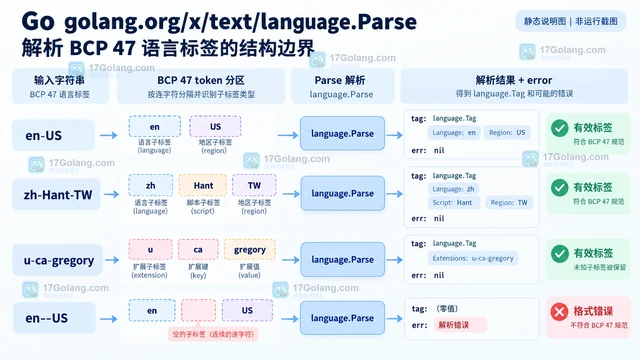 Go x/text/language.Parse 解析的是 BCP 47 语言标签,不是任意文本清洗器。本文区分格式错误、未知值和部分解析结果,说明 Parse、Make、MustParse 与 ParseAcceptLanguage 的选择边界。235 收藏
-
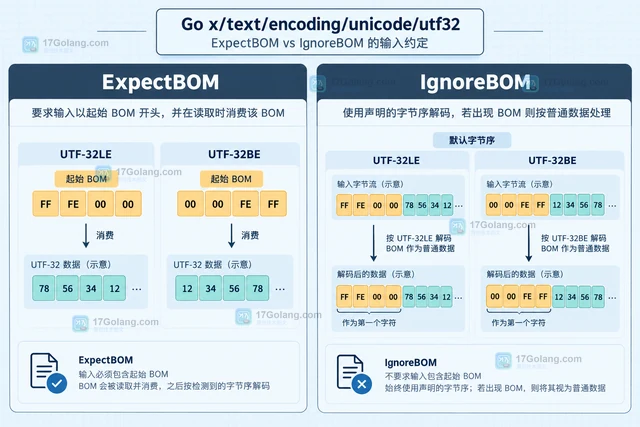 解释 Go x/text/encoding/unicode/utf32 中 ExpectBOM 与 IgnoreBOM 的解码、编码差异,给出缺失 BOM、字节序和 U+FEFF 输出的处理方法。332 收藏
-
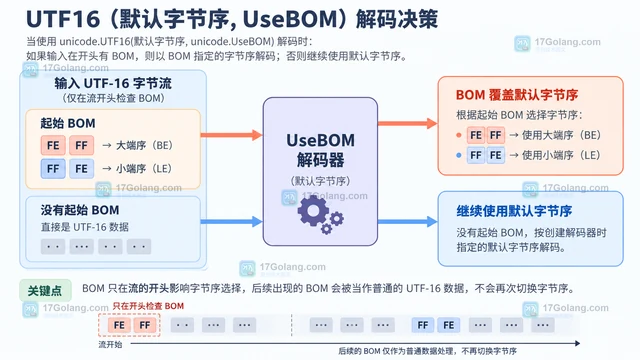 Go x/text/encoding/unicode 的 UseBOM 会在 UTF-16 输入带起始 BOM 时覆盖默认字节序,无 BOM 时再回退到默认值。本文用示例区分 UseBOM、ExpectBOM 和 IgnoreBOM。110 收藏