-
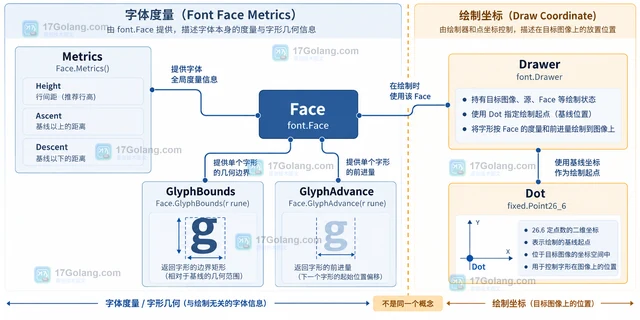
Go x/image/font/opentype 中 Size 是点值,DPI 是输出分辨率;两者共同决定 Face 的缩放比例。本文用源码关系、Metrics、GlyphBounds 和绘制坐标说明为什么字号不变时修改 DPI 会让字形变大,并给出参数选择策略。
-
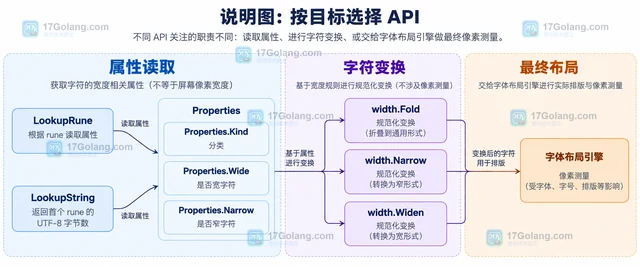
Go x/text/width 提供的是 Unicode 宽度属性分类,不是字体渲染后的屏幕像素测量。本文区分 width.Kind、rune、UTF-8 字节数和布局引擎,并给出按目标选择 API 的排查方法。
-
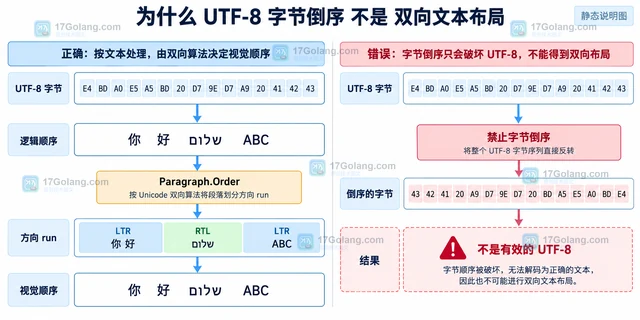
Go x/text/unicode/bidi 处理的是逻辑顺序到视觉顺序的双向文本布局,不是把 UTF-8 字节倒序。本文说明 Paragraph.Order、Ordering、Run 与 ReverseString 的职责边界,并给出混合方向文本的处理方式。
-
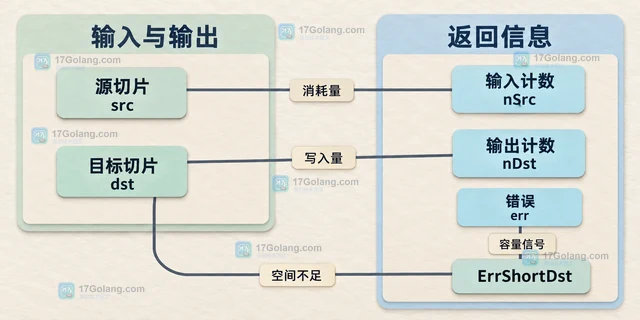
Go transform 的 ErrShortDst 表示输出空间不足。本文区分容量信号与输入校验,说明返回计数、连续状态及零进展处理,并给出完整转换函数。
-
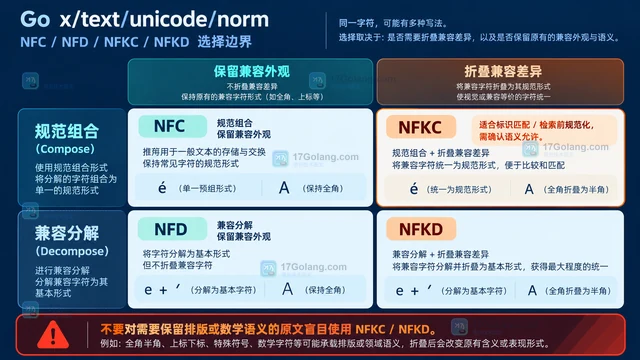
Go x/text/unicode/norm 的 NFKC 会先做兼容分解,再做规范组合,因此全角、带圈数字、上标和连字等字符可能改变外观。本文说明变化原因、Go 写法与不应使用 NFKC 的语义边界。
-
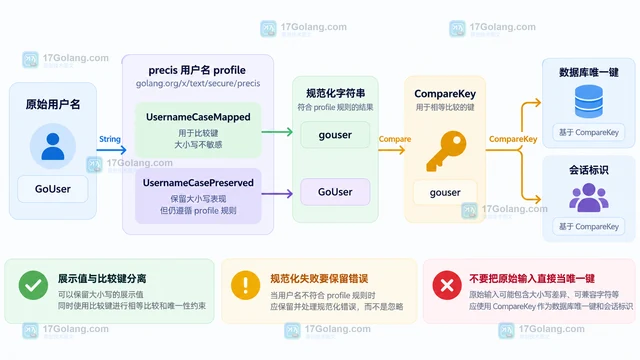
Go x/text/secure/precis 的用户名 profile 会按 PRECIS 规则完成字符串准备、强制和比较,因此输入字符可能被映射、折叠或因不允许而返回错误。本文说明 UsernameCaseMapped 与 UsernameCasePreserved 的区别,以及展示值、存储值和比较键如何分离。
-
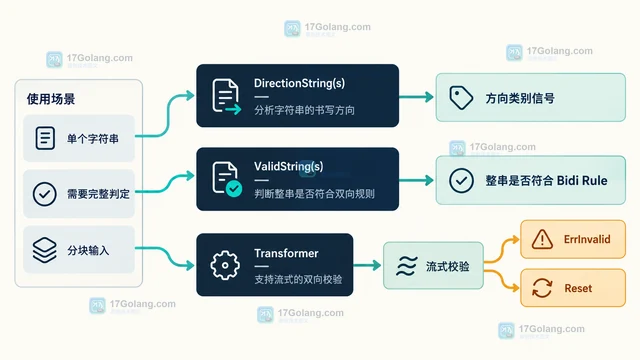
Go x/text/secure/bidirule 按 RFC 5893 实现双向文本规则。本文说明混合左右方向字符为何可能不合法,拆解 LTR/RTL 标签、EN/AN 数字冲突、末尾字符约束,并给出 ValidString 与 Transformer 的 Go 用法。
-
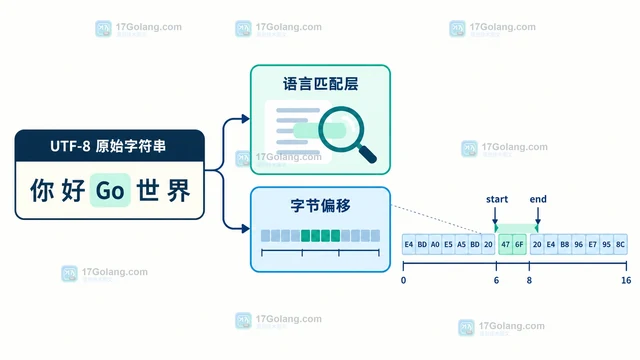
Go x/text/search 的匹配规则可以按语言处理大小写、重音和宽度,但 IndexString 返回的 start/end 仍应按原始 UTF-8 字节偏移使用。本文说明如何切取原文,并安全转换为 rune 下标。
-
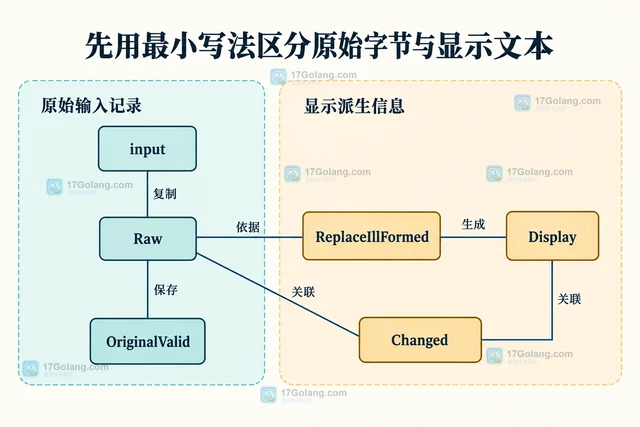
Go runes.ReplaceIllFormed 会将非法 UTF-8 字节替换为 U+FFFD。本文说明字节变化与无损解码的区别,给出原始副本和显示文本分离的示例,并解释批量与分块处理限制。
-
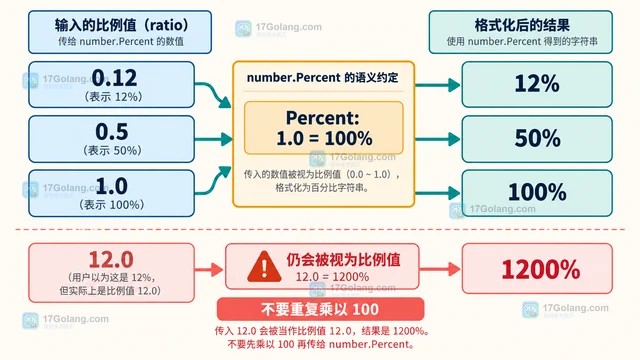
Go x/text/number 的 Percent 把 1.0 定义为 100%,所以 0.12 会显示为 12%。本文区分比例与百分数输入,说明语言环境、小数位选项和重复放大的排查边界。
-
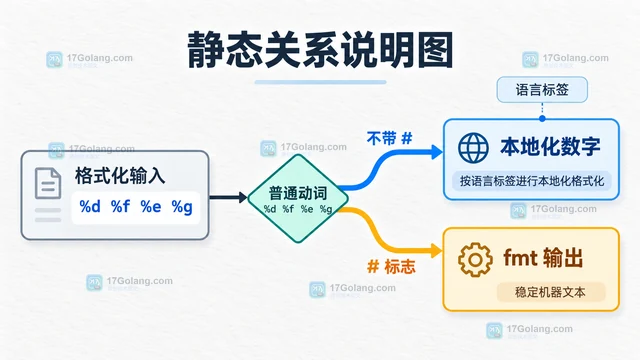
x/text/message 的 Sprintf 不是简单改名版 fmt.Sprintf:Printer 会按语言标签处理数字格式,格式串还可能作为翻译键。本文用最小 Go 示例说明差异、# 标志、Key 和回退边界。
-
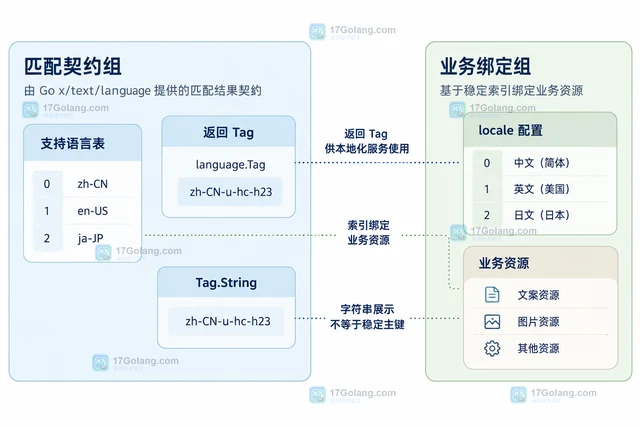
Go x/text/language 的 Matcher.Match 返回值可能带有 -u-rg- 等扩展字段,这是把用户地区设置带入匹配结果的设计。本文区分返回 Tag 与 index 的用途,并给出资源绑定示例。
-
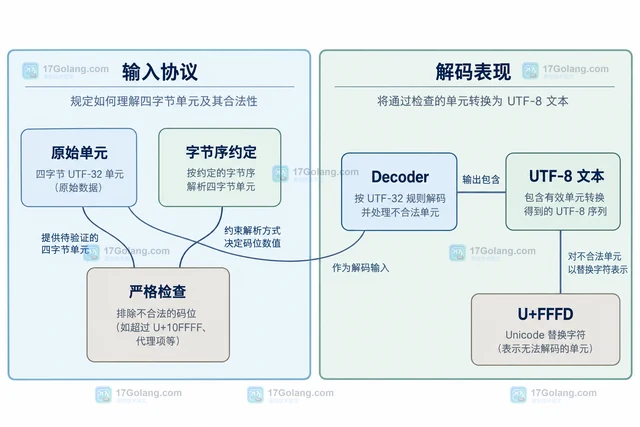
UTF-32 的四字节单元仍可能是代理项、超范围值或被错误字节序解释。本文给出固定小端的严格导入示例,说明默认解码替换行为、BOM 策略和失败偏移。
-
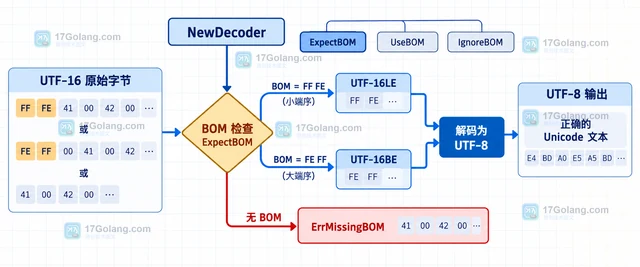
Go x/text/encoding/unicode 的 ExpectBOM 会要求 UTF-16 输入以 BOM 开始,没有签名的字节流会返回 ErrMissingBOM。本文对比三种 BOMPolicy,演示解码、编码和 transform.Reader 的正确使用边界。
-
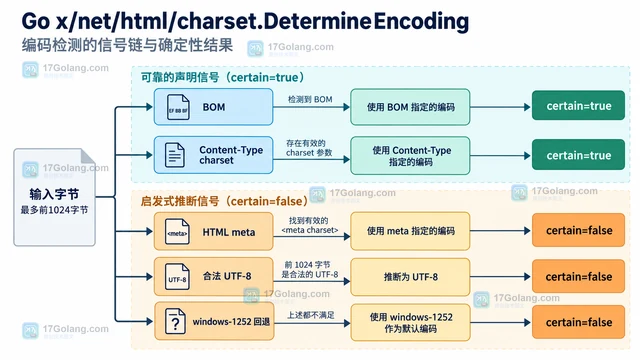
Go x/net/html/charset.DetermineEncoding 返回的 certain 不是“有没有识别出编码”,而是“结果是否来自可靠声明”。本文拆解 BOM、Content-Type、meta 扫描、UTF-8 推断与 windows-1252 回退的顺序,给出网页乱码排查时的使用方式。
