-
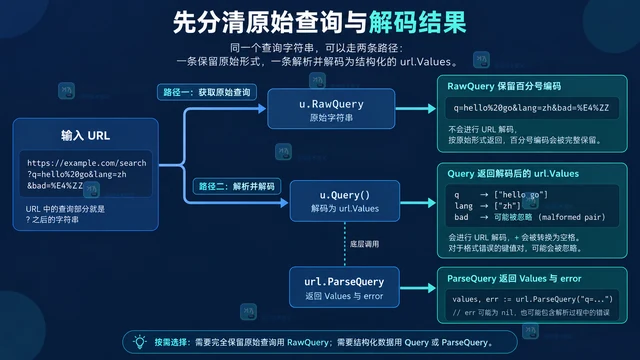
Go 的 URL 查询参数同时存在原始字符串和解码后的值。本文用 net/url 拆开 RawQuery、Query 与 ParseQuery 的差异,处理重复键、加号、分号和异常百分号,并给出适合签名、缓存、审计和业务筛选的选择方式。
-
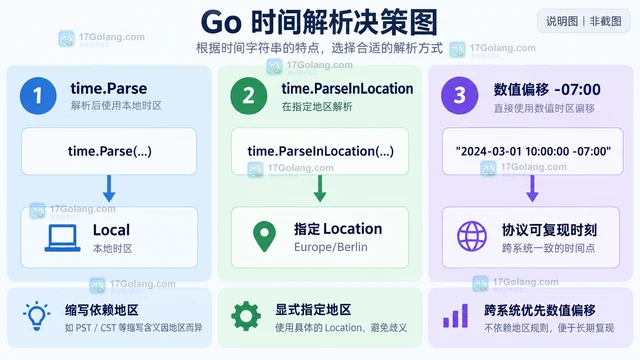
time.Parse 遇到 MST、CST、PST 等时区缩写时,会受 Local 和缩写是否已知影响。本文用 Zone、Location 和 ParseInLocation 拆开定位方法,并给出更稳定的数值偏移解析方案。
-
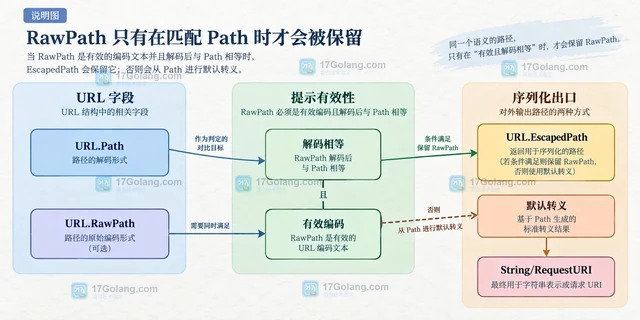
Go 的 net/url 会把路径解码后放入 Path,RawPath 只是可选的编码提示。本文用转义斜杠示例说明 EscapedPath 何时保留 RawPath,以及手动构造 URL 时如何避免提示失效。
-
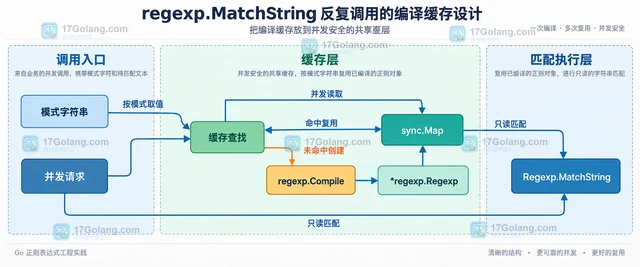
反复调用 regexp.MatchString 时,包级函数会把正则编译带进热路径。本文拆开调用链,给出固定模式与动态模式两种缓存设计,并处理并发、编译失败和容量边界。
-
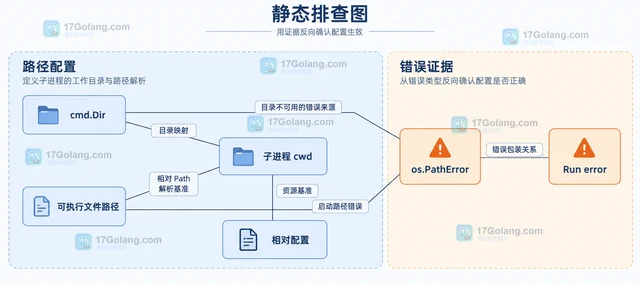
Go 用 os/exec 启动外部命令时,Cmd.Dir 可以固定子进程的工作目录,让命令稳定解析相对配置、输入和输出路径。本文从路径归属、相对可执行文件、Env/PWD 和启动错误几个证据入手,给出可直接改造的写法。
-
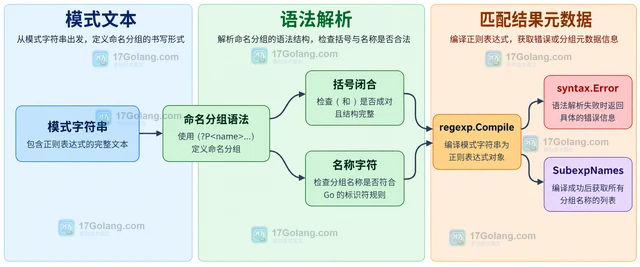
Go regexp 允许多个捕获分组使用同一个名称,真正的编译错误通常来自命名语法、括号闭合、转义或不支持的 Perl 扩展。本文用最小模式、syntax.Error 和 SubexpIndex 拆开排查路径,并给出生产代码中的命名策略。
-
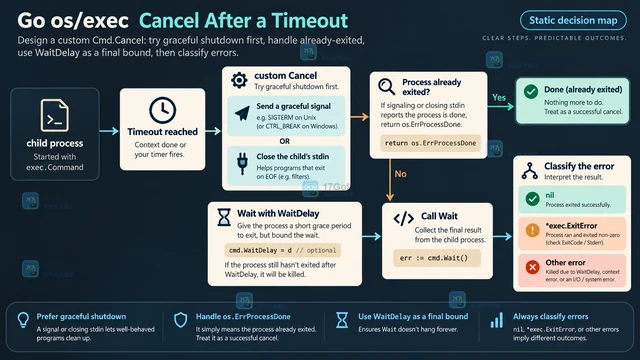
Go 的 exec.CommandContext 默认会在上下文超时后调用 Cmd.Cancel 并 Kill 子进程,但生产任务常需要更温和、可观测的退出策略。本文说明如何设计自定义 Cancel,处理 os.ErrProcessDone、WaitDelay、管道收尾和错误归因。
-
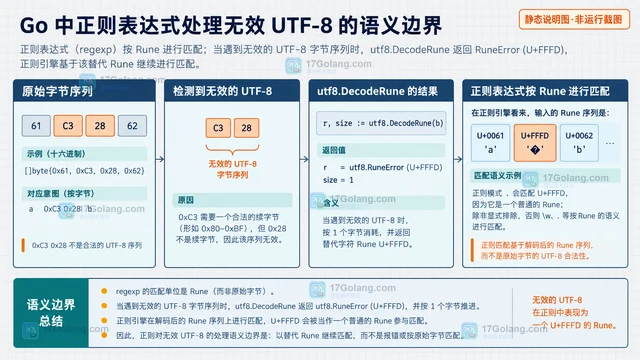
Go regexp 会把无效 UTF-8 输入中的异常字节按 utf8.RuneError 处理,而不是保留原始字节。本文对比先拒绝、规范化后匹配和改用 bytes 做字节级查找三种方案,帮助你按数据边界选对实现。
-
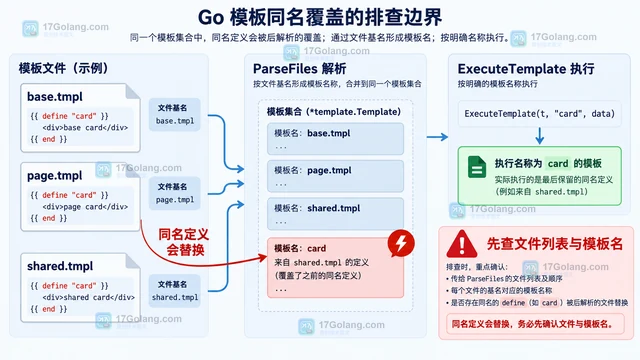
Go text/template 遇到嵌套 define 同名覆盖时,按关联模板、Parse 顺序、文件基名和 ExecuteTemplate 入口逐项定位,避免执行到错误定义。
-
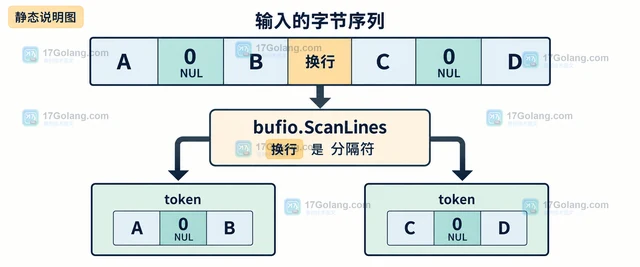
bufio.Scanner 默认按换行切分,输入中的零字节通常会作为普通字节保留。本文用小样例排查默认边界、自定义 NUL 分隔和超长 token 限制,并给出 Scanner 与 Reader 的选择建议。
-
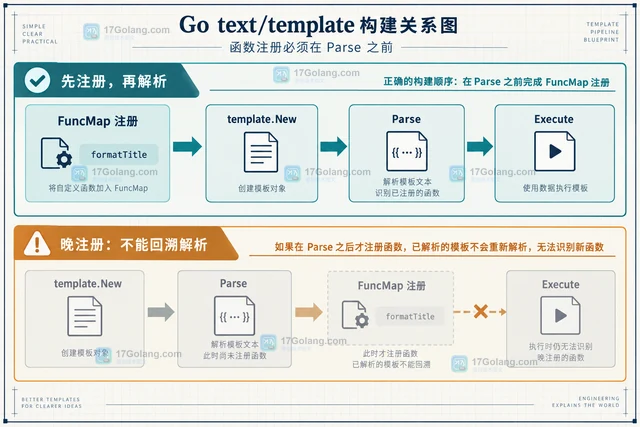
Go 的 text/template 报 function not defined 时,优先检查 FuncMap 是否在 Parse 前注册。本文用最小示例说明正确注册链、集中构造方式,以及解析后替换函数的边界。
-
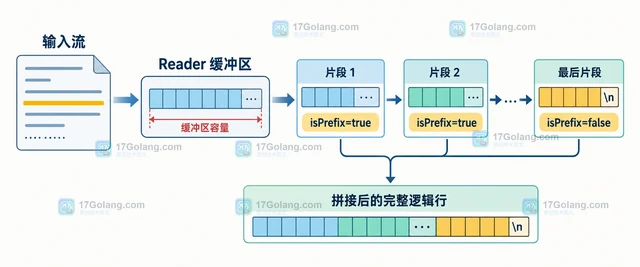
bufio.Reader.ReadLine 遇到超长文本时会通过 isPrefix 返回多个片段。本文用一个可复用的读取函数说明如何拼接软换行、处理 EOF 与错误,并解释返回切片的生命周期。
-
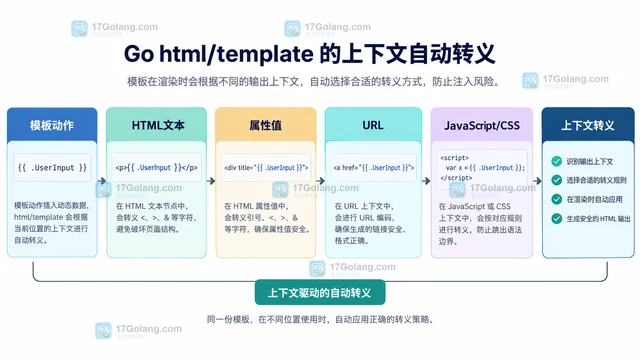
html/template 并不是简单地把所有字符串统一转义,而是根据插值所在的 HTML、属性、URL、JavaScript 或 CSS 上下文选择处理方式。本文用最小示例排查转义异常、ZgotmplZ 和安全类型误用。
-
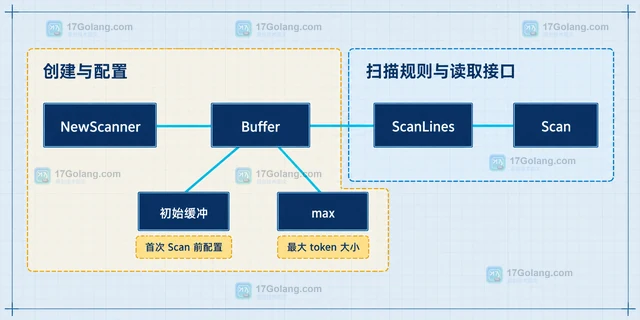
Go 使用 bufio.Scanner 读取超长行时,默认缓冲可能触发 token too long。本文说明如何在首次 Scan 前调用 Buffer 设置初始缓冲与最大 token,并梳理 Err 检查、内存边界和切换 bufio.Reader 的判断。
-
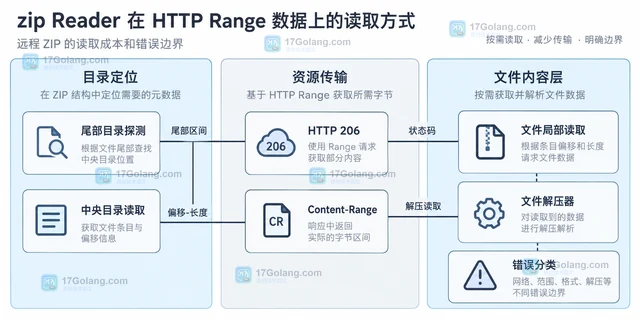
zip.NewReader 需要 io.ReaderAt 和压缩包总大小,HTTP 响应体却通常只能顺序读取。本文用 RangeReaderAt 把 HTTP Range 适配成随机读取,并说明 206、Content-Range、目录定位和错误边界。
