-
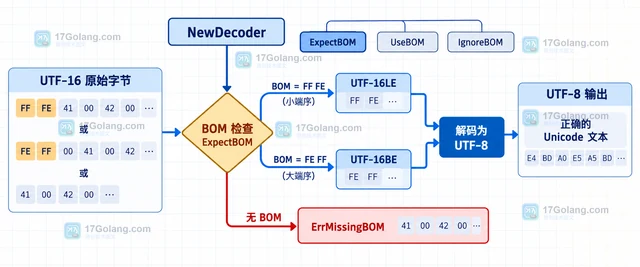
Go x/text/encoding/unicode 的 ExpectBOM 会要求 UTF-16 输入以 BOM 开始,没有签名的字节流会返回 ErrMissingBOM。本文对比三种 BOMPolicy,演示解码、编码和 transform.Reader 的正确使用边界。
-
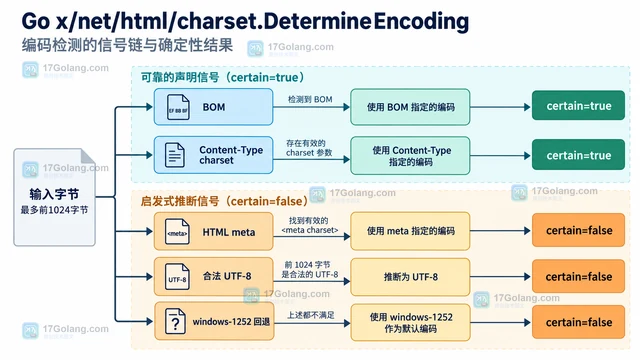
Go x/net/html/charset.DetermineEncoding 返回的 certain 不是“有没有识别出编码”,而是“结果是否来自可靠声明”。本文拆解 BOM、Content-Type、meta 扫描、UTF-8 推断与 windows-1252 回退的顺序,给出网页乱码排查时的使用方式。
-
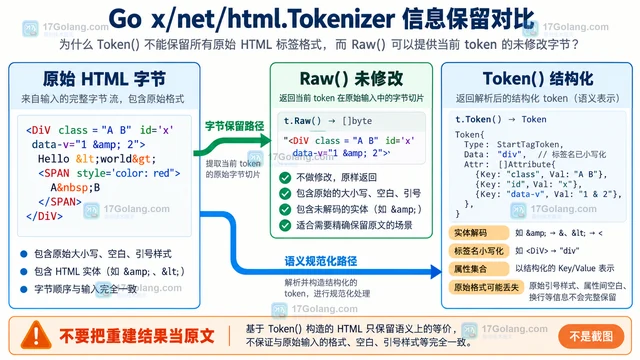
Go x/net/html.Tokenizer 的 Token 会把实体、标签名和属性转成结构化数据,因此不能当作原始 HTML 的无损副本。本文用 Raw、Token 和低级 API 对比保留边界,给出按 token 复制原始字节的写法。
-
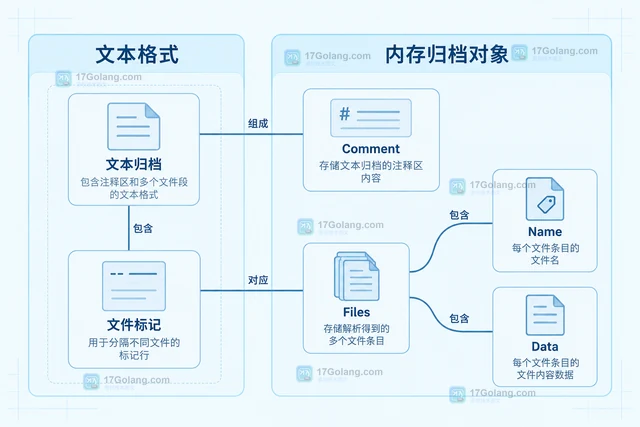
Go txtar.Parse 将注释区和文件段拆成 Archive。本文说明标记行、Files 顺序、末尾换行与输入切片引用,并给出保留独立存储的内存解析示例。
-
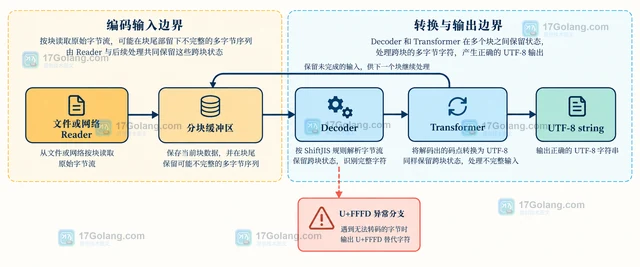
ShiftJIS 的字节边界不一定等于字符边界,逐字节调用 Go 解码器会让日文字符失去配对关系。本文说明 japanese.ShiftJIS 的 Decoder、transform.Bytes 和 Reader 应如何选择,并给出分块乱码与 U+FFFD 的排查方法。
-
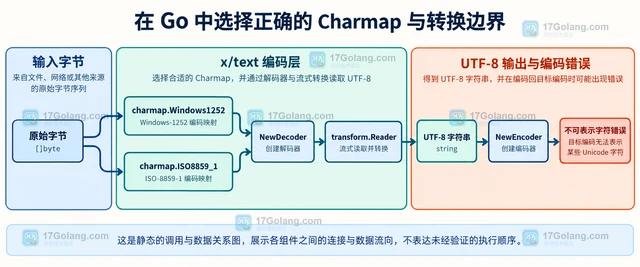
Windows1252 与 ISO8859_1 都是单字节编码,但 0x80–0x9F 区域的字符定义不同。本文用 Go x/text/encoding/charmap 对比解码、流式转换和反向编码,说明为什么不能只看字节宽度来选择编码。
-
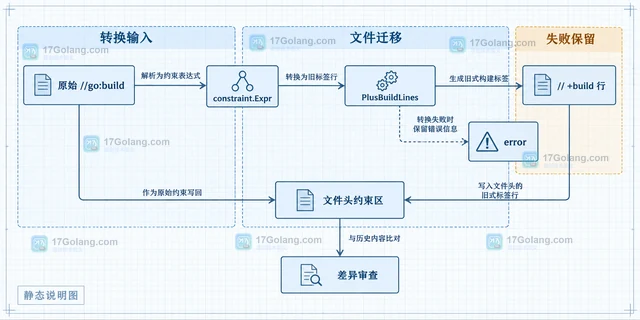
Go constraint.PlusBuildLines 可以把 constraint.Expr 转成一组等价的 // +build 旧标签行。本文说明 Parse、转换错误、复杂表达式边界以及写回源文件时的新旧约束同步方法。
-
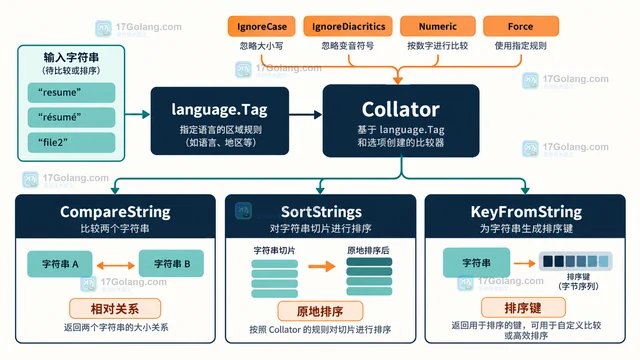
Go x/text/collate 的 CompareString 比较的是指定语言环境下的 Unicode 排序关系,不是字符串的 UTF-8 字节序。本文用最小示例说明 locale、返回值、比较选项和排序接入方式。
-
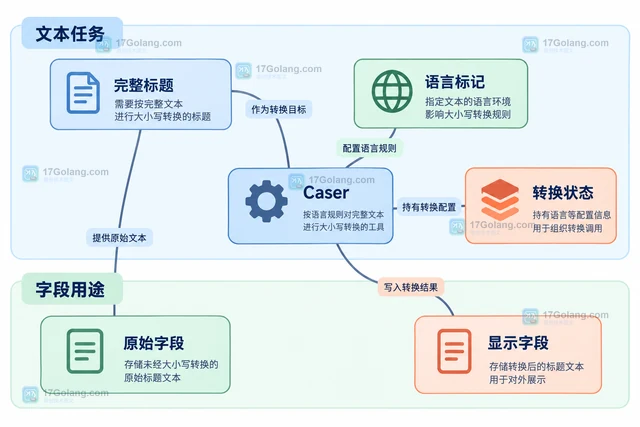
Go cases.Title 实现标题式大小写,不会将每个单词全部转成大写。本文比较 Title、NoLower 与 Upper,说明语言标记、单词边界、分块状态和显示字段的处理。
-
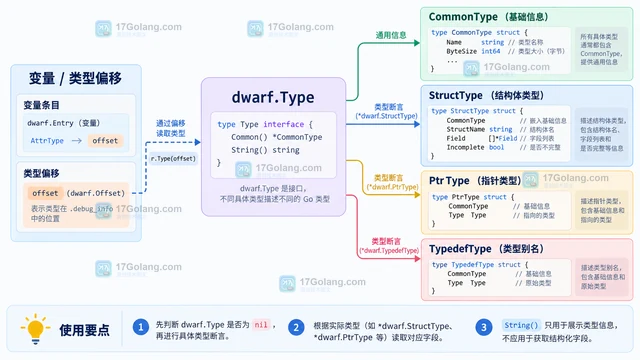
从 DWARF 条目的 AttrType 偏移调用 Go debug/dwarf Data.Type,读取 dwarf.Type 的通用描述,并按结构体、指针和类型别名读取具体字段。
-
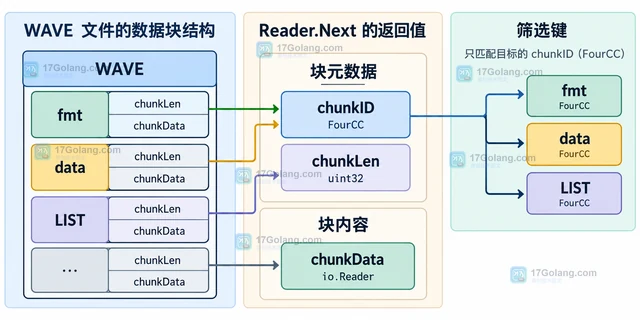
用 golang.org/x/image/riff 解析 WAVE 时,先判断 formType,再按 ChunkID/FourCC 筛选 fmt 和 data 块,并正确处理 chunkLen、chunkData 生命周期与未知块。
-
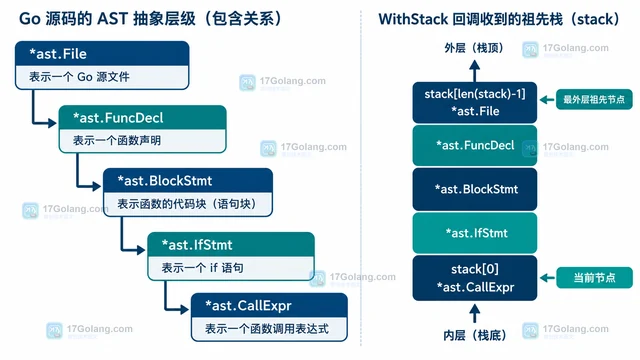
Go inspector.WithStack 会把当前 AST 遍历路径以 []ast.Node 传入回调,本文用一个完整示例说明 stack 的顺序、push/pop 语义、剪枝方式,以及为什么保存祖先链时要复制切片。
-
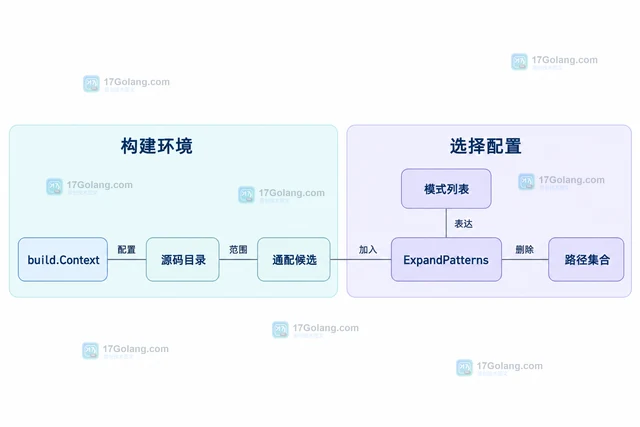
Go buildutil.ExpandPatterns 根据构建上下文展开包路径模式。本文给出集合转有序清单的写法,说明包含与排除的顺序、工作区范围,以及它与模块加载和构建验证的区别。
-
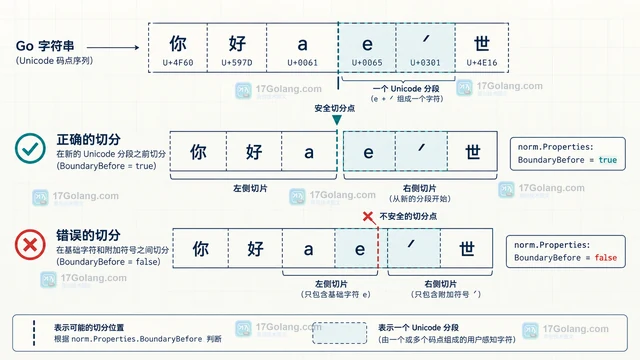
Go 的 norm.Properties(...).BoundaryBefore() 用来判断当前 rune 是否开启新的规范化片段。本文从单点判断讲到 NextBoundaryInString,说明如何在 UTF-8 分块输入中找到不会切断组合标记的安全位置。
-
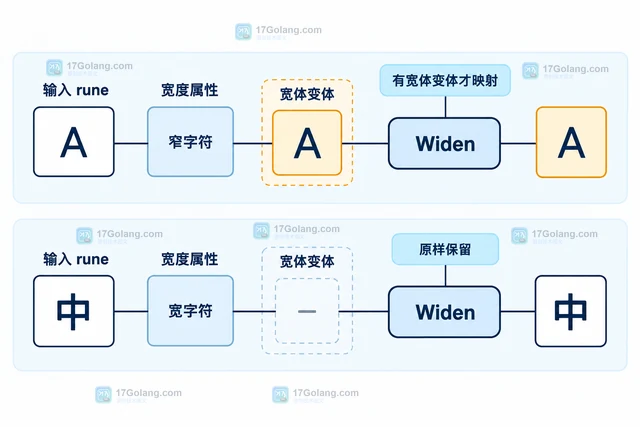
Go x/text/width 的 Widen 会把存在宽体变体的字符映射为宽字符,适合全角化处理。本文给出字符串与流式 Reader 两种写法,并说明未映射字符、Unicode 宽度类别和数据存储边界。
