-
Redis在高并发环境下的性能调优可以通过以下步骤实现:1.内存管理:使用maxmemory和maxmemory-policy配置,建议使用allkeys-lru策略。2.网络I/O优化:调整tcp-backlog和client-output-buffer-limit配置。3.持久化优化:调整rdb和aof的配置,平衡性能和数据安全。4.集群和分片:使用RedisCluster或Codis分散数据。5.客户端优化:使用连接池和批处理命令如pipeline或mget/mset。通过这些措施,可以确保Redi
-
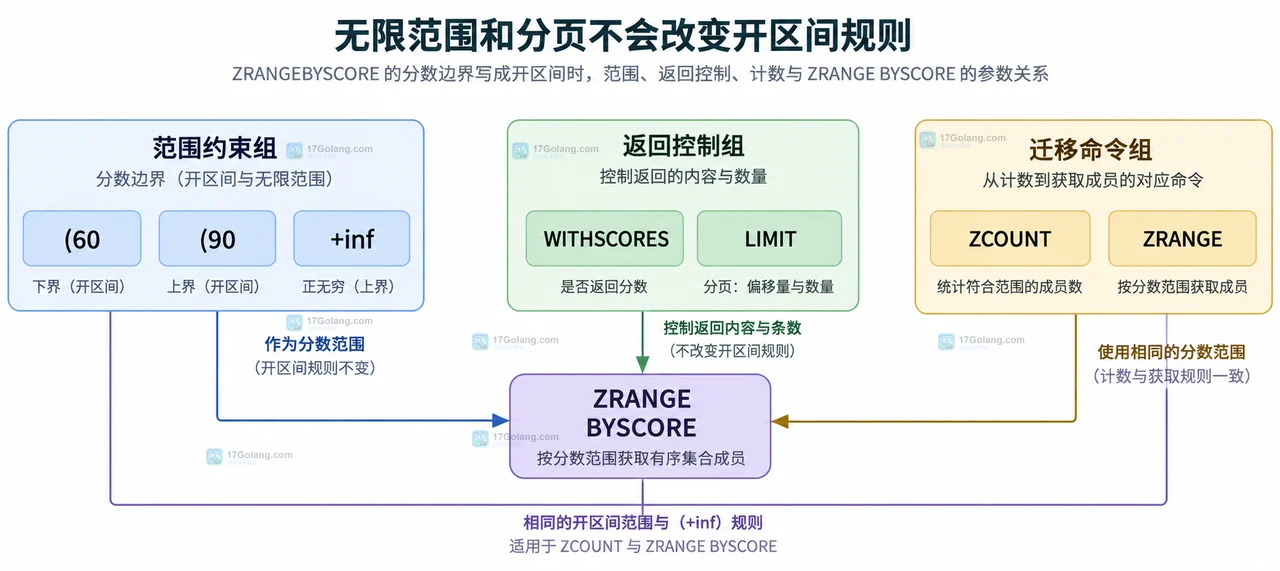
讲清 Redis ZRANGEBYSCORE 默认闭区间、括号开区间、无限范围、LIMIT 与 ZRANGE BYSCORE 迁移写法。
-
开启 ONLY_FULL_GROUP_BY 后,查询中的非聚合列必须出现在 GROUP BY 中,或能由分组列唯一确定。本文用主键、唯一键、单值过滤、ANY_VALUE 和派生表几个场景,说明如何改写查询并保持结果语义明确。
-
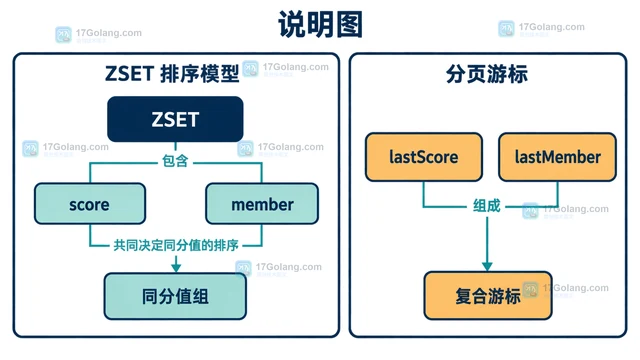
围绕 Redis ZSET 的 score 与 member 二级排序,说明如何用复合游标处理同分值成员、排他边界和分页期间的数据变化,避免稳定范围分页中的重复与遗漏。
-
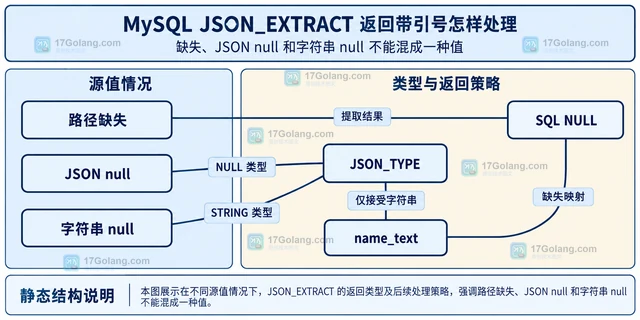
MySQL JSON_EXTRACT 返回 JSON 字符串,展示文本可用 JSON_UNQUOTE 或列的 ->> 写法。本文比较返回契约,给出原创只读查询,区分路径缺失、JSON null 与字符串 null,并说明序列化边界。
-

现在有3KW的数据,单条数据都很小的,如果按key-value来看的话,key就是32位的MD5字符串,value按平均算大概是100字节左右。
现在需要将这些数据做缓存以在高并发的时候依然可以快速响应。
因为
-
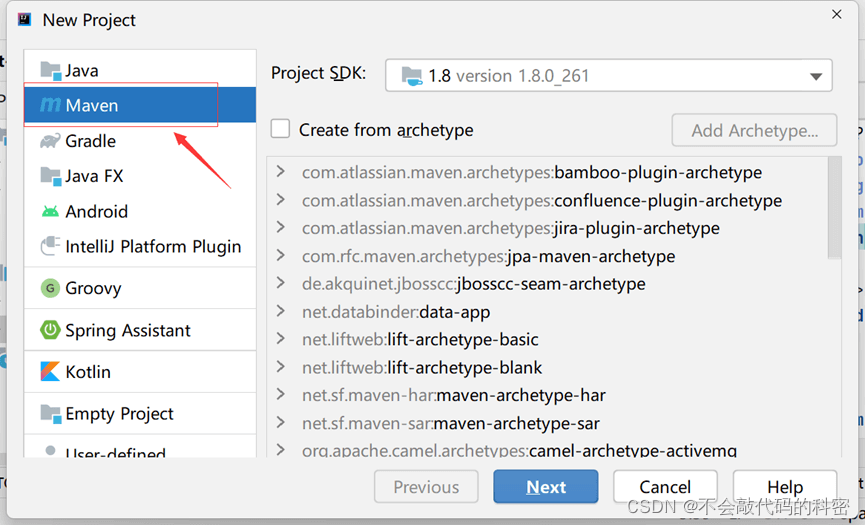
JDBC概述
Java数据库连接,(Java Database Connectivity,简称JDBC)是Java语言中用来规范客户端程序如何来访问数据库的应用程序接口,提供了诸如查询和更新数据库中数据的方法。
IDEA下创建JDBC环境
-

Hi 小伙伴们大家好,因为Mac每次升级都会搬迁我的拓展库,最后都要手动再去搞一次环境,其次每个coder本质都是懒人,所以准备试试docker,看是否能一劳永逸的解决这个问题。安装php:首先先
-
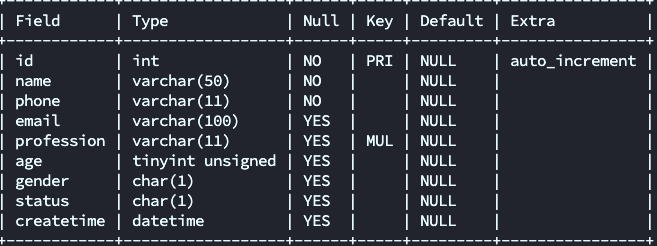
今天来看看MySQL 中如何多Group By 语句进行优化的。
先创建tb_user 表如下:
通过show index from tb_user; 命令查看表,没有存在任何的索引。
执行如下代码,查看SQL 执行情况
explain select profession, count
-

1.数据准备
#1.建立员工表,并创建name,age,position索引,id为自增主键
CREATE TABLE `employees` (
`id` int(11) NOT NULL AUTO_INCREMENT,
`name` varchar(24) NOT NULL DEFAULT '' COMMENT '姓名',
`age` int(11) NOT NULL DEFAULT '0'
-
本文将通过一个 用户账户金额更新的案例 分析几种数据更新的操作的优劣。希望对大家有帮助 🐶。
数据库版本 : mysql 5.7.23
案例分析
创建数据库的DDL:
CREATE TABLE `hw_account` (
`id` int(11
-
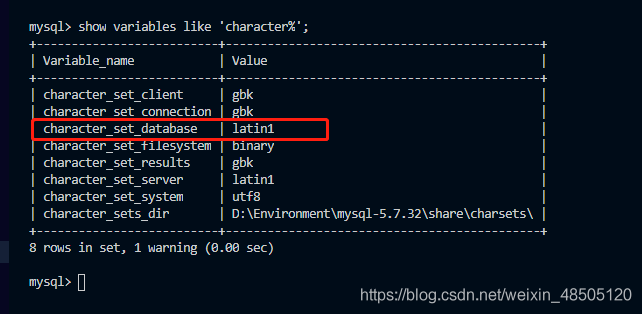
我们首先看一下MySQL官方文档:5.7
CREATE {DATABASE | SCHEMA} [IF NOT EXISTS] db_name
[create_option] ...
create_option: [DEFAULT] {
CHARACTER SET [=] charset_name
| COLLATE [=] collation_name
}
通过查看mysql服务器的变量我们
-
在前面文章中,有提到过 mysqldump 备份文件中记录的时间戳数据都是以 UTC 时区为基础的,在筛选恢复单库或单表时要注意时区差别。后来再次查看文档,发现 tz-utc、skip-tz-utc 参数与此有关,本
-
什么是大事务
运行时间比较长,长时间未提交的事务就可以称为大事务
大事务产生的原因
操作的数据比较多
大量的锁竞争
事务中有其他非DB的耗时操作
。。。
大事务造成的影响
-
select语句完整语法:
SELECT
DISTINCT <select_list>
FROM <left_table>
<join_type> JOIN <right_table>
ON <join_condition>
WHERE <where_condition>
GROUP BY <group_by_list>
HAVING <having_condition>
O
