-
Redis在高并发环境下的性能调优可以通过以下步骤实现:1.内存管理:使用maxmemory和maxmemory-policy配置,建议使用allkeys-lru策略。2.网络I/O优化:调整tcp-backlog和client-output-buffer-limit配置。3.持久化优化:调整rdb和aof的配置,平衡性能和数据安全。4.集群和分片:使用RedisCluster或Codis分散数据。5.客户端优化:使用连接池和批处理命令如pipeline或mget/mset。通过这些措施,可以确保Redi
-

MySQL视图是虚拟表,不存储实际数据,基于真实表查询结果。1.优点:简化复杂查询,将多表JOIN封装为视图方便调用;2.安全性:控制访问权限,隐藏敏感字段;3.缺点:性能可能受影响,尤其嵌套视图或复杂逻辑时;4.更新限制:含聚合函数、DISTINCT、GROUPBY或多表连接的视图不可更新。使用视图可提升开发效率并保障数据安全,但也需注意其性能和更新限制问题。
-

SQL查询流程始于连接器验证身份和权限,2.MySQL8.0前通过查询缓存判断是否命中结果,3.解析器进行词法语法分析生成解析树,4.预处理器校验对象存在性与权限并处理别名,5.优化器基于成本选择最优执行计划,6.执行器检查权限并调用存储引擎读取数据,7.存储引擎通过索引结构从内存或磁盘加载数据,8.最终结果逐行返回客户端并释放资源。
-
redis-cli--clusterfix并非万能修复器,仅解决Slot被多节点声明的明确冲突,对Slot丢失、元数据错乱、nodes.conf未刷新等问题无效;它只比对并修正冲突项,不处理“看似合理实则失效”的条目。
-
SpringBoot中@Cacheable不支持动态过期时间,因SpringCache抽象层仅支持全局TTL配置;需通过RedisTemplate手动设expire、多CacheManager配置或自定义RedisCacheWriter实现差异化TTL。
-
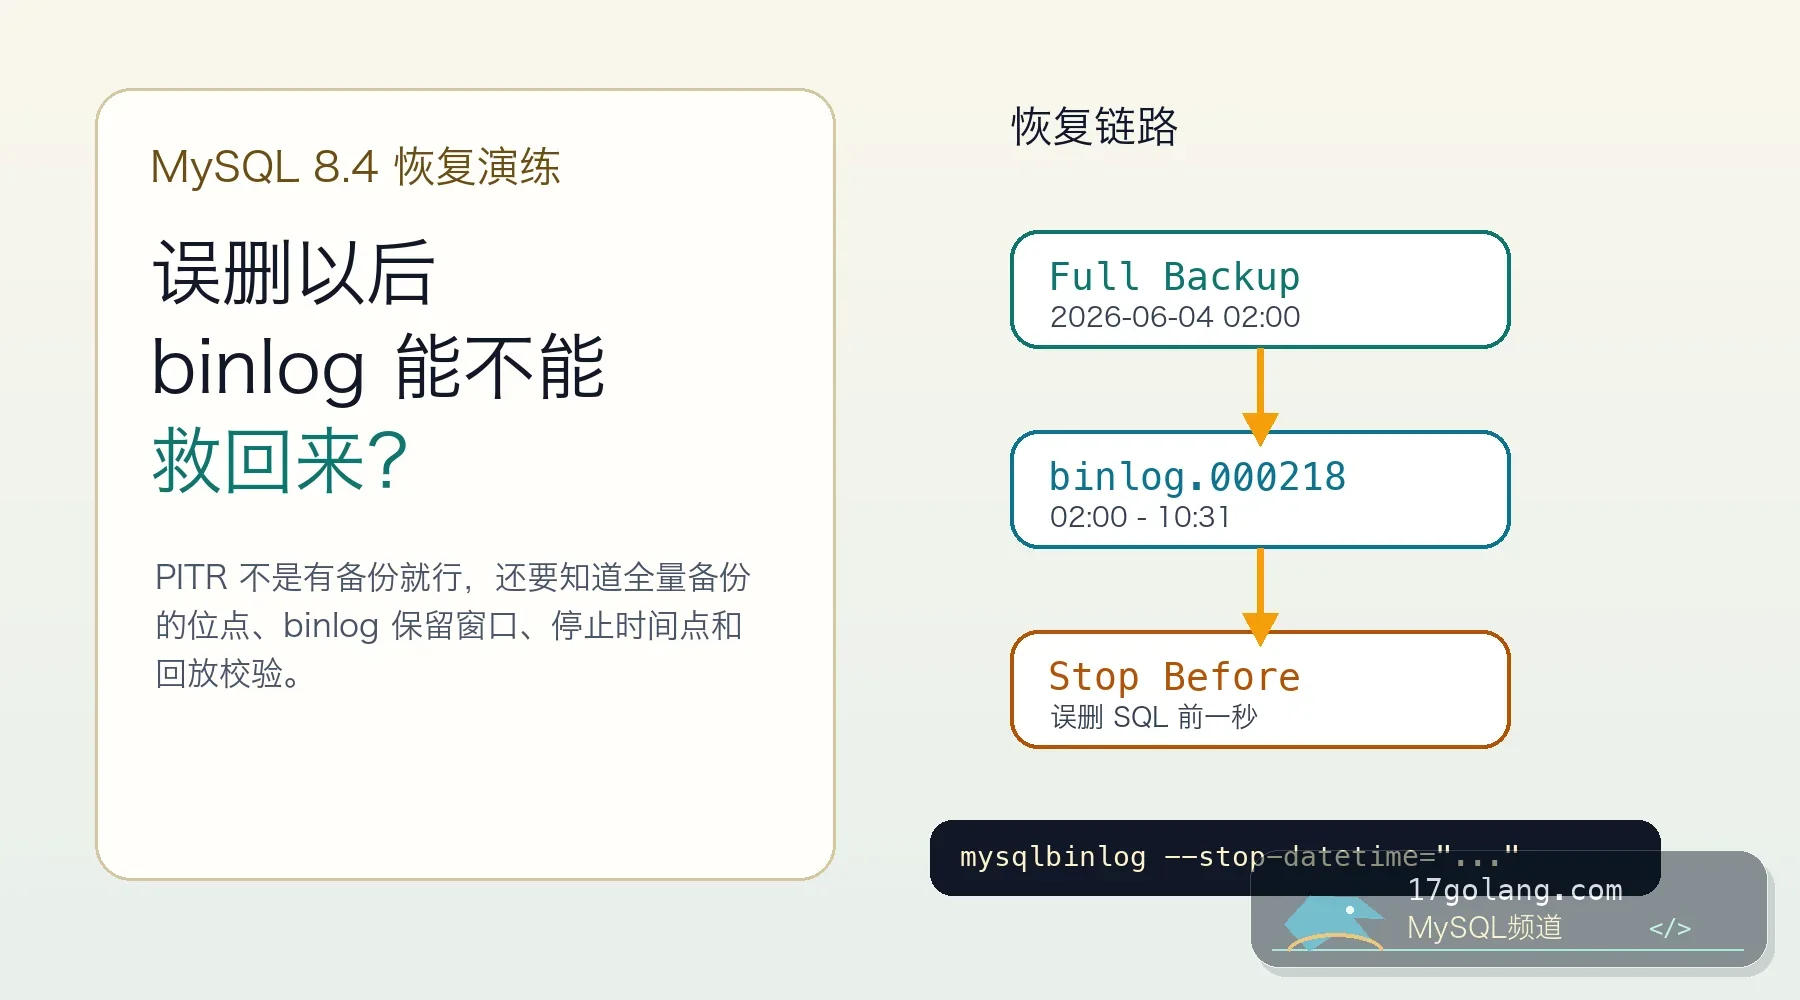
从误删订单数据的恢复演练切入,讲清 MySQL 8.x 完整备份、binlog 保留、mysqlbinlog 按时间点/位置回放、校验与上线检查。
-

Redis HyperLogLog 适合用很小的内存估算独立访客数,但它不是精确集合,不能拿来判断某个用户是否已经领取过权益。本文从 PFADD、PFCOUNT、PFMERGE 的实际结果出发,说明误差边界、按天拆分 key 的做法和精确去重的替代方案。
-
自关联子查询并不适宜用于查找连续记录。这是因为它高度依赖于ON条件来匹配“前一天”的数据,但在实际应用中,这很容易引发诸多问题。例如,当日期字段包含时分秒信息时,如'2026-04-01 14:22:03',减一天后变为'2026-03-31 14:22:03',这种情况下几乎难以匹配到另一条记录,
-
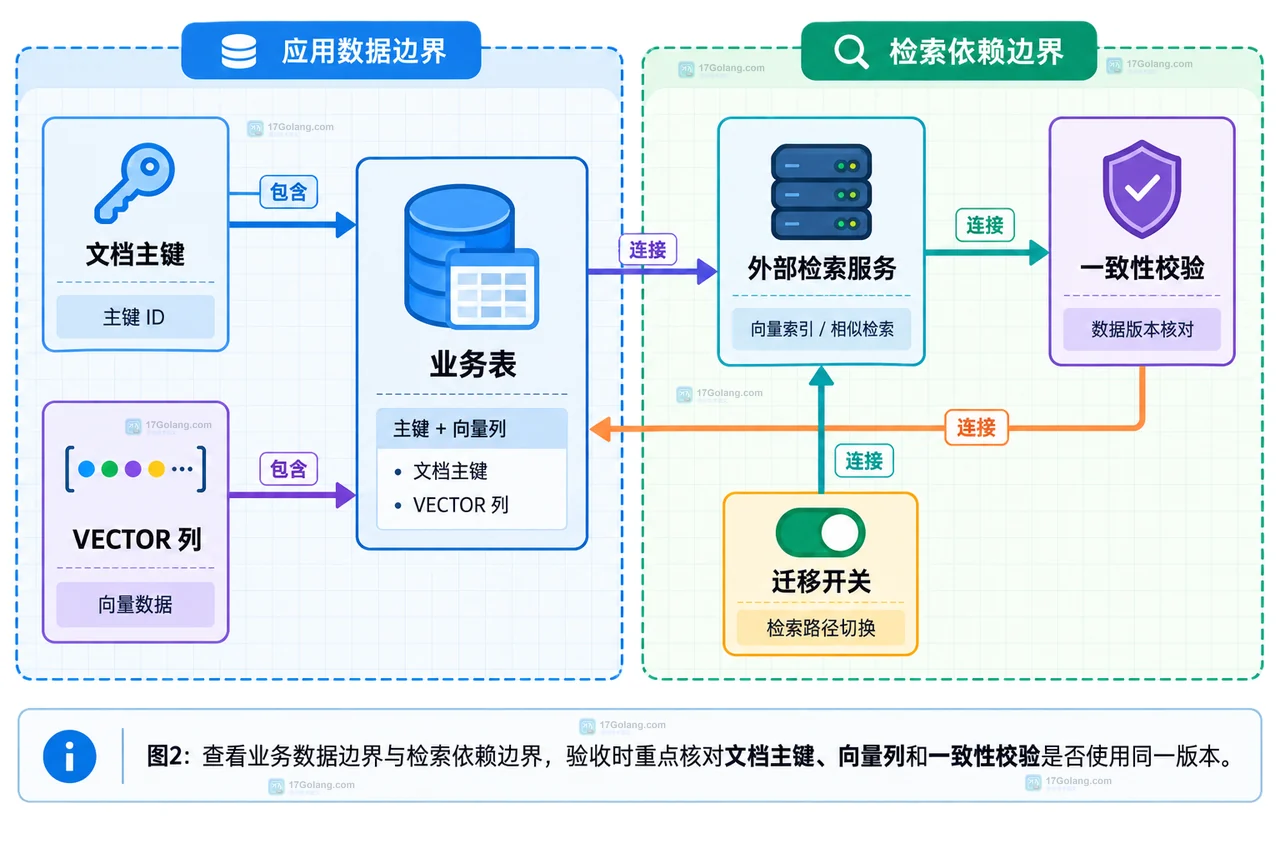
MySQL 9.7 的 VECTOR 列能保存向量,但原生向量索引和相似度检索仍在官方架构讨论中。本文拆开 InnoDB 二级索引、隐藏子表、事务一致性和当前落地边界,给出应用侧的稳妥接法。
-
判断 MySQL 列选择性是否真的变差,不能只看直方图;应结合实际过滤比例、EXPLAIN ANALYZE 的估算与实际行数,以及索引 CARDINALITY 和统计更新时间综合确认。
-
通过显式字段映射、用户变量和 IGNORE 处理 MySQL LOAD DATA 的脏行,并立即保存 Records、Skipped、Warnings 与 SHOW WARNINGS 明细。
-
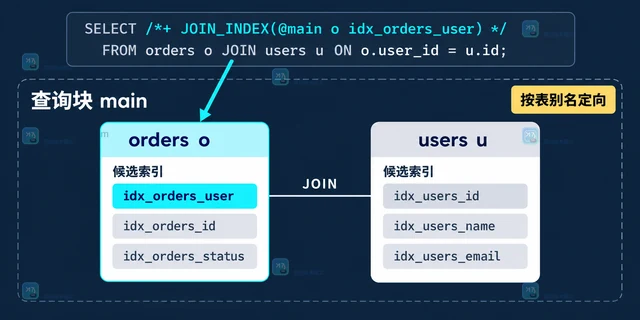
MySQL 多表 JOIN 中只想约束一张表时,应使用表别名限定 JOIN_INDEX 或 NO_JOIN_INDEX,并在嵌套查询中用 QB_NAME 明确作用域,最后通过 EXPLAIN 对比 key、访问类型和 rows。
-
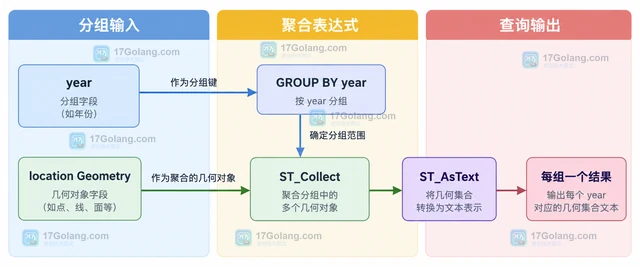
MySQL ST_Collect 可以把同一分组中的几何值聚合为一个 Multi 几何或 GeometryCollection。本文给出按业务字段分组的写法,并说明 DISTINCT、NULL、SRS 和空间融合边界。
-
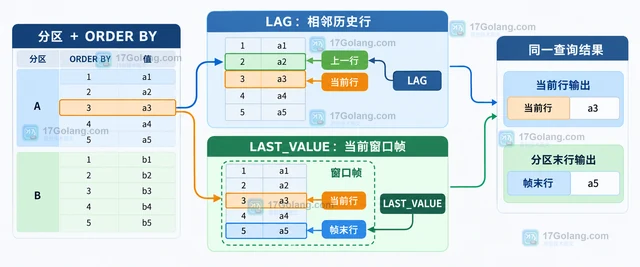
MySQL LAG 按分区排序取前序行,LAST_VALUE 取当前窗口帧末行。本文用账户流水说明默认 RANGE 帧、显式全分区帧、ROWS 与重复排序值的边界,并给出选择上一条、分区末值和最大值的 SQL 写法。
-

一.首先从数据库data目录下将对应数据库文件夹下的frm文件提取表结构创建sql语句通过工具mysqlfrm提取。安装如下:依次执行以下命令cd /usr/local/src/wget https://downloads.mysql.com/a...tar -zxvf mysql-utilities
