-

MySQL建表的完整步骤包括:1)设计阶段,明确表的目的和数据需求,选择合适的数据类型;2)实现阶段,执行CREATETABLE语句,设置索引;3)优化阶段,考虑表的规范化、分区和分表。这些步骤确保了数据库的效率和可维护性。
-
主键和唯一键在MySQL中均用于保证数据唯一性,但存在关键区别。主键必须唯一且非空,每个表仅能有一个主键,并自动创建聚集索引;而唯一键允许NULL值,一个表可有多个唯一键,通常创建非聚集索引。1.主键用于唯一标识记录,不能为空,适合使用自增整数或稳定无业务意义的字段;2.唯一键用于确保字段唯一性,允许空值,适用于用户名、邮箱等场景;3.主键影响数据存储结构,查询效率更高,而唯一键作为二级索引,查询需回表,性能略差。选择时应优先考虑主键的稳定性与简洁性,避免使用易变或复杂格式的字段。
-
Redis因系统崩溃后的重启和数据恢复可以通过以下步骤实现:1)理解Redis的RDB和AOF持久化机制,根据业务需求选择合适的方式;2)使用redis-check-aof工具修复损坏的AOF文件;3)检查并调整redis.conf文件中的持久化设置;4)对于Redis集群,先移除崩溃节点,重启并恢复数据后再重新加入集群;5)定期使用bgsave命令备份数据,确保数据安全。通过这些步骤,可以有效地重启Redis并恢复数据,保障系统的连续性和数据的安全性。
-
要设置MySQL性能监控,首先启用慢查询日志,在配置文件中设置slow_query_log、slow_query_log_file和long_query_time;其次使用SHOWSTATUS和SHOWPROCESSLIST实时查看数据库状态;最后引入第三方工具如Prometheus+Grafana或PMM进行可视化监控。核心指标包括:1.查询性能(QPS、慢查询数量、缓冲池命中率);2.资源使用(CPU、内存、磁盘IO);3.连接与线程状态(连接数、Threads_running);4.锁与事务问题(表
-

在MySQL中,AS关键字的作用是为表或列创建别名。1)别名简化复杂查询,使其更易读和理解;2)在某些情况下提高查询性能;3)使用时需注意在ORDERBY或GROUPBY中使用原始列名,除非使用子查询;4)别名有助于优化器更有效执行查询,提升可读性和可维护性。
-

事务的ACID特性是指原子性、一致性、隔离性和持久性。原子性确保事务中的所有操作全做或全不做;一致性保证数据库从一个一致状态转移到另一个一致状态;隔离性防止多个事务并发执行时相互干扰;持久性确保事务提交后其结果永久保存。事务通过redolog、undolog和锁机制保障数据一致性。RedoLog用于崩溃恢复,UndoLog支持回滚和MVCC,锁机制则控制并发访问,避免脏读、不可重复读和幻读。正确使用事务需合理控制事务边界并选择合适的隔离级别,如READCOMMITTED适合大多数场景,REPEATABLE
-

要设置MySQL性能监控,首先启用慢查询日志,在配置文件中设置slow_query_log、slow_query_log_file和long_query_time;其次使用SHOWSTATUS和SHOWPROCESSLIST实时查看数据库状态;最后引入第三方工具如Prometheus+Grafana或PMM进行可视化监控。核心指标包括:1.查询性能(QPS、慢查询数量、缓冲池命中率);2.资源使用(CPU、内存、磁盘IO);3.连接与线程状态(连接数、Threads_running);4.锁与事务问题(表
-

最佳实践是使用Docker部署Redis时,应注意数据持久化、配置管理、网络配置和性能优化。1.使用Docker命令启动Redis容器:dockerrun--namemy-redis-p6379:6379-dredis。2.配置数据持久化:dockerrun--namemy-redis-p6379:6379-v/path/to/host/data:/data-dredis。3.定制Redis配置:dockerrun--namemy-redis-p6379:6379-v/path/to/host/conf/
-

dump.rdb文件越积越多是因为Redis默认不自动清理旧快照,每次bgsave生成新文件但保留旧文件,需依赖外部脚本按时间戳安全清理。
-
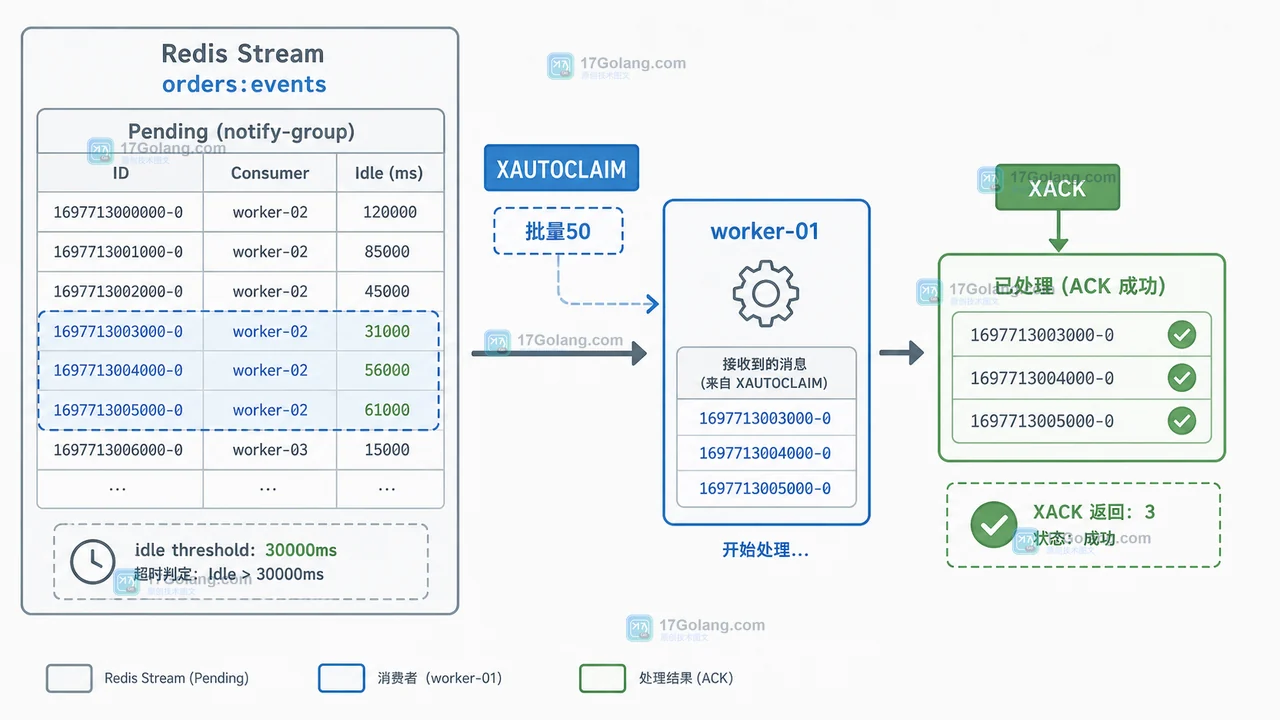
Redis Stream 消费者组出现积压时,先用 XPENDING 区分未分配消息和已分配未确认消息,再按 idle 时间和重试次数决定 XAUTOCLAIM、人工核查还是进入重试队列。本文用可复现的订单事件示例梳理定位、接管与回滚边界。
-
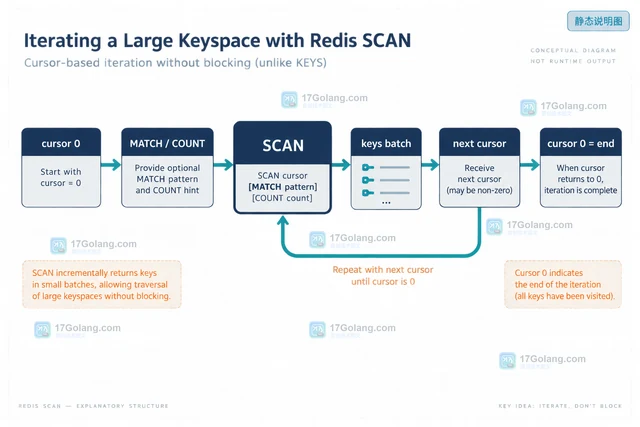
Redis 大 Key 空间不适合直接使用 KEYS *。本文用 SCAN 游标、MATCH、COUNT 和幂等批处理设计一套可控的遍历流程,并说明重复返回、空批次与动态 keyspace 的边界。
-
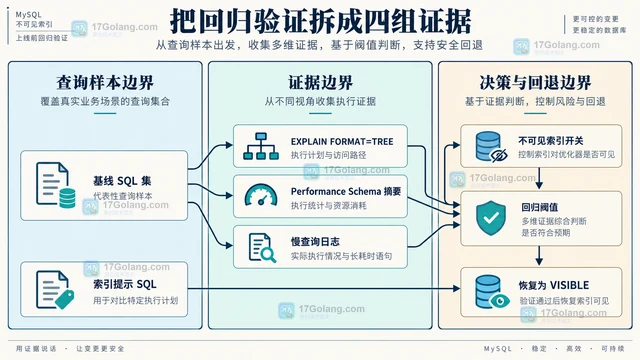
MySQL 不可见索引适合在删除二级索引前做可回退验证:先记录查询计划和工作负载基线,再切换 INVISIBLE,通过 EXPLAIN、Performance Schema 与慢查询日志对比影响,最后按业务阈值恢复可见或进入删除评审。
-
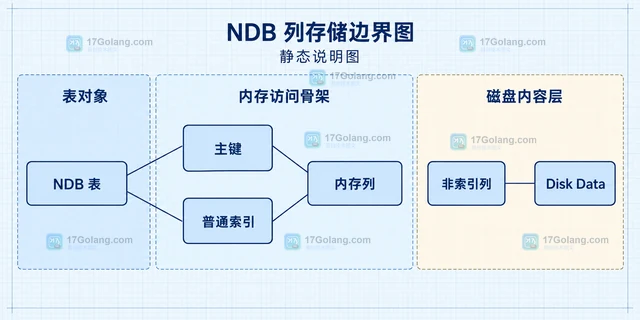
MySQL NDB 的磁盘表并不是把所有列都移出内存:索引和索引列仍需保留在内存,非索引列才适合放入 Disk Data。本文用最小 DDL 说明表级与列级 STORAGE 的划分,以及容量估算时容易忽略的边界。
-
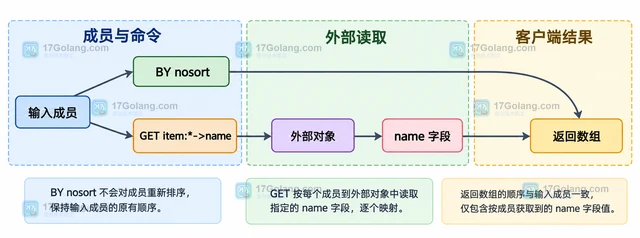
Redis SORT 使用 BY nosort 时不会重新排列成员,而是跳过排序并保留输入数据结构的遍历顺序。本文用 list、set、sorted set 和 GET 外部键说明顺序差异,以及什么时候必须改用真实排序键。
-
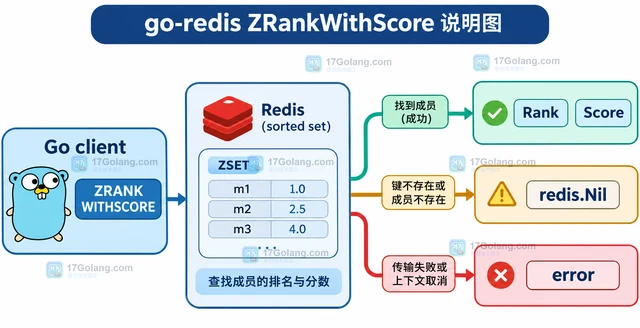
Redis ZRANK 默认只返回有序集合成员的零基排名,追加 WITHSCORE 后可以同时得到排名和分数。本文说明升序排名、同分成员顺序、缺失成员边界,并用 go-redis/v9 的 ZRankWithScore 正确处理 redis.Nil。
