-

--创建测试表
create table te.sc(id int, name varchar(20),class varchar(20), score int);
--给测试表插入数据
insert into te.sc values (1,'张飞','一年一班',100);
insert into te.sc values (2,'刘备','一年一班',99);
insert into te.sc v
-

数据库的备份
#语法:
# mysqldump -h 服务器 -u用户名 -p密码 数据库名 > 备份文件.sql
#示例:
#单库备份
mysqldump -uroot -p123 db1 > db1.sql
mysqldump -uroot -p123 db1 table1 table2 > db1-table1-table2.sql
#多库
-

在实际项目开发中,如果我们对数据库的压力比较大,比如有大批量的查询或者插入等sql,尤其是多线程插入等情况,针对部分执行比较慢的sql,我们可以将其kill掉,常用的一个命令就是sh
-

一、String
String是Redis最基本的类型,最大能存储512MB的数据,String类型是二进制安全的,即可以存储人了数据类型,比如数字、图片、序列化对象等
Ⅰ、set、get、append、strlen、exists
append key value
-

分布式锁应用场景
秒杀环境下:订单服务从库存中心拿到库存数,如果库存总数大于0,则进行库存扣减,并创建订单订单服务负责创建订单库存服务负责扣减库存
模拟用户访问库存
多线程
-

今天,又掉坑了。 之前踩到过MySQL主键溢出的情况,通过prometheus监控起来了,具体见这篇MySQL主键溢出复盘
这次遇到的坑,更加的隐蔽。 是一个log表里面的一个int signed类型的列写满了。快速的
-

获取当前日期的函数
curdate()和current_date()函数的作用相同,将当前日期按照yyyy-mm-dd或yyyymmdd格式的值返回。
mysql> select curdate(), current_date(), curdate() + 0;
+------------+----------------+---------------+
| cur
-
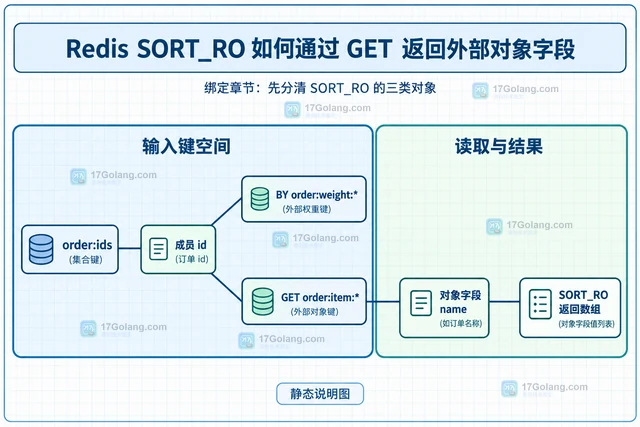
Redis SORT_RO 的 GET 不是再次执行查询,而是按排序结果中的成员替换键名模式,读取外部对象字段。本文用 order:ids、order:item:* 和 order:weight:* 说明 BY、GET、GET #、LIMIT 以及缺失字段的返回边界。
-
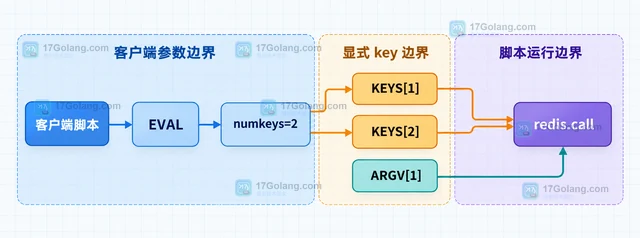
讲清 Redis Cluster 中多 key Lua 的同槽条件:用 hash tag 设计相关 key,正确区分 EVAL 的 KEYS 与 ARGV,并用 CLUSTER KEYSLOT 做发布前检查。
-
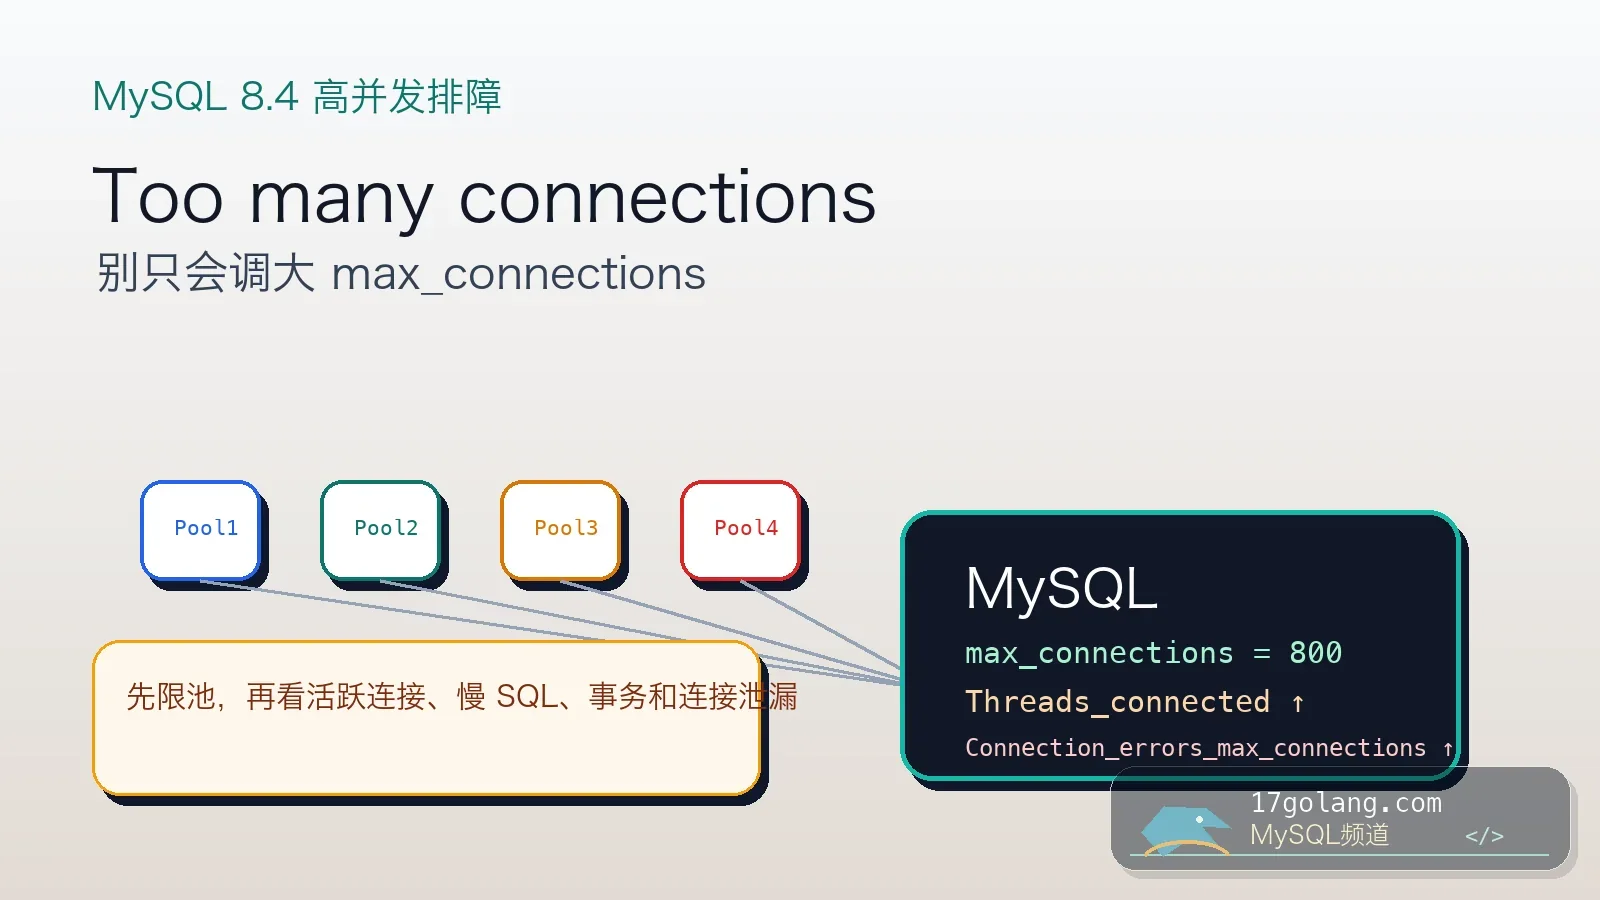
从 MySQL Too many connections 事故入手,讲清 max_connections、Threads_connected、Threads_running、连接池容量预算和上线检查。
-
应使用Redis的Hash或ZSet维护用户会话映射,新登录时先获取并删除旧会话缓存及黑名单,配合事务或Lua脚本保证并发安全,而非仅依赖EXPIRE。
-
Redis发布订阅怕大Key是因为PUBLISH不校验消息大小,大Payload会阻塞单线程主线程,导致延迟飙升、内存积压;应用层需在序列化后截断或拒绝超限消息(如>100KB),订阅端须预检长度并禁用自动解码,大Payload场景应改用SET+key事件、DB查询或Kafka等替代方案。
-

后台线程异步刷新热Key本质是“逻辑过期+守护任务”组合,由应用层实现定期扫描预判并更新热点数据,需嵌逻辑过期时间于value中、合理设扫描频率与范围,并加分布式锁、失败重试及错峰调度。
-

MySQL设置字符集问题的核心在于统一配置,推荐使用utf8mb4。一、安装时在配置文件中设置默认字符集为utf8mb4,并指定排序规则;二、建库建表时显式指定字符集以避免依赖全局设置;三、连接阶段需在程序或命令行中设置字符集一致;四、修复已有数据时先确认编码再导出导入转换。各个环节保持字符集统一可有效解决乱码等问题。
-

在MySQL中创建表的步骤如下:1.使用CREATETABLE语句定义表结构,包含字段名、数据类型和约束。2.设置主键和唯一键,确保数据唯一性。3.选择合适的存储引擎和字符集。4.考虑性能优化,如使用合适的索引和定期维护。通过这些步骤和最佳实践,可以有效提升数据库的性能和可维护性。
